从能力到生活
腾讯开源同传模型 Hy-SimulMT:3 秒接话,和一级同传比怎么样
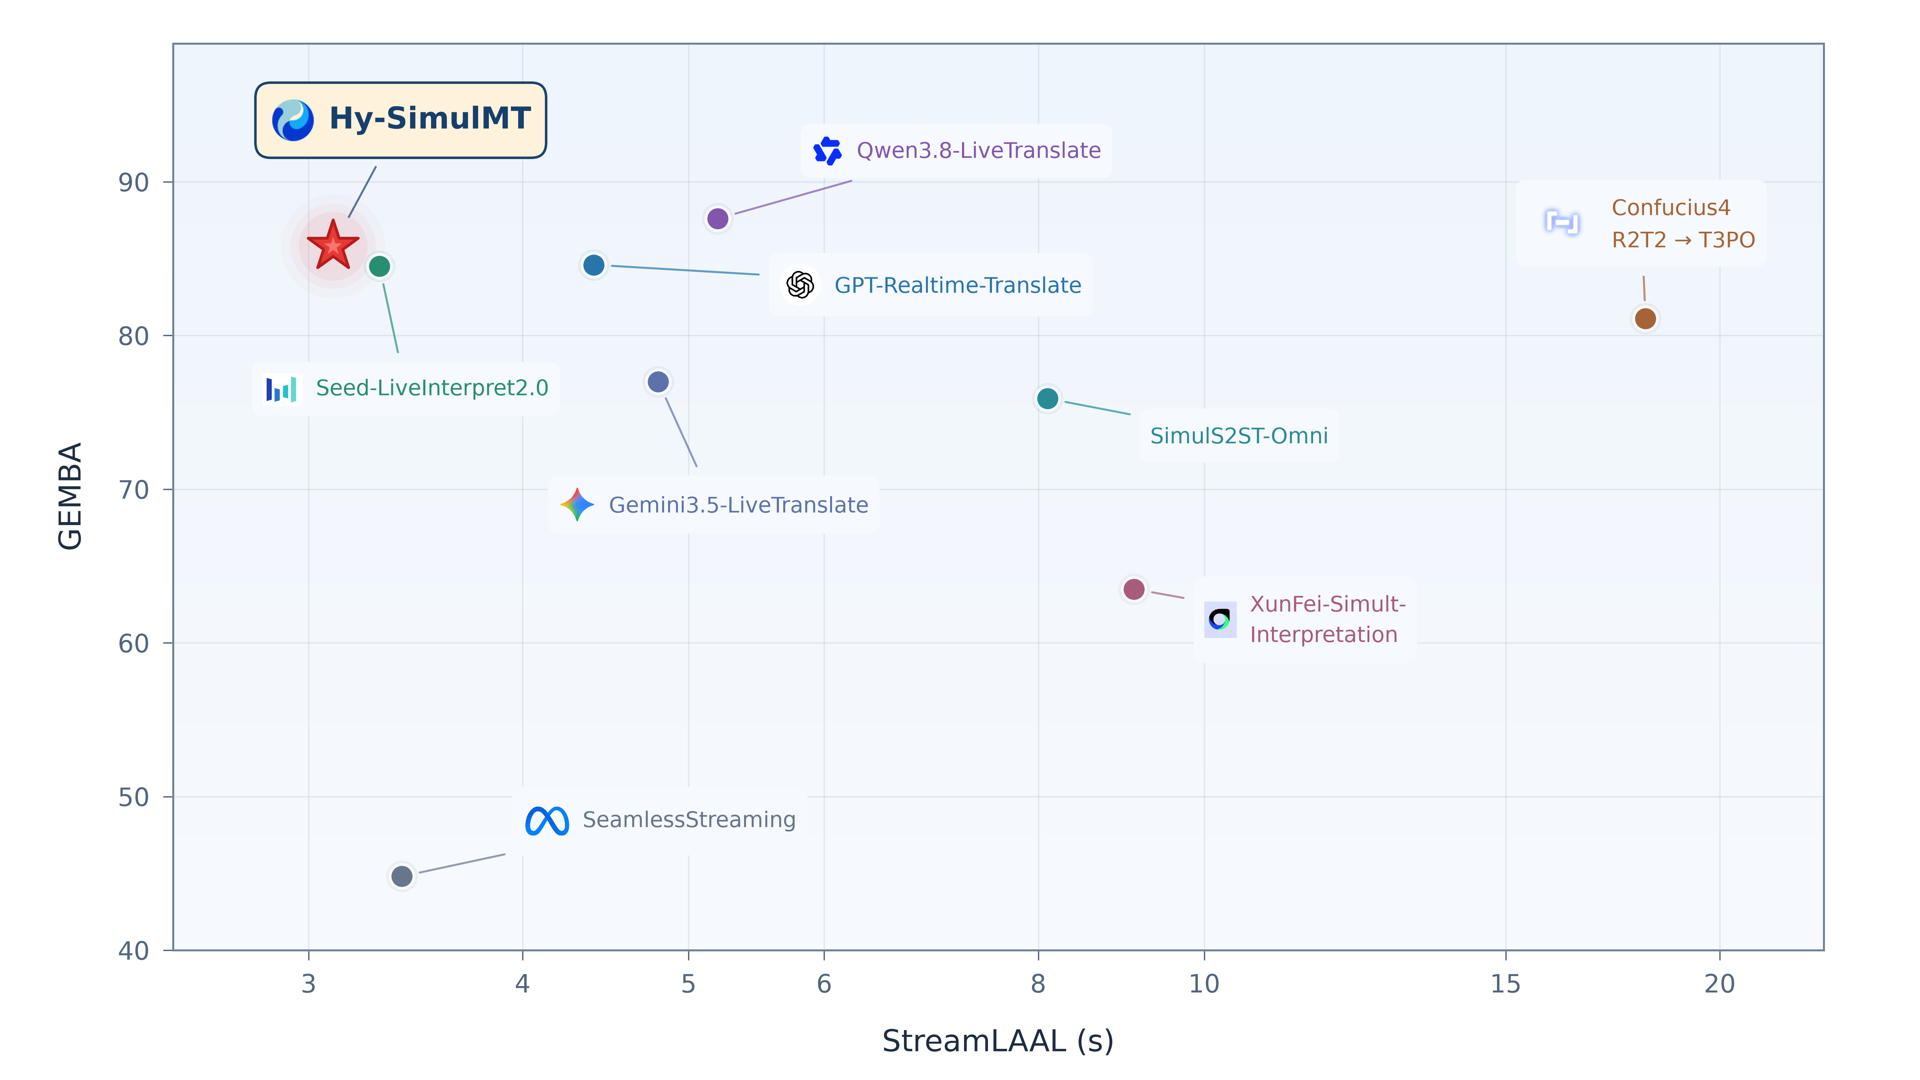
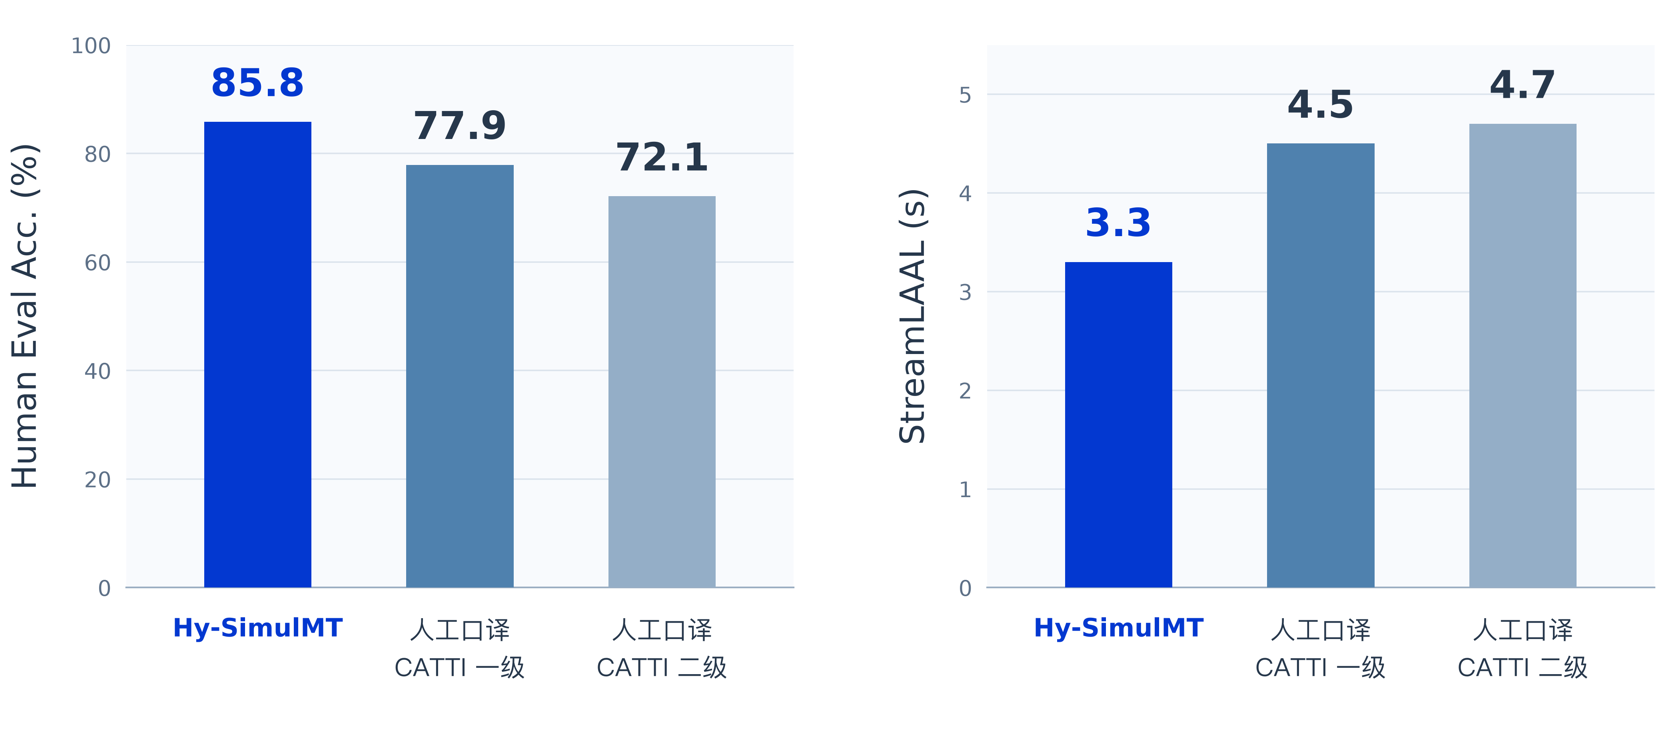
30B 总参数、3B 激活的中英双向语音同传模型按 Apache-2.0 开源:RealSI 长音频上时延约 3 秒为图中最低、质量超过多数商用同传 API;18 段十领域与 CATTI 一级/二级译员对比,85.8% 对 77.9%/72.1%,时延 3.3 秒对 4.5/4.7 秒。普通读者可用 Hy 翻译 App 免费体验,开发者一条命令部署。
本文依据腾讯混元开源仓库、官方模型页与媒体报道整理;文中全部对比数字来自厂商评测(GEMBA 分数由 GPT-6.1-Sol 打分),本站未实测。自行部署需要能装下 30B 模型的 NVIDIA 显卡与另配的语音合成服务;许可为 Apache-2.0,第三方组件保留原条款。
边听边译:3 秒接话是什么概念
同声传译的难处不在“译得对”,而在“来得及”:译员听到的不完整,说出来的时候演讲已经往下走了。10 月 26 日,腾讯混元把同传大模型 Hy-SimulMT 开源:中英双向、语音到语音,边听边出译文,还能实时克隆说话人的音色和语气。IT 之家实测响应约 3 秒;作为参照,人类专业同传译员平均 4–5 秒开口。3 秒意味着在会议、演讲、访谈这些真实场合,字幕和译音能基本跟上讲话人的节奏,而不是等一段话说完。
在官方的 RealSI 长音频对比里,Hy-SimulMT 的位置最靠左上:时延约 3.0 秒是图中最低,质量约 86 分(GEMBA)超过图中除 Qwen3.8-LiveTranslate 外的全部系统——Qwen3.8 质量略高(约 87.5),但时延约 5.2 秒;GPT-Realtime 约 4.3 秒、84.5 分;Gemini3.5-LiveTranslate 约 4.8 秒、77 分;Meta 的 SeamlessStreaming 时延接近但质量约 45 分。厂商结论是“超过多数商用同传 API”——按图读是对的,超过的是多数,不是全部。
来源与延伸阅读
- 腾讯混元 Hy-SimulMT 开源仓库官方仓库 · 10 月 26 日发布,27 日读取核对两个基座与 FP8/GGUF 变体、Apache-2.0 许可说明、RealSI 与短音频四个基准、18 段人类对比、vLLM 部署与 SimulTrain 训练工具。本文 RealSI 散点图与人类对比图取自仓库 assets,人类对比图有中英两个版本。
- IT之家:混元同声传译大模型开源报道媒体报道 · 10 月 26 日核对 Hy 翻译 App 免费体验、实测约 3 秒与人类专业译员平均 4–5 秒、十领域新音频、6 位译员(3 位 CATTI 一级、3 位二级、人类取 3 人最高)、GEMBA 由 GPT6.1-Sol 打分、长音频超多数商用同传 API。
开源包:权重、代码与一条命令
开源内容包括两件事。权重侧是两个基座:Hy-SimulMT-30B-A3B 只输出译文,Interleave 版同时输出原文与译文,各自另有 FP8 和 GGUF 量化版,在 Hugging Face 与 ModelScope 都能下载。30B-A3B 的命名意味着约 300 亿总参数、约 30 亿激活的混合专家结构。代码侧是 SimulInfer 推理服务和 SimulTrain 继续训练工具。许可按仓库说明为 Apache-2.0(第三方组件保留原条款)——对商用部署是友好得多的条款,不同于许多“仅限研究”的开放权重。
部署路径也写得很实:Linux、Python 3.12+、装得下 30B 模型的 NVIDIA 显卡,vLLM 0.31 起支持其 HYV3ForCausalLM 结构,官方给了一条 deploy.sh 命令——起来之后 8080 端口是带上传与 WebSocket 的网页界面,8800 是模型接口,多卡可用张量并行;GGUF 版有 llama.cpp 桥接,但上游尚未合并。两个边界要如实交代:语音输出与音色克隆依赖另行配置的 TTS 服务,模型本体只出文字;想在自己的领域上继续训练,SimulTrain 从已下载的检查点接着练。
来源与延伸阅读
- 腾讯混元 Hy-SimulMT 开源仓库官方仓库 · 10 月 26 日发布,27 日读取核对两个基座与 FP8/GGUF 变体、Apache-2.0 许可说明、RealSI 与短音频四个基准、18 段人类对比、vLLM 部署与 SimulTrain 训练工具。本文 RealSI 散点图与人类对比图取自仓库 assets,人类对比图有中英两个版本。
- Hugging Face 模型合集权重下载入口tencent/Hy-SimulMT-30B-A3B 与 Interleave 版本的下载入口;另有 ModelScope 合集。
数字怎么读:三张口径,一个评分员
这套评测有三个层次。最直观的是与人类同传的对比:18 段、每段约 6 分钟的新录音,覆盖 AI 软件、医学、制造能源、自然科学、农业食品、商务管理、法律、教育、文化文旅、体育生活十个领域;对照 6 位职业译员——3 位 CATTI 一级口译、3 位二级——人类一侧取 3 人最高分。结果是 Hy-SimulMT 人工评分准确率 85.8%,对一级 77.9%、二级 72.1%;时延 3.3 秒对 4.5/4.7 秒。质量持平或超过最高一组人类,接话还更快。
第二层是短音频四个基准,胜负互见,如实保留:FLEURS 90.3(Gemini 92.4 更高)、CoVoST2 75.5(Qwen 82.1 明显更高)、ACL6060 81.2(Gemini 82.6 略高)、RealSI-Sentence 84.7 为全场最高。第三层是评分员本身:GEMBA 分数由 GPT-6.1-Sol 打分——也就是说,这套“超过人类”的结论,是 OpenAI 的模型在给腾讯的模型和人类译员打分。LLM 评分与人工评分并不总一致;厂商评测的惯例在这里同样适用:数字提供参照,不等于本站实测,也不等于你的会议一定这个效果。
| 测试集 | Hy-SimulMT | 最高对照 |
|---|---|---|
| FLEURS | 90.3 | Gemini3.5-LiveTranslate 92.4 |
| CoVoST2 | 75.5 | Qwen3.8-LiveTranslate 82.1 |
| ACL6060 | 81.2 | Gemini3.5-LiveTranslate 82.6 |
| RealSI-Sentence | 84.7(全场最高) | Qwen3.8-LiveTranslate,低于 84.7 |
来源与延伸阅读
- 腾讯混元 Hy-SimulMT 开源仓库官方仓库 · 10 月 26 日发布,27 日读取核对两个基座与 FP8/GGUF 变体、Apache-2.0 许可说明、RealSI 与短音频四个基准、18 段人类对比、vLLM 部署与 SimulTrain 训练工具。本文 RealSI 散点图与人类对比图取自仓库 assets,人类对比图有中英两个版本。
- IT之家:混元同声传译大模型开源报道媒体报道 · 10 月 26 日核对 Hy 翻译 App 免费体验、实测约 3 秒与人类专业译员平均 4–5 秒、十领域新音频、6 位译员(3 位 CATTI 一级、3 位二级、人类取 3 人最高)、GEMBA 由 GPT6.1-Sol 打分、长音频超多数商用同传 API。
从显存到手机:两条使用路径
普通读者的入口最简单:腾讯 Hy 翻译 App(安卓/iOS)已上线免费体验,不碰命令行。开发者的入口是仓库:一条 deploy.sh 拉起本地服务,网页界面上传音频或走 WebSocket 实时流;对会议工具、字幕组、线上活动来说,这就是“同传能力搬回自己服务器”的起点。中间还有一层值得注意——Apache-2.0 允许商用,意味着创业团队可以把它接进自己的产品,而不是只能调别人的 API。
和本站此前记录的语音能力放在一起看,分工更清楚:MAI 的实时转写解决“先听清说了什么”,Grok 转写 2.0 管“转写少错词”,Dessa 让对话“边说边听”;Hy-SimulMT 补上的是“边听边译”——同传不是把这三件事接起来那么简单,但对使用者来说,跨语言的会议、课程和访谈第一次有了可以自己部署、也可以装在手机里的选项。尚待验证的也留在这里:真实会议的嘈杂环境、专业术语密度和长时间稳定性,厂商评测没有覆盖,本站也未实测。
来源与延伸阅读
- 腾讯混元 Hy-SimulMT 开源仓库官方仓库 · 10 月 26 日发布,27 日读取核对两个基座与 FP8/GGUF 变体、Apache-2.0 许可说明、RealSI 与短音频四个基准、18 段人类对比、vLLM 部署与 SimulTrain 训练工具。本文 RealSI 散点图与人类对比图取自仓库 assets,人类对比图有中英两个版本。
- IT之家:混元同声传译大模型开源报道媒体报道 · 10 月 26 日核对 Hy 翻译 App 免费体验、实测约 3 秒与人类专业译员平均 4–5 秒、十领域新音频、6 位译员(3 位 CATTI 一级、3 位二级、人类取 3 人最高)、GEMBA 由 GPT6.1-Sol 打分、长音频超多数商用同传 API。