模型与接入 · 本地编程的新选择
Flint:让编程代理在笔记本上工作,要看哪些条件?
Recursive 开放了 398 亿参数的编程模型与本地引擎。它让代码留在自己的设备上有了新选择,但短上下文的生成速度、长任务的成功率和整台机器的门槛,需要分开读。
Recursive在10月21日公开Flint与本地引擎。rec当前支持M4 Pro、M5 Pro或M5 Max,要求至少48GB统一内存、约30GB磁盘;其他运行入口与精度配方分别核对。下文采用厂商结果,本站没有安装引擎或运行编程任务。
代码留在自己的机器上,模型还需要哪些搭档
Recursive 把 Flint 定位为本地编程代理的模型:读仓库、找错误、实现功能、写测试。它提供文字推理和多轮工具调用,398 亿总参数中,每次生成激活约 25 亿参数。激活量说明每步计算选择了一部分专家,不表示只需存放 25 亿参数,也不等于模型已经替你完成了一个工程。
这次同时公开的 rec 承担本地推理,Pi 或 OpenCode 等编程工具负责给模型接上文件与命令。模型、引擎和工具分工后,代码可以在本机处理;是否真正不向外发送数据,还要看所接工具、网络请求和具体配置。对有本地需求的人,这是一个可进一步检验的选择,而不是所有笔记本上的即开即用助手。
来源与延伸阅读
- Recursive:Flint 正式介绍厂商原文 · 10 月 21 日模型用途、速度图、评测设置,以及 Eureka Machine 在研发中的角色。
- Flint 模型卡与完整评测图官方模型卡 · 固定版本398 亿总参数、约 25 亿激活,文本输入输出;262144-token 配置、BF16 部署与评测限制。
- rec:支持的机器与单会话条件官方原仓 README · 固定提交M4 Pro / M5 Pro / M5 Max、至少 48GB 统一内存、约 30GB 磁盘;与模型能力分别理解。
- 运行入口与编程工具连接官方接入文档按具体权重、运行时和机器选择入口;本文没有执行安装脚本。
先看做了哪套题,再看分数
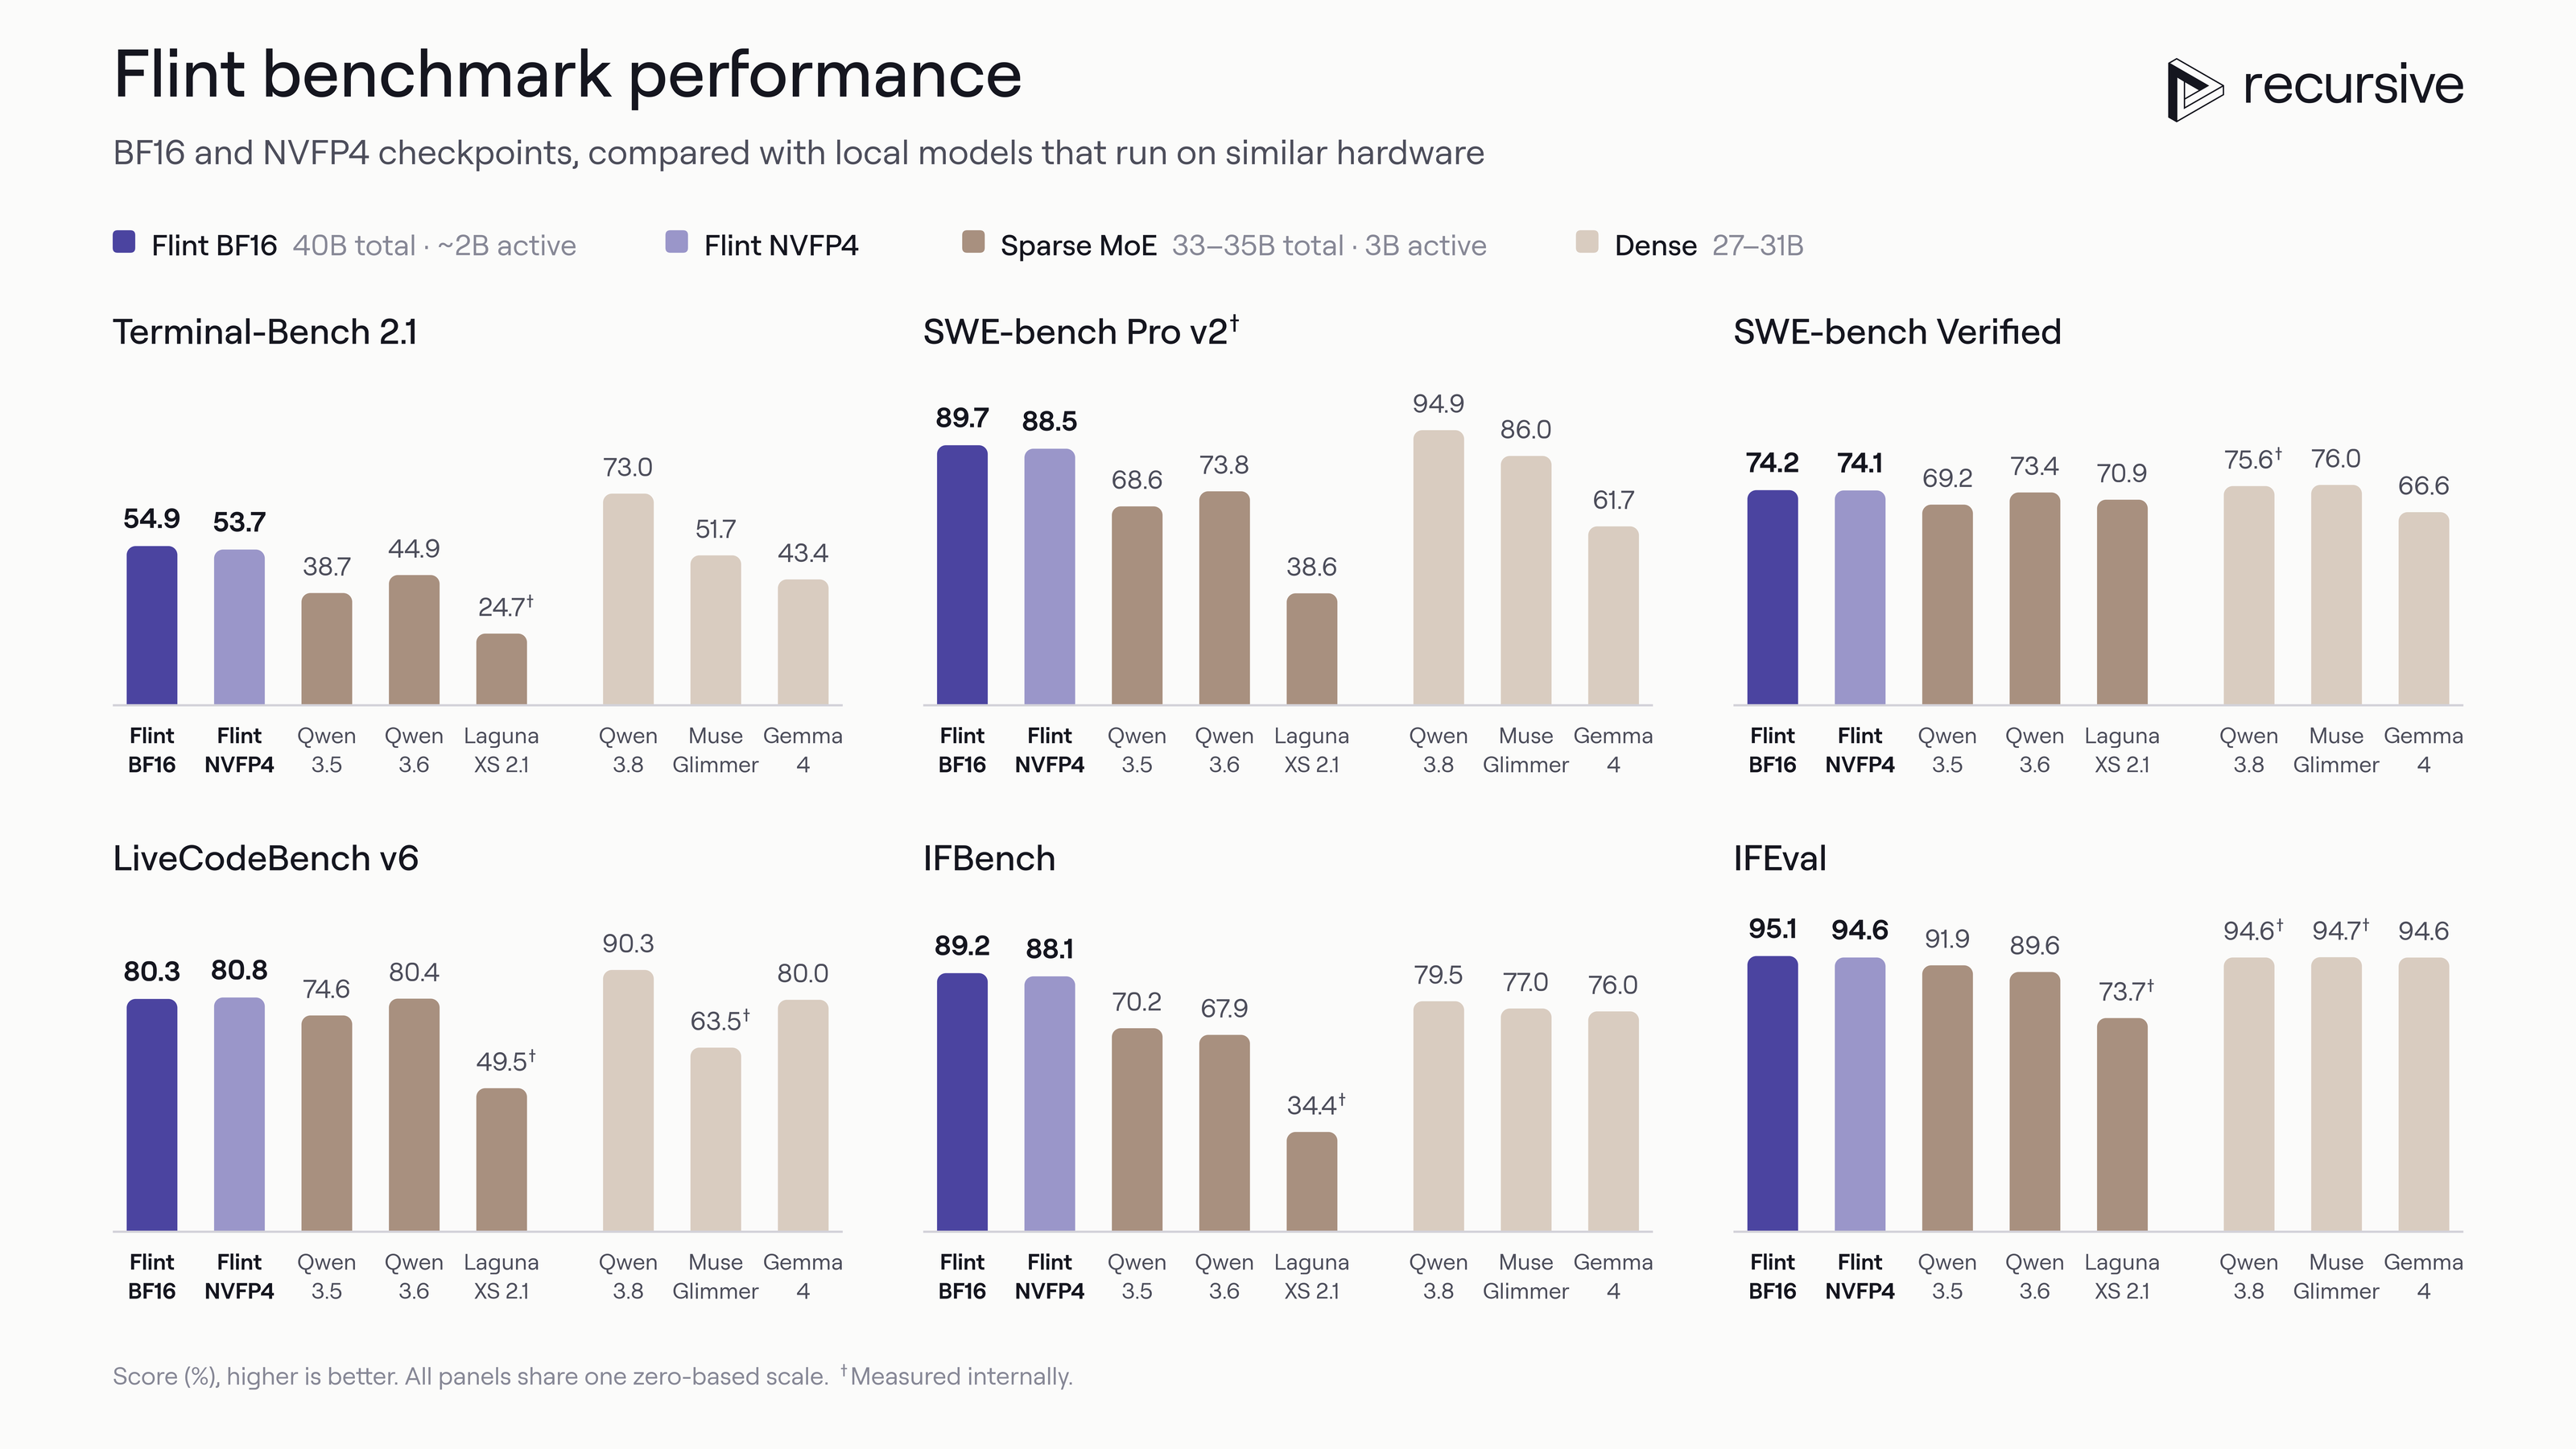
厂商报告的 BF16 结果是 Terminal-Bench 2.1 54.9%、SWE-bench Pro v2 89.7%、SWE-bench Verified 74.2%。它们分别反映规定终端任务与代码修复测试中的表现,不是 89.7% 的现实工程都能交给它。原图也能看到,较大的稠密模型在若干项目仍更高;“同类中领先”带着模型规模和测试选择的前提。
Flint 的代理测试至少每题五次尝试,报告平均 pass@1,允许最长五小时。Terminal-Bench 用 Terminus 2、可联网,但通过检索取得解法的结果被判为失败;SWE-bench 用 mini-swe-agent、不联网。图里的其他模型不全由同一团队复做。因此它尚不能进入本站现有 AA 综合榜、Pi/high 小样本榜或物理续视频榜:测试版本、工具和任务不同,没有同口径成绩。
来源与延伸阅读
- Recursive:Flint 正式介绍厂商原文 · 10 月 21 日模型用途、速度图、评测设置,以及 Eureka Machine 在研发中的角色。
- Flint 模型卡与完整评测图官方模型卡 · 固定版本398 亿总参数、约 25 亿激活,文本输入输出;262144-token 配置、BF16 部署与评测限制。
每秒生成得快,不等于整项任务都快
原速度表把 M4 Pro 的 48GiB 机器单独列出:Flint 的 MLX 路径在 1K 输入时为 131.22 token/s,沿输入增长至 128K 的归一化均速是 68.89;同模型的 llama.cpp 路径分别为 87.98 和 47.58。短提示的峰值不能延伸到长仓库,也没有计算读入提示、工具执行、测试和重试。看自己的工作时,等待多久交齐结果,比只看输出跳得多快更有用。
rec 的固定说明支持 M4 Pro、M5 Pro 或 M5 Max,要求至少 48GB 统一内存和约 30GB 空闲磁盘,当前优化目标是单会话。Ollama 的约 23GB 分发文件与原 BF16 的约 80GB 下载,是不同配方,不是彼此矛盾的整机内存要求。发布文章说最高 512k、建议不超过 256k;本文核对的固定模型卡与配置写 262144 token,且输入输出共用。实际接入应按所下载的版本和运行时设置核对,不能只拿宣传最大值预留输入。
来源与延伸阅读
- Recursive:Flint 正式介绍厂商原文 · 10 月 21 日模型用途、速度图、评测设置,以及 Eureka Machine 在研发中的角色。
- Flint 模型卡与完整评测图官方模型卡 · 固定版本398 亿总参数、约 25 亿激活,文本输入输出;262144-token 配置、BF16 部署与评测限制。
- rec:支持的机器与单会话条件官方原仓 README · 固定提交M4 Pro / M5 Pro / M5 Max、至少 48GB 统一内存、约 30GB 磁盘;与模型能力分别理解。
- 固定权重配置中的上下文官方配置文件max_position_embeddings 为 262144;输入与生成共用窗口。
- Ollama 的 Flint 分发入口运行平台原页面当前 latest/40b 显示约 23GB 文件、256K 窗口;文件大小不是整机运行内存。
自动化研究值得追踪,日常交办仍看一个完整结果
Flint 还有一条值得跟进的线:Recursive 称自己的 Eureka Machine 参与了模型结构、量化、内核、数据与训练配方的探索。原文具体描述了从 350 亿总量、30 亿激活的基线搜索到当前结构,以及用 16-bit 模型作老师修复量化损失。它说明团队怎样把研究自动化接到本地速度上;“不到四个月从头构建”和效果归因仍是厂商陈述,没有证明研发全程无人参与。
如果已有合适的机器,先用一个知道验收方式的小任务理解这种取舍:例如找一个已能复现的错误,只要求修复它并跑过相关测试。保留它读了什么、改了什么、失败后怎样调整,以及交齐结果花了多久;再与自己熟悉的工具对照。这个建议不是本站已完成的实测。Flint 真正值得继续看的,是能否让一部分编程工作在本地稳定做完,以及为此需要多少人工指导。
来源与延伸阅读
- Recursive:Flint 正式介绍厂商原文 · 10 月 21 日模型用途、速度图、评测设置,以及 Eureka Machine 在研发中的角色。
- Flint 模型卡与完整评测图官方模型卡 · 固定版本398 亿总参数、约 25 亿激活,文本输入输出;262144-token 配置、BF16 部署与评测限制。
- rec:支持的机器与单会话条件官方原仓 README · 固定提交M4 Pro / M5 Pro / M5 Max、至少 48GB 统一内存、约 30GB 磁盘;与模型能力分别理解。