持续专题 · 2026年10月13日整理
Meta 的模型:从 FAIR、Llama 到 Wonder
Wonder Full 进入当前前沿综合能力的竞争区间。沿 Meta 十余年的研究、开放模型、团队转折和负责人原访谈,理解这次变化怎样接到作品、工具与生活。
01这个专题关心的现象EN
Wonder 让我们重新看 Meta 的位置
10 月 12 日,Meta 发布 Muse Wonder 和 Wonder Full。今天值得注意的变化是:Meta 已经有模型进入当前前沿综合能力的竞争区间。10 月 13 日回读 Artificial Analysis v4.3.2,Full 的 max 档为 56,与 Sonnet 5.5 的最高已测档位同分,接近 Opus 5.5 的 58。Full 与这些模型在同一把尺子下相邻,足以让人把 Meta 放进第一梯队来认真比较。这里的第一梯队是本站对这组文字综合评测位置的判断,具体中文、视觉、长任务与费用继续分别看。
把这一变化放回历史,故事就更完整了。Meta 从 2013 年的 FAIR 研究团队出发,参与建立训练工具和开放研究的基础;Llama 把模型权重送到开发者手里;2025 年重组又把前沿模型、人才、算力和产品放到更集中的目标下。2026 年的 Spark、Muse Code、个人 Muse 与 Wonder,逐渐让这条路线从研究成果接到持续工作的工具和日常入口。各阶段有自己的成果和困难,今天的成绩让人有理由重新评估整个过程。
这个专题沿三条线展开:模型怎样演进、关键人物怎样作选择、这些能力怎样进入作品与产品。官方发布说明设计与开放范围,独立机构提供可比参照,访谈解释当事人的思路,开发者作品呈现实际接入。基础材料核对到 2026 年 10 月 13 日;下文历史日期指原事件,左侧更新时间指本站实际公开整理,后续补充仍沿同一个专题继续。
来源与补充
- Meta · Muse Wonder 发布 ↗官方发布 · 2026-10-12两个型号、记忆与长任务方向、公开作品及开放范围。
- Artificial Analysis 综合榜 ↗独立评测 · 2026-10-13 回读同一 v4.3.2 指数与各型号已测配置;不与历史版本分数混算。
02历史总览EN
十余年里,Meta 怎样从研究走到前沿产品?
可以先把这段历史看成四个相连的阶段。第一阶段建立研究与工具基础,第二阶段把大型语言模型开放给研究者和开发者,第三阶段在模型竞争与组织选择中重新集中投入,第四阶段让模型和执行环境一起服务更长的任务。这个分期是本站为了理解材料作的梳理,不是 Meta 的官方年代划分。
各节点都链接支持该事件的原始材料,包括当时发布、本人履历与后续回顾;再往下的章节解释它为什么改变了路线。不同年份的榜单、参数和任务不能简单相加,旧版分数也不能直接拿来证明今天的名次。更有价值的纵向变化是:谁能得到模型,模型能处理什么,开发者怎样把结果带给人,以及公司接下来把资源放到哪里。
- · FAIR 起步,建立长期 AI 研究团队
- · 公开 Torch 深度学习模块,分享训练工具
- · PyTorch 初次公开,研究框架逐渐形成生态
- · OPT-175B:开放研究模型与训练记录
- · LLaMA:更小模型与研究开放
- · Llama 2:扩大商用与开发者接入
- · Llama 3:模型与 Meta AI 产品一同向前
- · Llama 3.1:405B、多语言与更长上下文
- · Llama 3.2:视觉与端侧小模型分支
- · Llama 3.3:70B 文字型号继续迭代
- · Llama 4:原生多模态与专家混合架构
- · 公司财报说明 MSL 的范围与关键分工
- · Muse Spark:重建模型路线的首版
- · Muse Wonder / Full:走进前沿能力竞争区间
032013—2016 · 研究起点EN
先有长期研究,才有今天的助手
2013 年底,Facebook 建立 FAIR,Yann LeCun 在当年 12 月加入。扎克伯格亲赴学术大会招募研究者,希望实验室长期探索图像、语言、记忆和预测等智能问题。当时,这项工作的主要形态还不是今天熟悉的聊天助手。
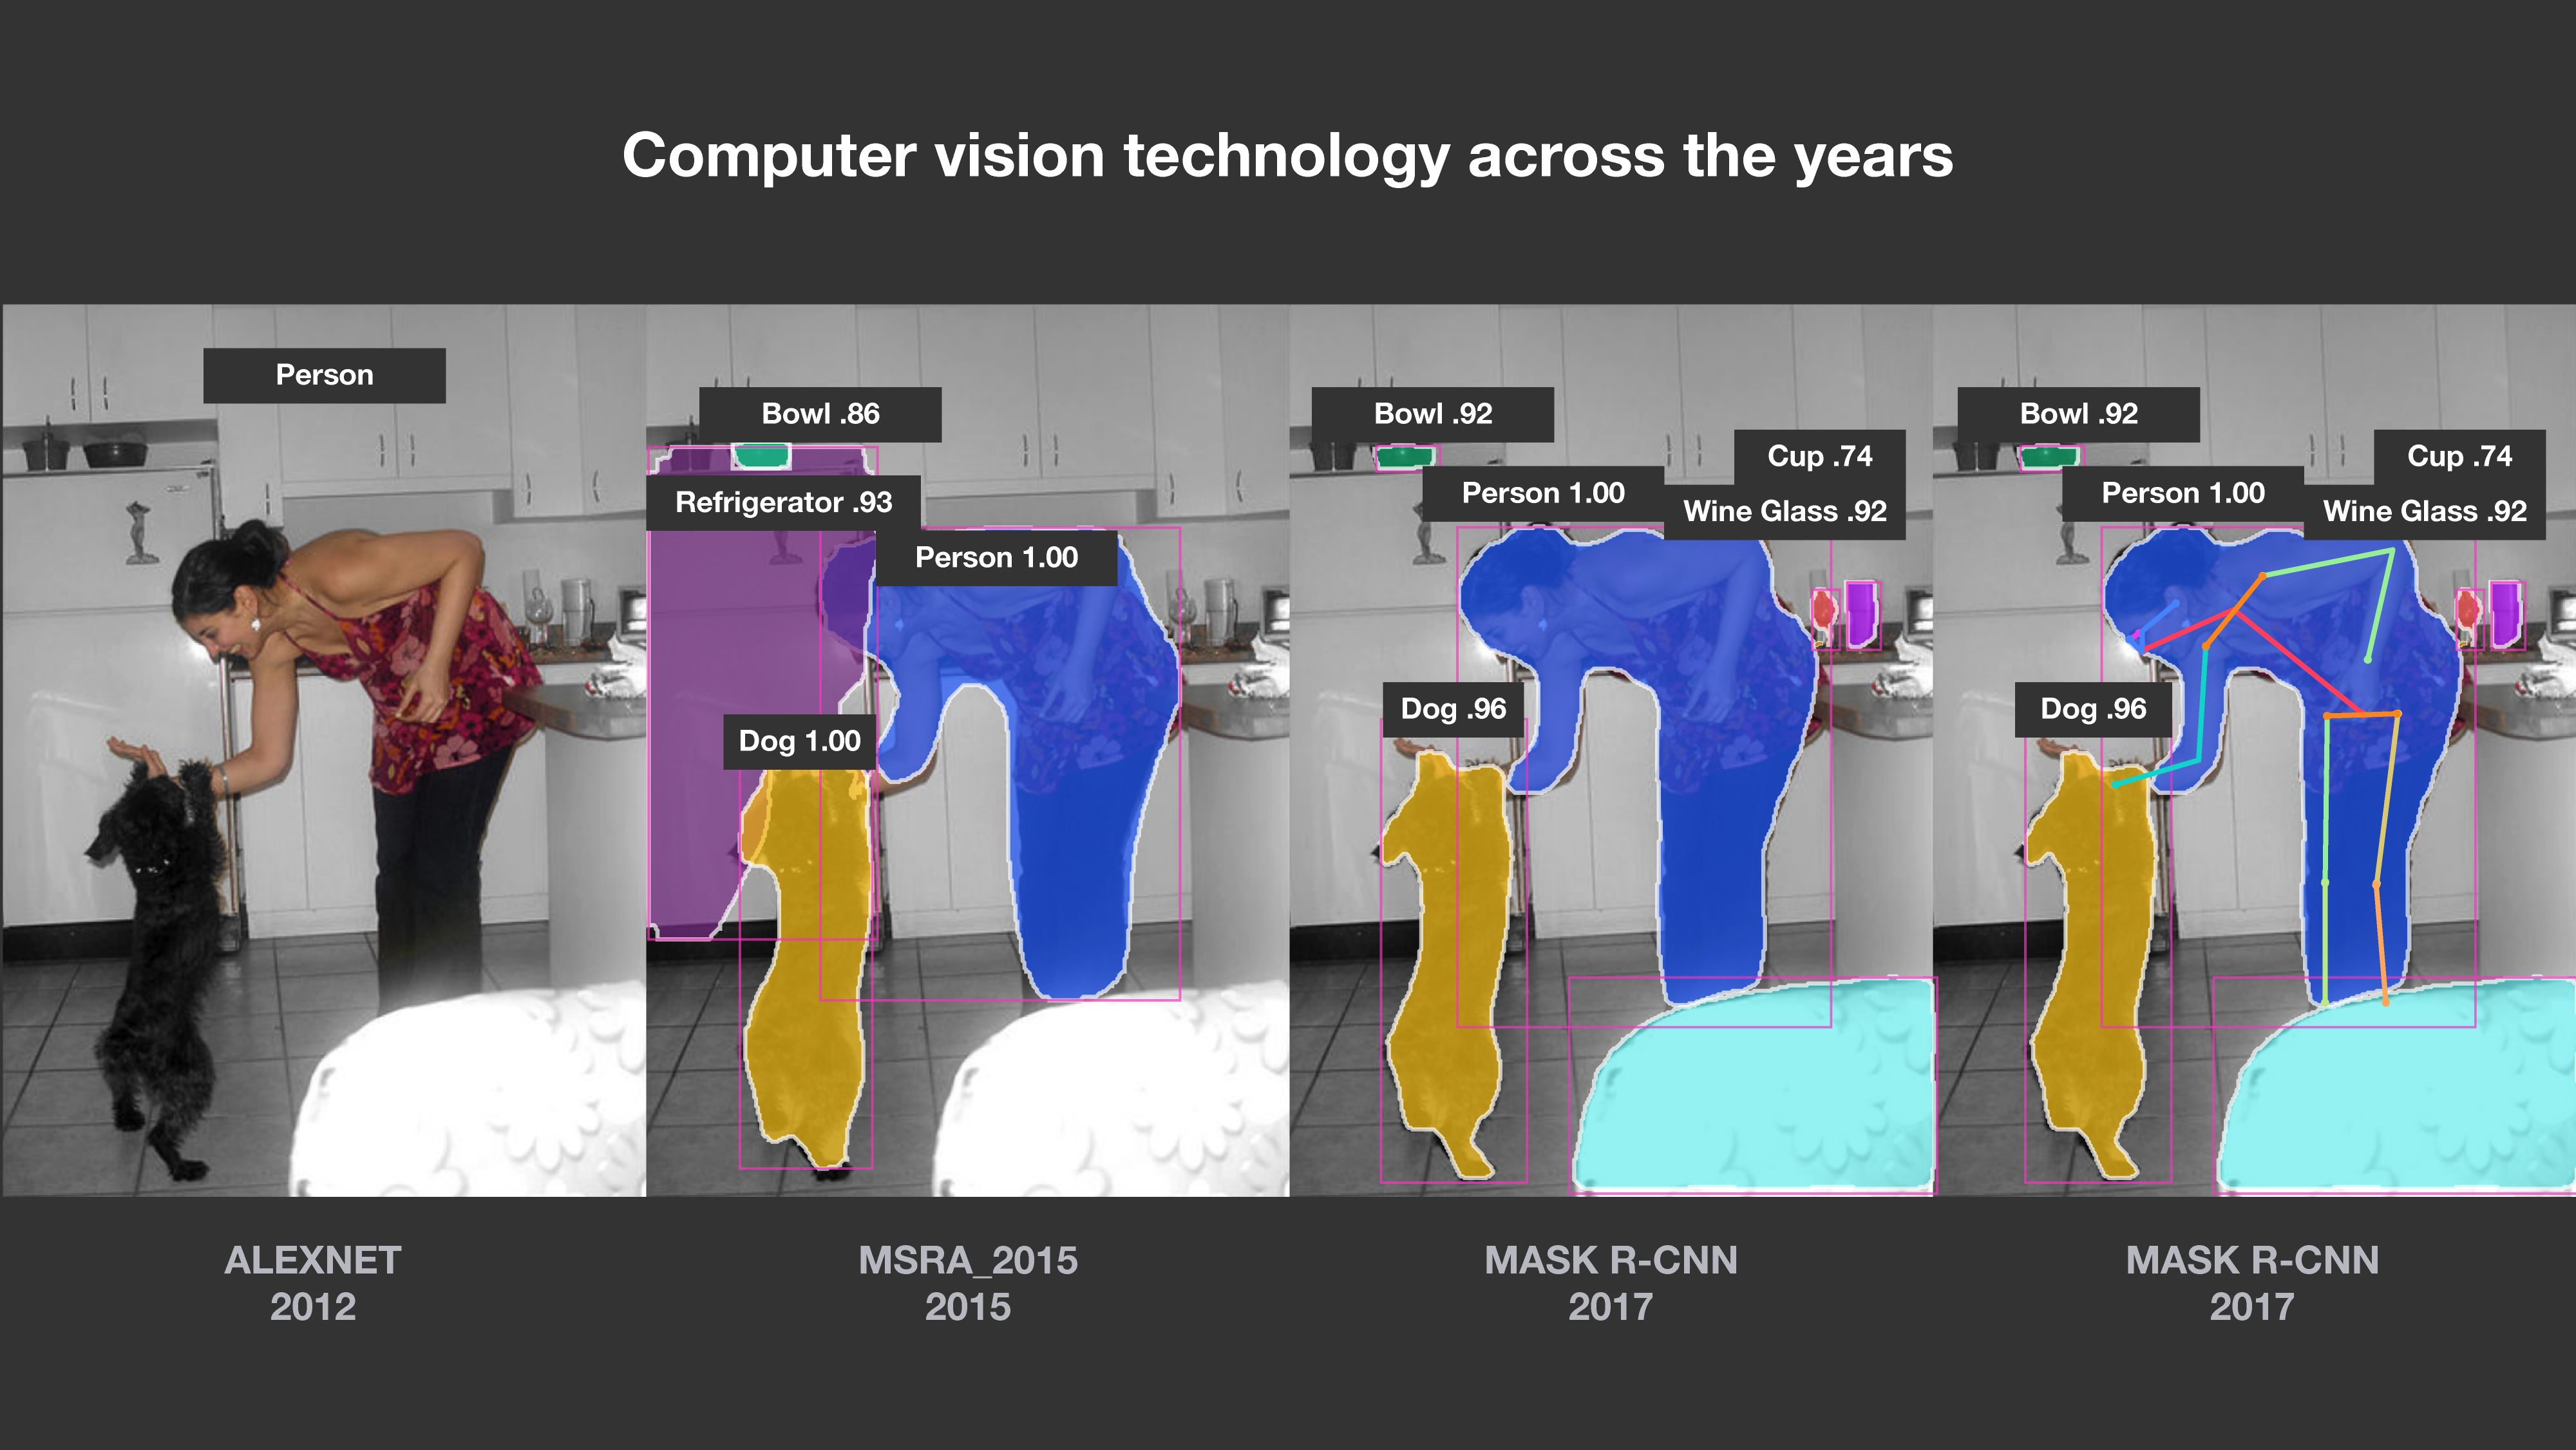
研究很早就进入服务。2016 年的自动替代文字,让屏幕阅读器从只读出‘照片’,变成描述照片里可能出现的人、物体和场景。首发面向英语 iOS 屏幕阅读器,视觉识别由此帮助看不见照片的人参与朋友的交流。
FAIR 的 2014 年记忆网络实验,则根据提供的《指环王》摘要回答人物与物品最后在哪里。这是有限任务,但已在问一个至今重要的问题:系统怎样利用当前材料和前文,而不只依赖训练时学到的知识。
从这里回看 Wonder,本站把它放在持续积累中理解:特定能力先进入功能,助手再组织更多能力。早期研究与今日产品有共同问题,但并不是同一个模型从 2013 年一路升级;研究、模型和产品需要分别辨认。
来源与补充
- Meta:FAIR 十周年回顾 ↗官方回顾 · 2023 年 11 月 30 日研究团队在 2013 年底建立,扎克伯格参与招募;这是历史回顾的发表日。
- Meta:FAIR 五周年与记忆网络 ↗官方研究回顾 · 2018 年 12 月 5 日2014 年记忆网络的情节问答样本,以及基础研究与应用团队的关系。
- Facebook:自动替代文字 ↗官方产品发布 · 2016 年 4 月 4 日从照片识别到屏幕阅读器的具体功能,首发平台与语言范围。
- Meta:Yann LeCun 人物页 ↗官方历史履历支持 2013 年 12 月加入的历史事实;现职另按本专题人物章节核对。
042015—2023 · 工具与开放研究EN
公开的,不只是一个能回答问题的模型
2015 年,FAIR 开放为 Torch 优化的深度学习模块,让别人也能更快训练网络;这不等于 Meta 发明了 Torch。2017 年 1 月公开的 PyTorch,则是供人实验、调试和部署模型的框架,不是另一款聊天模型。
共用实现让研究者接着做实验,也让开发者把结果放进软件。2022 年 9 月,PyTorch 转入 Linux Foundation 旗下的独立基金会,Meta 继续投入,多方参与治理。它从内部研究工具,成长为更广泛的共同基础。
模型也有具体分工:2022 年 7 月的 NLLB-200 关注 200 种语言翻译与低资源语言;2023 年 4 月的 Segment Anything 根据点或框等提示选出图像区域。翻译文章、选中照片里的物体,都能成为实际用途。
Meta 的影响有时来自自己提供功能,有时来自别人拿走工具与模型再创造。本站据此理解其开放生态:价值通过许多参与者扩散,不会全体现在一个助手的排名里。不同项目公开的代码、权重、数据和使用条件,仍各不相同。
来源与补充
- FAIR:开放 Torch 优化模块 ↗官方工具发布 · 2015 年 1 月 16 日GPU、卷积与多卡等实现开放,目标是加快研究实验。
- PyTorch 团队:公开发布一周年 ↗项目原文 · 2018 年 1 月 19 日原文写当天是公开发布一周年;据此确认 2017 年 1 月的公开发布。
- Meta:成立 PyTorch Foundation ↗官方公告 · 2022 年 9 月 12 日独立基金会、共同治理,以及 Meta 继续投入的安排。
- Meta:NLLB-200 翻译模型 ↗官方发布 · 2022 年 7 月 6 日200 种语言翻译与低资源语言范围;不借作通用模型成绩。
- Meta:Segment Anything ↗官方研究发布 · 2023 年 4 月 5 日SAM、SA-1B 数据与提示式图像分割,说明视觉模型的具体任务。
052022 · 大型语言模型的研究开放EN
把大模型交给研究者,也看见它的边界
2022 年 5 月,Meta 发布 OPT 系列,并公开训练代码和逐日日志。通过 API 得到回答,不等于能够研究权重。OPT 让研究者比较模型规模,也看见大型训练里的硬件、稳定性和人工处理问题,把过程带进了公开讨论。
OPT-175B 当时采用非商用许可,面向学术、政府、公民社会与产业研究实验室提供访问。它不是面向所有人的成品助手;交出权重也不包含托管、产品接入和维护。开放了哪一部分,决定别人可以怎样继续。
同年 11 月,Meta AI 的 Papers with Code 团队发布 Galactica,探索科学引用、公式与问答。原卡说明它未做通用指令微调,需要合适提示;权重采用非商用许可,也不同于代码仓库的 Apache 许可。
Galactica 原卡明确承认,优质学术语料仍不能消除幻觉,引用预测也不保证真实。写得像科学文献,与可靠组织科学知识,并非同一能力。本站把它作为模型、展示与信任之间的早期提醒,而不只用演示成败概括。
来源与补充
- Meta:OPT-175B 的发布与开放方式 ↗官方发布 · 2022 年 5 月 3 日规模、训练日志、研究访问与非商用范围。
- OPT 原论文 ↗研究论文 · 2022 年 5 月 2 日初稿论文把 API 访问与研究权重区分,并描述系列模型与训练日志。
- Meta:Galactica 原模型卡 ↗原模型说明 · 2022 年 11 月发布科学任务、训练材料、非商用权重许可与引用幻觉限制。
- Papers with Code:Galactica 代码与模型许可 ↗作者原仓库未做指令微调的提示方式,以及代码与模型的不同许可文件。
062023 · LLaMA 与 Llama 2EN
从研究权重,走向能被接入产品的 Llama
2023 年 2 月 24 日,LLaMA 发布 7B、13B、33B、65B。Meta 用更多材料提升较小模型,让资源较少的人也能研究。它仍是基础模型,权重按申请提供、以非商用研究为主,并非今天的 Meta AI 或 Muse 应用。
7 月 18 日,Llama 2 把预训练与对话模型的权重、起步代码扩展到商用,Azure、AWS 与 Hugging Face 等参与分发。开发者可选择托管、微调或自部署,不必从头训练同等规模的基础模型,再围绕需要做成软件。
商用仍遵循定制 Community License、使用政策及特定规模下的额外许可条件。这里称它为可获得权重的开放路线,说明为什么能吸引开发者,同时不把代码、训练数据和每一代使用条件都说成完全开放。
9 月,Meta AI 助手以 beta 进入 WhatsApp、Messenger 和 Instagram,初期面向美国。它使用基于 Llama 2 技术与新研究的定制模型,还接入搜索和图像工具:Llama 提供能力,助手进一步组织对话、工具与社交场景。
来源与补充
- Meta:第一代 LLaMA ↗官方发布 · 2023 年 2 月 24 日模型规模、较小模型的研究思路、申请制与非商用许可。
- Meta 与 Microsoft:Llama 2 ↗官方发布 · 2023 年 7 月 18 日权重、预训练与对话型号,以及商用和合作分发。
- Llama 2 Community License ↗原许可文件用途与额外商用条件;不是将许可条款当作模型性能。
- Meta:助手进入应用与设备 ↗官方发布 · 2023 年 9 月 27 日Meta AI beta、定制模型、搜索与图像工具,以及初期美国范围。
072024 年 4—7 月 · 模型与系统EN
405B,让开放权重也争取头部位置
2024 年 4 月 18 日,Llama 3 先提供 8B、70B 文本模型,上下文为 8K。Meta 扩大并筛选训练材料、改进指令微调,同时接入 Meta AI。用聊天产品感受能力,和拿到权重自行运行,是不同的接触方式。
7 月 23 日,3.1 增加 405B,并更新 8B、70B,扩到 128K 与八种语言。Meta 称官方多项测试可与 GPT-4、GPT-4o、Claude 3.5 Sonnet 竞争;这是当时自测的结论,不是所有场景的统一冠军。
Meta 还允许用该系列输出改进其他模型,支持合成数据和蒸馏,让大模型的材料帮助较小模型改进。从第一代研究权重到这里,开放路线开始同时讨论最强能力、运行条件,以及能力如何传到更容易部署的模型。
参考系统、Llama Guard 3、Prompt Guard 与 Llama Stack API 把工具和系统也带进来。本站把这一阶段理解为从‘提供模型’走向‘让别人搭建系统’。能打开哪些用途,要继续看数据、工具和环境怎样接入,以及最终结果。
来源与补充
- Meta:Llama 3 ↗官方发布 · 2024 年 4 月 18 日8B、70B、8K 文本模型,训练与产品接入;后续功能没有提前归给初版。
- Meta:Llama 3.1 ↗官方发布与自测 · 2024 年 7 月 23 日405B、128K、语言、官方比较,以及输出使用与参考系统。
- Llama 团队:The Llama 3 Herd of Models ↗原研究论文 · 2024 年 7 月 31 日初稿基础与后训练型号、能力测试和训练系统;论文初稿日期不同于发布日。
082024 年 9—12 月 · 视觉、端侧与效率EN
模型能力,开始分成不同尺寸与用途
9 月 25 日,Llama 3.2 分两条路:11B、90B 面向图像理解,1B、3B 是端侧文本模型。前者看图表、页面和照片,后者做摘要与改写。不能把同系列的视觉能力借给手机小模型,也不能把理解图像写成生成图像。
小模型提供了在设备上做简单任务的路线,官方也对部分芯片优化。但端侧适用不等于每部旧手机都能流畅运行:型号、量化、硬件和应用一起影响体验。这增加部署选择,不意味着用户应该一律改用最小的模型。
12 月 6 日,3.3 发布 70B 文本指令模型。官方 HumanEval 为 88.4,接近 3.1 405B 的 89.0;IFEval 为 92.1,高于表中的 88.6。但 MMLU-Pro 仍较低,部分项目接近或领先,不能写成全面相等。
这一阶段不只有参数变大,还有视觉、端侧和更强的 70B 文本分工。本站认为,选择应接回具体任务、输入和运行位置。实际费用与体验还要看服务和设备,历史型号的基准成绩不会自动变成今天某款应用的表现。
来源与补充
- Meta:Llama 3.2 视觉与端侧 ↗官方发布 · 2024 年 9 月 25 日11B、90B 视觉与 1B、3B 文本的区别,以及硬件优化范围。
- Meta:Llama 3.3 原模型卡 ↗官方型号与自测 · 2024 年 12 月 6 日发布70B 文本型号、128K、八种语言与同表比较的 HumanEval、IFEval 和 MMLU-Pro。
092025 年 4 月 · 新架构与版本比较EN
Llama 4 的转折,也包括‘测的是哪一版’
2025 年 4 月 5 日,Llama 4 提供 Scout、Maverick,转向原生多模态与混合专家。两者激活约 17B 参数,总参数却是 109B、400B,不能只按激活量判断内存。上下文也不同:Scout 10M,Maverick 1M。
官方把图像、编码、推理与成本效率作为卖点。原卡的公开输入是文本与图像,输出文本与代码,使用视频帧训练不等于生成视频。更大 Behemoth 当时仍训练,属于预览与教师模型,不是已交付的第三款下载型号。
发布页的 Arena 1417 分,来自实验聊天版 Llama-4-Maverick-03-26-Experimental。Arena 随后公开该版对战材料。不能将实验成绩直接套给下载版 Maverick;观察回答和选择模型,要核对真正的版本与服务。
这里既有架构进展,也有宣传与使用之间的比较问题。本站认为,可下载权重方便外部检验,共同名称却不保证是同一对象。接着看 Wonder,也应连接官方目标、独立测试、开发者样本和产品实际型号,判断这次走到了哪里。
来源与补充
- Meta:Llama 4 发布稿 ↗官方发布与自测 · 2025 年 4 月 5 日Scout、Maverick、Behemoth 预览,以及 Arena 成绩来自实验聊天版的限定。
- Meta:Llama 4 原模型卡 ↗官方型号、模态与配置激活与总参数、各型号上下文、输入与输出范围;这些不同于产品性能保证。
- Arena:Maverick 实验版对战材料 ↗评测平台原材料 · 2025 年 4 月公开实验版完整型号与用户提示、模型回答和选择的原材料仓库;不把实验版排名套给下载版。
102025:重新组织模型、研究与产品EN
Wang、赵晟佳与 Friedman,各自接过了什么?
2025 年 6 月 12 日,Scale 宣布创始人 Alexandr Wang 加入 Meta,自己继续独立运营。Wang 从为 AI 公司提供数据的企业,走进了自己建设前沿模型的实验室。7 月 30 日的 Meta 财报电话会把新分工讲清:他统筹 Meta Superintelligence Labs(MSL),Nat Friedman 负责 AI 产品与应用研究,赵晟佳(Shengjia Zhao)担任新团队的首席科学家。
赵晟佳此前已经参与 OpenAI 的模型训练。GPT-4 原技术报告在贡献说明中,把他列为奖励模型负责人,也列入 ChatGPT 评测工作。奖励模型把“哪种回答更好”的反馈带进训练;这段经历让人理解,他接过的科学职责与模型怎样学习、怎样评估联系在一起,而不是只给新团队增加一个头衔。这里采用原报告列明的工作,不把整个产品的成果归给一个人。
赵晟佳的职位于 7 月 25 日正式宣布。重点是研究方向怎样有人负责,而不是把公司负责人、模型科学家和产品负责人当成同一种角色。当时 LeCun 在 Meta 的原帖下说明:自己的 FAIR 首席科学家职责仍是长期研究,与新模型实验室的职责不同。那次任命并不等于 FAIR 当天被撤销,后来的人事变化也要按各自时间看。
Wonder 发布对谈里,Wang 回忆这次转折从一次会议中的 WhatsApp 来电邀请开始,后来几个人组起核心班底,再密集招募研究者。扎克伯格解释,选择这位数据企业创始人,是看中他的战略判断、人才组织和沟通能力。这个实验室虽然尝试像创业团队一样工作,仍依靠 Meta 的数据中心和其他团队支持。把负责科学、组织团队和交付产品的人接在一起,才是这次重建的具体做法;效果还要回到模型与产品测试。
来源与补充
- Scale:Wang 加入 Meta ↗公司原公告 · 2025-06-12Wang 转入 Meta;Scale 独立运营,不能写成 Meta 全资收购。
- Meta:赵晟佳任命与 LeCun 本人回应 ↗官方原帖与本人评论 · 2025-07-25新实验室科学负责人,与当时 FAIR 长期研究职责的区分。
- OpenAI · GPT-4 原技术报告 ↗原作者贡献说明 · 奖励模型与评测强化学习与对齐部分列赵晟佳为奖励模型负责人,评测部分列 ChatGPT evaluations;不扩写未核实的项目名单。
- Meta 2025 年第二季度电话会 ↗公司原逐字稿 · 2025-07-30原稿第 1—2 页说明 MSL 范围及三人的分工。
- Cheeky Pint · 组建 MSL 的当事人回顾 ↗原访谈与逐字稿 · 北京时间 2026-10-131:40:46 起谈来电、核心团队与招募;负责人的回顾与模型独立评测分别看。
11三次原访谈,接回路线变化EN
扎克伯格:从把模型开放出去,到把行为训练进模型
2024 年 4 月 18 日,Llama 3 发布当天的 Dwarkesh 访谈里,扎克伯格把 FAIR 与生成式 AI 团队分开讲:前者研究长期问题,后者把基础模型带进产品。他还回顾了 Reels 推荐系统曾受 GPU 不足限制,Meta 因而提前增加算力储备;那次准备后来帮助了大模型。开放模型、服务自身产品和提前建设基础设施,在这时已经连接在一起。
2025 年 4 月 29 日的第二次访谈,他承认过度优化外部榜单曾让团队偏离产品体验,并强调速度、自然交互、多模态和个性化。节目里的追问也很有价值:公司自己的用户反馈,怎样与别人的模型公平比较?这段争论说明“用户觉得好用”与“排行榜领先”不是同一个证据;Llama 4 的后续重组应接在这个背景下理解。
2026 年 Wonder 发布后的 Cheeky Pint 对谈又向前一步。扎克伯格认为,产品的很多能力和行为越来越进入模型本身;Wang 谈到主动程度、说话方式与工具使用也需要具体设计。对读者而言,值得看的变化是:Meta 正从“把通用模型接进应用”,走向“同时训练模型怎样完成个人事务”。这是对访谈与发布资料的整理,不代表每项生活任务已经可靠完成。
- 2024:开放模型、产品与算力原站有完整逐字稿与视频入口。
- 2025:榜单与真正的用户价值原站有逐字稿;这是当时的判断和计划。
- 2026:Wonder 与重建 MSL 的经历07:28 模型与产品;14:35 Wonder;1:40:46 重建团队。
来源与补充
- Dwarkesh:Llama 3 与基础设施 ↗原访谈与人工编辑逐字稿 · 2024-04-1804:22 谈 Reels 算力经历;08:32 起谈 FAIR、产品与通用能力。
- Dwarkesh:Llama 4 与用户价值 ↗原访谈与逐字稿 · 2025-04-29开头讨论榜单、速度与个性化;39:49 进入开放模型。
- Cheeky Pint:Wonder 发布对谈 ↗原节目与逐字稿 · 北京时间 2026-10-13原站 10 月 12 日刊发,北京时间 13 日 03:26;07:28 讨论模型与产品。录制日未单独公开。
12产品负责人怎样把经历带进模型EN
Friedman:从 GitHub 的用户反馈,到 Muse 的训练与迭代
Nat Friedman 的个人主页记载,他在 2018—2021 年担任 GitHub CEO。在 2026 年 Stripe Sessions 的原访谈中,他回顾了接手 GitHub 前先花时间听用户的问题,以及进入公司后怎样帮助团队走出“产品太受喜爱,因此不敢改动”的顾虑。这个经历接回 Muse:新能力要到真实用户手里,才能知道哪些地方值得继续训练和修改。
他把关键循环说成:有一个想法,做出用户能用的东西,观察反馈,再改进。谈 Meta 时,他举了标注工具的例子:审批和操作太繁重,研究人员就倾向于把许多任务捆在一起,减少实验次数;工具变容易后,小实验才能更频繁开展。这里讨论的是怎样缩短学习过程,不是“只要少开会,模型就一定更强”。
Wonder 对谈里,扎克伯格进一步把 Friedman 团队的产品判断接到模型后训练上:可靠程度、什么时候主动、怎样交流,都需要被训练和评估。这让产品与模型不再是两个简单串联的部门。BitShovel 的理解是,个人助手要做得自然,既需要实验室提升能力,也需要产品团队把人在具体场景中的感受带回训练。
- 读 Friedman 的产品与团队访谈公开逐字稿,可查 GitHub 接手经历、反馈循环与 Meta 标注工具。
来源与补充
- Nat Friedman 个人主页 ↗本人经历与观点 · 10 月 13 日回读GitHub 任期;个人观点不当作产品效果证明。
- Stripe Sessions:Friedman 与 Gross ↗主办方原逐字稿 · 2026 年会议原页视频上传元数据为 4 月 30 日;逐字稿公开,完整视频页面提示填写表单。
- Cheeky Pint:产品团队与后训练 ↗本人原访谈 · 北京时间 2026-10-13说明产品行为与训练的联系,不能代替独立测试。
13FAIR 的前史与另一条研究路线EN
LeCun:理解世界的路线,不能直接等同于 Wonder
Yann LeCun 在 2013 年 12 月加入当时的 Facebook,成为 FAIR 的创始负责人。其后他转向首席科学家职责,把长期研究、开放交流和探索下一代学习方法放在重要位置。看 Meta 的历史不能只从 Llama 开始:语言模型热潮之前,视觉、表示学习等研究已在这里持续推进。
2024 年 3 月 7 日的 Lex Fridman 访谈中,他把理解物理世界、持久记忆、推理和规划列为要继续解决的问题。以端起杯子为例,系统应预测行动之后会发生什么,而不只是生成一句合理的话。他介绍的 JEPA,是学习对行动相关的抽象表示,避免必须预测画面里所有像素。这里是 LeCun 当时对技术路线的主张,不是对后来所有模型的最终判决。
2025 年 11 月 19 日,他本人宣布准备离开 Meta,并留到当年年底,继续在独立公司推进 Advanced Machine Intelligence。10 月 13 日回读其个人主页,现列 AMI Labs 执行董事长。因此他在本专题里是早期建设者与另一条研究路线的代表,不应继续被写成 Wonder 当前团队的负责人。
Wonder 也强调记忆与长任务,但相似的目标不意味着同一种架构。不能仅凭这些词,就说 Wonder 已经采用 LeCun 的世界模型路线,或已经解决了他提出的所有问题。把 FAIR 的探索、Llama 的语言模型与 MSL 的个人助手放在一起,才能看见 Meta AI 的发展一直存在多条并行的线。
- 听 LeCun 谈世界模型与规划25:07 开始 JEPA,原作者视频;逐字稿可在来源区继续读。
来源与补充
- Meta:LeCun 历史人物资料 ↗官方历史履历页2013 年 12 月加入;页面仍留旧头衔,现职以本人较新资料为准。
- Lex Fridman #416:LeCun ↗原访谈与人工逐字稿 · 2024-03-07视频版 02:18 讨论 LLM 局限;25:07 JEPA;44:22 规划。音频页时间轴含广告,时间不同。
- LeCun 本人离职说明 ↗本人原帖 · 2025-11-19宣布计划及留到年底,不能写成发帖当天已离职。
- LeCun 个人主页 ↗本人现职 · 2026-10-13 回读当前列 AMI Labs 执行董事长;页脚旧更新日期不能冒充此次核对时间。
142026 · 模型怎样一步步接近工作EN
从 Spark 到 Wonder,改变的不只是回答得分
4 月 8 日的 Muse Spark,是 Meta 重建模型体系后的第一款产品,起点已经包含多模态理解、工具使用与多代理协作。7 月 9 日的 1.1 继续增强电脑操作、编程与上下文管理,并随 Meta Model API 公开预览进入开发者手中:模型开始从回答问题,走向看材料、调工具、处理变化中的任务。
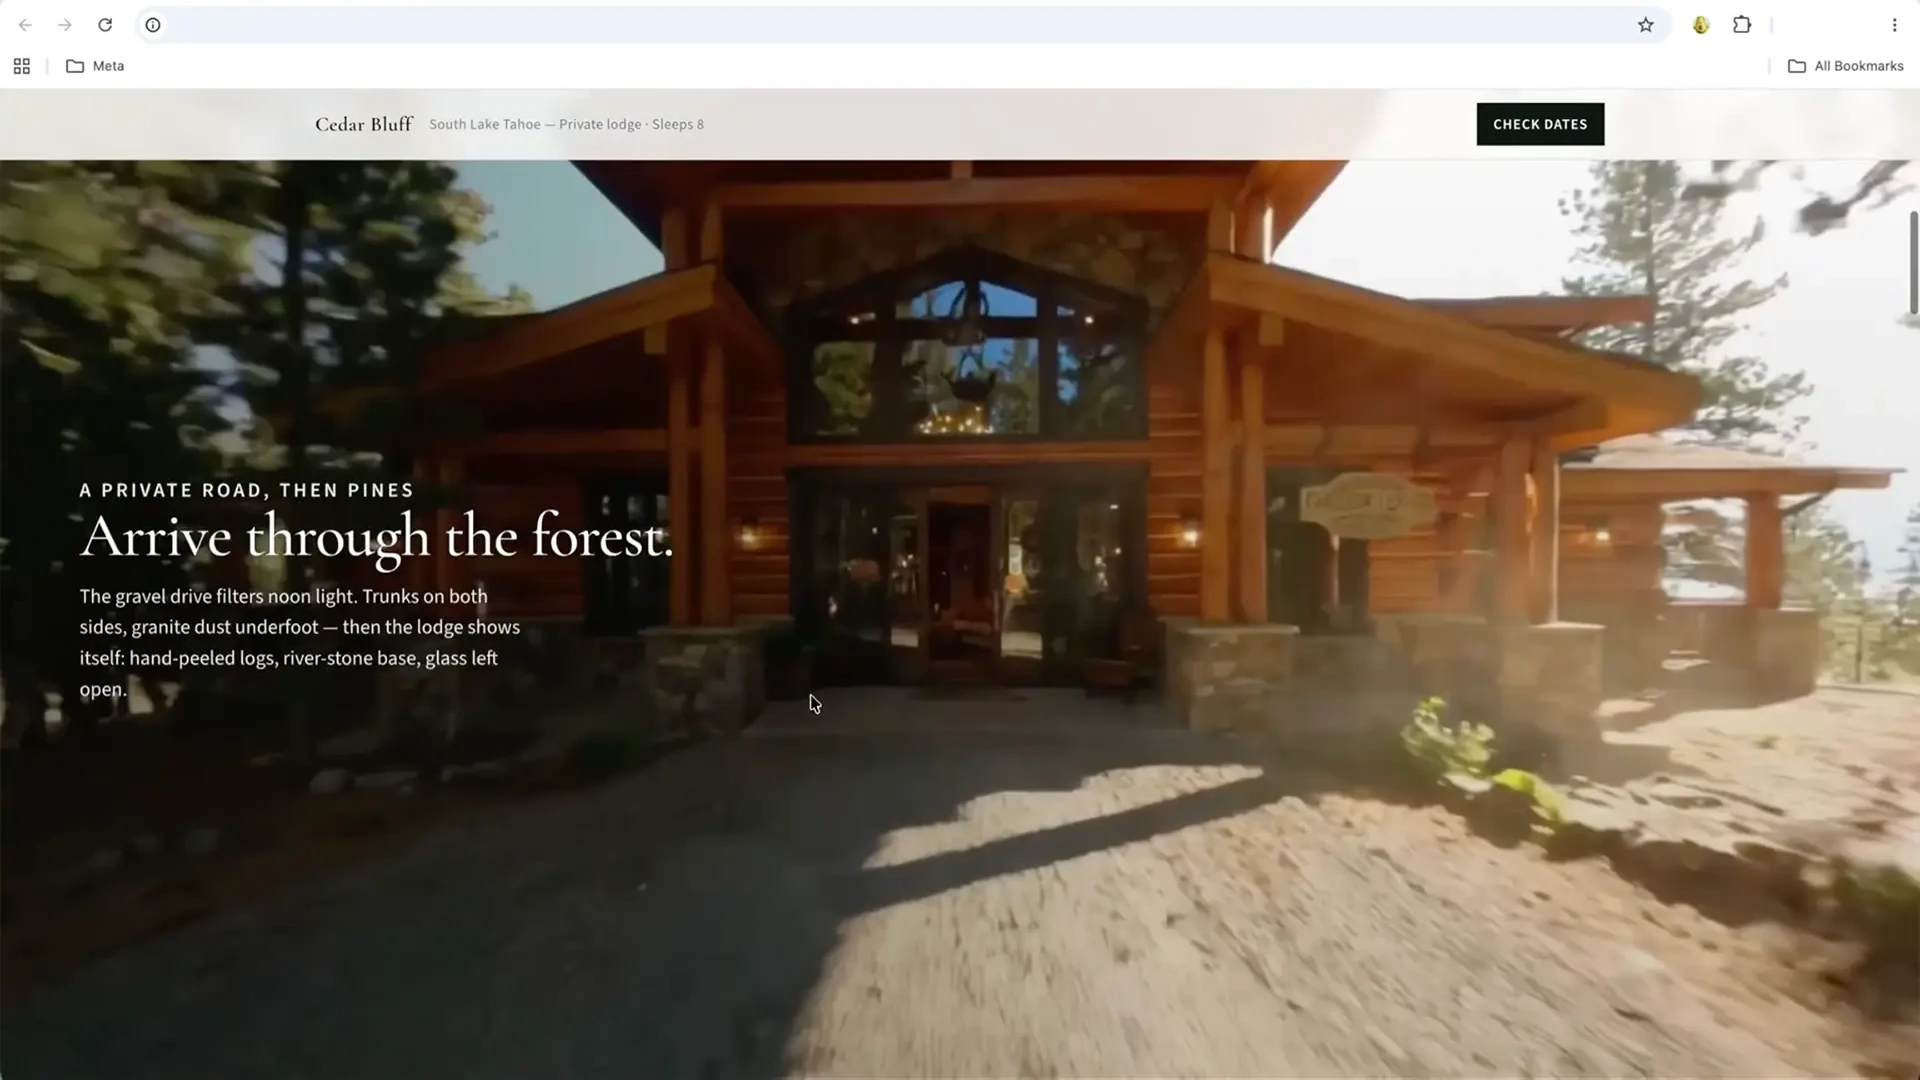
8 月 5 日,Spark 1.2 与 Muse Code beta 一起发布。前者加强代码生成、复杂调试和代码库理解,后者提供终端、工具、计划与持续的子代理;Meta 将两者共同训练。官方用一段房屋视频制作度假屋网页,说明“看懂输入—写出代码—在浏览器检查”怎样连起来。模型与代理环境都参与结果。
9 月 2 日的 1.3,重点进一步转向长任务:保持细致要求、发现计划缺口、处理同一长对话里的多个请求,并在需要时询问或确认。10 月 12 日的 Wonder 则建立在更大、更强的基础模型上,强调把已有背景带到新任务中,并持续处理阻碍。这是一条从理解与调用,走向记住背景和持续交付的路线。
这条主线还有不同分支。8 月 10 日的 Glimmer 是 30B 开放权重模型,以 Apache 2.0 许可支持本地代理;官方的四位量化方案仍需要合适的电脑内存。9 月 1 日的 Voice Transcribe 负责实时转录、区分说话人和判断一句话何时结束,包含中英混说示例。它们分别解决运行地点与听觉输入,不应拿 Wonder 的综合分数概括所有型号。
| 原发布日期 | 型号 | 重点变化 |
|---|---|---|
| 2026-04-08 | Muse Spark | 多模态、工具与多代理 |
| 2026-07-09 | Spark 1.1 | 电脑操作与开发者 API |
| 2026-08-05 | Spark 1.2 / Muse Code | 代码工作与代理共同训练 |
| 2026-08-10 | Glimmer 30B | 开放权重、本地代理 |
| 2026-09-01 | Voice Transcribe | 实时听写、说话人和端点 |
| 2026-09-02 | Spark 1.3 | 长任务、指令保持与工具协作 |
| 2026-10-12 | Wonder / Full | 更强基础、记忆与持续执行 |
来源与补充
- Meta · Muse Spark 首版 ↗官方发布 · 4 月 8 日重建模型体系的起点与多模态、工具、多代理能力。
- Meta · Spark 1.1 与 API ↗官方发布 · 7 月 9 日模型改进、电脑操作与公开预览分别说明。
- Meta · Spark 1.2 与 Muse Code ↗官方发布 · 8 月 5 日共同训练与视频输入制作网页的官方示例。
- Meta · Spark 1.3 ↗官方发布 · 9 月 2 日长任务、指令保持与交付物。
- Meta · Glimmer ↗官方发布 · 8 月 10 日30B、Apache 2.0 和本地运行的内存条件。
- Meta · Voice Transcribe ↗官方发布 · 9 月 1 日实时转录、说话人区分、端点与中英混说示例。
15Wonder · 官方能力与方法EN
记住的背景,能不能在下一步真正派上用场?
Wonder 的官方重点可以放回一件具体事情来理解:你曾说过预算、时间与偏好,之后要改一份方案,它能否找回相关背景;遇到网页变动或工具失败,又能否换路继续?Meta 将前一部分称为 Active Memory,将后一部分称为 Active Focus。价值在于把事情接下去,而不是把记忆容量当成结果。
模型报告的 MemoryBench 用 64K–100K tokens 的多轮对话,夹入干扰和后来改过的信息;FocusBench 则围绕住房、旅行、IT 与财务等任务中的阻碍和变化。两项属于 Meta 内部评测。它们帮助解释训练追求什么;普通用户在产品里如何查看、更正背景,以及任务实际用上哪个模型,还要看具体接入。
Wonder 报告列出文字、图像、视频与音频输入,输出为文字。官方厨房游戏体现的是模型写代码、调工具形成作品的路径。媒体生成还有 Muse Image 和 Muse Video 分支:7 月 7 日原文分别写已推出 Image、预览 Video。理解这些分工,才能把“看懂一段视频”“做一个网页”和“直接生成视频”接到正确的型号与工具。
来源与补充
- Meta · Wonder 发布 ↗官方能力说明 · 10 月 12 日更强基础模型、Active Memory、Active Focus 与作品样本。
- Meta · Wonder 模型报告 ↗原始模型卡 · 方法与边界输入输出类型及 MemoryBench、FocusBench 的内部性质。
- Meta · Muse Image 与 Video ↗官方历史发布 · 7 月 7 日Image 推出、Video 预览的原状态,不把两个分支混成 Wonder 的文字输出。
16独立参照 · 10 月 13 日核对EN
Meta 进入第一梯队,Wonder Full 给出了清楚依据
BitShovel 的判断是:Meta 的最新大型通用模型已经进入第一梯队,尤其是 Wonder Full。10 月 13 日回读 Artificial Analysis 完整原表,Full 的 max 档综合指数为 56,与 Sonnet 5.5 的最高收录档同分,接近 Opus 5.5 的 58;普通 Wonder 为 52。它已经成为与主流高端模型比较的实际选择。
纵向看,同一版指数中的 Spark 1.3 max 为 48,Wonder 为 52,Full 为 56。横向看,Astra max 与 Fable 5.1 的最高收录档均为 53。这里的“第一梯队”是基于这一独立综合能力参照作的编辑判断;下表保留各模型原档位与回退设置,分数差不能直接换算为能力百分比。
代码能力也值得重点看,但它并非所有任务都领先。Meta 报告注明 Datacurve 提供的 DeepSWE 1.1 成绩为 Full 79.0、普通 78.8;同一报告中的 ProgramBench,Full 59.0,Opus 5.5 为 70.5。前者与后者测不同的软件工作,已经说明“做哪件事”仍会影响选择。
本轮实际打开 Abundant AI 的 SWE-Marathon v1.1 原榜,两款 Wonder 经 Muse Code、max 档列前两行:Full 53.1%,普通 52.5%,随后是 Sonnet 5.5 经 Claude Code 的 51.3%。这里有 20 个任务、每题 8 次试验,必须通过全部验证才得分;模型与代理一起参与结果。两款 Wonder 相差一个成功试验,不必把这点差距放大成普遍优劣。
| 型号 | 原配置 | 综合指数 |
|---|---|---|
| Claude Opus 5.5 | max · 含回退机制 | 58 |
| Claude Sonnet 5.5 | max · 含回退机制 | 56 |
| Muse Wonder Full | max | 56 |
| GPT-6 Astra | max | 53 |
| Claude Fable 5.1 | max · 含回退机制 | 53 |
| Muse Wonder | max | 52 |
| Muse Spark 1.3 | max | 48 |
来源与补充
当前 SWE-Marathon 的 Full 是 max 档 53.1%;Meta 发布报告中的 Full 是 xhigh 档 57.5,不能用两个不同设置判断成绩下降。DeepSWE 新数字仍注明来自 Meta 引述,原公开页面当前标 9 月 22 日。
- Artificial Analysis · 完整原榜 ↗独立综合评测 · v4.3.2本次完整读取 271 行,已收录型号的综合分数与晨轮一致,服务速度等列有变化。
- Meta · Wonder 模型报告 ↗厂商报告 · 逐项保留结果来源DeepSWE、ProgramBench 与 SWE-Marathon 的分工、来源及代理设置。
- Abundant AI · SWE-Marathon 原榜 ↗独立代理评测 · v1.1 · 浏览器回读20 题、每题 8 次、max 档与实际代理;当前 Full 53.1 与发布报告的 xhigh 57.5 分别保留。
- Datacurve · DeepSWE 原榜 ↗评测机构原页 · 当前标 9 月 22 日本次原公开页面的模型范围与共同代理说明,不将厂商新数字写成该页已更新。
17使用入口 · 10 月 13 日核对EN
准备尝试时,先分清 API、Muse Code 与个人 Muse
普通 Wonder 可以经 Meta Model API 或 Muse Code 使用。10 月 13 日回读官方开发者介绍,API 标价为每百万 tokens 输入 4 美元、缓存输入 0.20 美元、输出 20 美元;这属于普通型号的计费说明,不能给 Full 套同一价格。开发者可以把现有兼容接口接到 muse-wonder-1.0,再比较自己实际的任务。
Full 当前仅在 Muse Code 的 Power Usage 与 Maximum Usage 订阅中提供。官方将 Maximum 的用量上限描述为 Everyday 的 80 倍,同时保留五小时与每周重置;这不是每次任务可以使用的固定 token 数。已经有一个满意的助手时,可以先选最在意的一项长任务比较,再决定是否增加服务。
个人 Muse 是另一层产品。10 月 12 日原发布仍说 Wonder 将很快接入,先面向订阅者,不能由模型上线推定手机、眼镜或 Charm 已经全部换成它。可以从本专题了解模型的变化,再去原 Muse 专题看背景记忆、服务接入和随身硬件究竟怎样让这些能力进入生活。
来源与补充
- Josh Walters · Wonder 开发者发布 ↗官方入口与费用 · 原发布 10 月 12 日本轮页面可读;普通 API 的美元价格、Full 套餐与用量重置分别确认。
- Meta · Wonder 产品接入计划 ↗官方发布 · 个人 Muse 仍为后续开发者当前入口与个人代理未来接入分别说明。
18接回作品与生活EN
从一款强模型,到一个人会继续用的 AI
- 打开官方厨房游戏样本外部可操作成品;本站仅进入第一关,未复跑生成或验证完整通关。
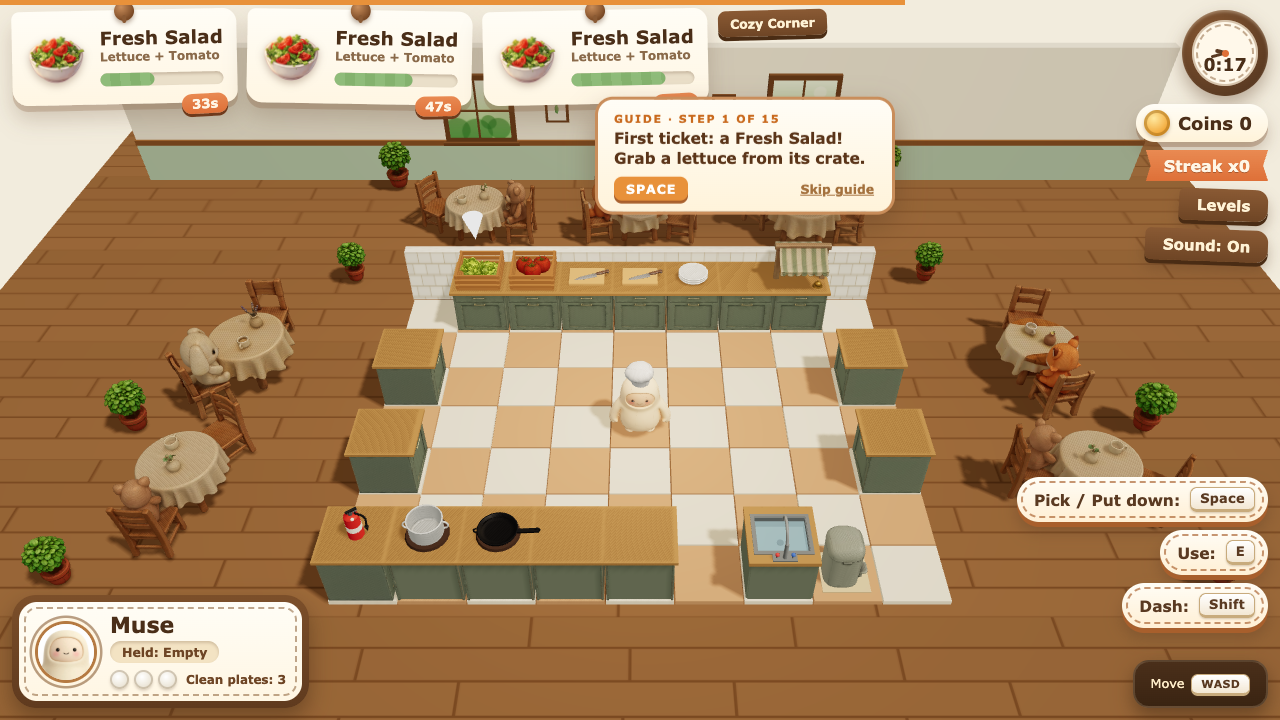
Llama 阶段让开发者获得权重,围绕自己的资料、算力和应用做定制;Wonder 阶段增加了直接通过模型服务与 Muse Code 工作的路线。两条路线改变的是使用方式:前者更容易研究和控制部署,后者让人通过现成入口使用前沿能力。今天 Meta 的意义在于它同时连接了研究生态、模型服务和面向普通人的产品,具体开放条件仍按每一个版本看。
对于创作者,官方厨房小游戏让代码与图片输入成为一个可以操作的作品;对于开发者,真实任务要接到自己的会话、工具和文件,再确认实际执行的模型;对于普通用户,个人 Muse 和随身硬件把背景、消息和生活事务接进来。强模型提高这条链路的可能性,产品还需要把记忆、权限、失败后的接续与人的决定处理好。本站已有 Muse 专题继续承接硬件和真实事务,本专题集中整理支撑这些体验的模型与发展脉络。
如果你已经在用 Opus、Astra、GLM 或 Kimi,Wonder 提供了一个新的参照。先比较同一份资料、一次需要修改的作品或同一项有明确结果的事务,看要求有没有保留、改动能否继续、结果是否更贴近你想做的事情,再把费用和等待放进判断。新进入第一梯队的价值,是多了一条值得探索的路径;后续开发者的具体作品与使用经验,会继续补全今天榜单还没有回答的部分。
来源与补充
- Meta · Wonder 作品与路线 ↗官方演示与能力说明厨房样本为官方公开成品;场景比较为本站分析,硬件体验沿原专题分别核对。
接下来还会关注
19继续关注EN
接下来还会关注
- Wonder 的中文任务、视觉理解和长项目,何时有完整输入、过程与可改产物的同题对照?
- 普通 Wonder 与 Full 在相同工作里的质量、费用和等待怎样影响选择?
- 开放权重与托管前沿模型下一步怎样分工,Meta 会公开什么研究与可复现材料?
- 模型记忆进入个人 Muse 和硬件后,背景修订、任务接续和人的选择实际怎样呈现?
- Wang、赵晟佳、Friedman 团队后续的研究、产品与原访谈,能怎样解释持续变化?