模型与实际接入 · 本地部署、视觉与任务
Nemotron 3.5:把代理搬到本地,模型以外还差什么?
Super VL与Bolt分别面向怎样的工作?从原压缩图、内存配方和速度比较,理解“24GB”名称之外还要给哪些运行条件留空间。
NVIDIA在10月15日发布Nemotron 3.5 Super VL与Bolt 74B-A9B,前者是更大的多模态型号,后者压缩到面向本地代理的体积。本文在10月20日北京晚间核对原报告、模型卡和当前独立榜;以下是资料解读,没有下载权重、安装运行环境或实测电脑。
先看工作:读文件、看页面,再调用工具
例如整理一份带表格的报销材料,代理既要看懂图片,又要取出字段、按规则判断,再把结果交给工具。Super VL把文字、图像和视频理解接进同一模型;它有120B总参数、每次激活12B,最高1M上下文。这里的“多模态”是理解输入并输出文字,不是生成视频。
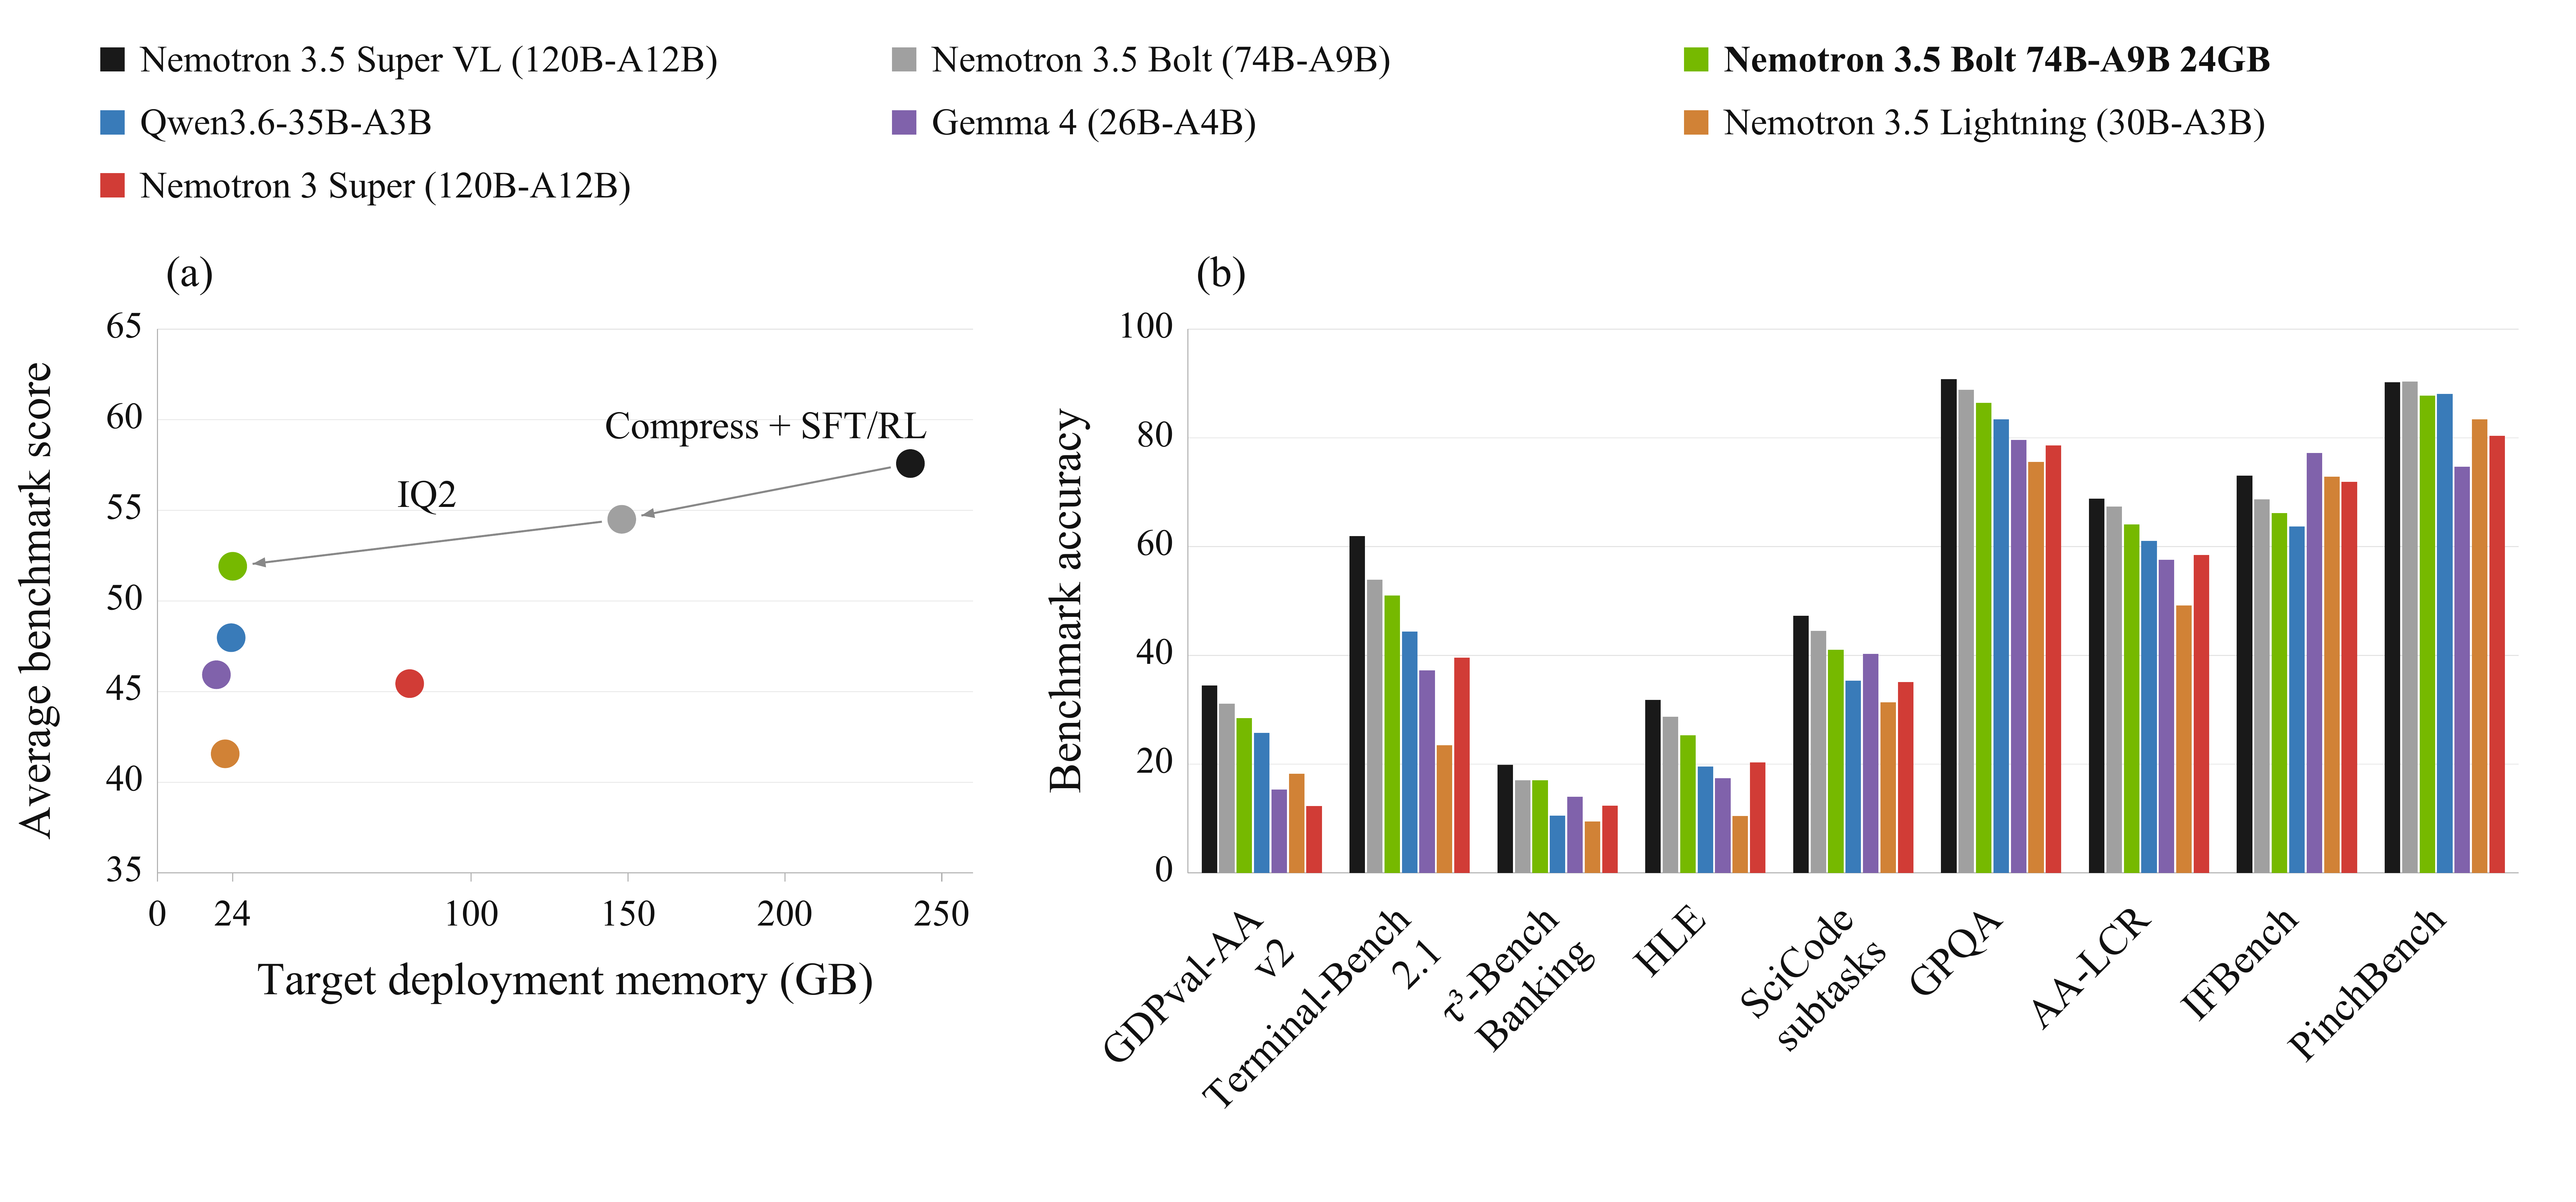
Bolt从Super VL压缩而来,保留74B总参数、9B激活,再用低比特量化和后续训练缩小体积。Super VL也有面向DGX Spark的NVFP4配方;Bolt则更强调与其他本地应用共用资源。实际入口要认准型号、权重格式、运行后端与机器。
来源与延伸阅读
- NVIDIA · Super VL与Bolt发布厂商原发布 · 2026年10月15日正式发布的两个型号、应用方向与后续E4B计划;不把后续计划当成已取得模型。
- Super VL的工作流与专门化方法NVIDIA技术原文文档、工具与视觉能力怎样组合;公司案例和效率数字各有任务范围,不泛化成通用模型优势。
- Super VL BF16模型卡NVIDIA官方模型卡 · 本轮读取120B/12B active、最高1M窗口、BF16硬件配方与OpenMDW1.1许可。
- Super VL NVFP4模型卡NVIDIA官方量化版本同一型号的量化部署路线;DGX Spark与其他GPU配置分别核对,不能套用BF16硬件要求。
- Bolt压缩、量化与推理比较NVIDIA研究原报告 · 10月15日原图、84TPS的硬件/后端/工作负载与AgentPerf Local回放时长;厂商实验不是本站实测。
“24GB模型”为什么还列28GB和32GB配方?
模型名称不能代替整机内存预算。当前Bolt GGUF卡还要求视觉projector,并给加速用的独立LiLiCorr drafter入口;运行时另有上下文缓存、并发和其他应用占用。它列出的28GB与32GB配方都只有一个并发序列,窗口不同,不能据“24GB”就判断任意24GB显卡可照搬。
Bolt最高256K窗口由提示、视觉输入、历史、工具返回和生成答案共用。Super VL的BF16示例是4张H100或2张GB200;NVFP4卡另列单台DGX Spark、单张H200等配置。选量化版本会改变部署条件,不能把某一配置的窗口、速度和内存拆开任意组合。
| 配方 | 上下文与并发 | 卡中对应硬件 |
|---|---|---|
| 28GB | 65,536 tokens;1序列 | RTX Spark 64GB或独显32GB+ |
| 32GB | 262,144 tokens;1序列 | RTX Spark 128GB或独显48GB+ |
来源与延伸阅读
- Super VL BF16模型卡NVIDIA官方模型卡 · 本轮读取120B/12B active、最高1M窗口、BF16硬件配方与OpenMDW1.1许可。
- Super VL NVFP4模型卡NVIDIA官方量化版本同一型号的量化部署路线;DGX Spark与其他GPU配置分别核对,不能套用BF16硬件要求。
- Bolt压缩、量化与推理比较NVIDIA研究原报告 · 10月15日原图、84TPS的硬件/后端/工作负载与AgentPerf Local回放时长;厂商实验不是本站实测。
- Bolt GGUF当前部署配方NVIDIA官方模型卡28GB/32GB配方、单并发、视觉projector和独立drafter、上下文共用限制。
更快要问:在哪台机器,做完了什么?
NVIDIA的本地比较用同一台128GB Surface Laptop Ultra、Windows与llama.cpp。Bolt在SPEED-Bench-Coding约84 tokens/s,在AgentPerf Local的轨迹回放约601秒;同表Qwen3.6 35B-A3B约97 tokens/s、454秒。Bolt不是该表最快的一项,它主张的是体积、表现与速度之间的取舍。回放时长也不能直接当成读者自己的项目交付时间。
10月20日独立AA原榜中,Super VL为26、Bolt为21,来源未另标effort。这个综合指数与原图厂商选择的平均分、某个工具任务成功率、解码速度各问不同问题;不能合成一个“本地第一”的结论。已有本地模型的读者,更适合在同一份材料、同一工具条件下比较完整结果。
来源与延伸阅读
- Bolt压缩、量化与推理比较NVIDIA研究原报告 · 10月15日原图、84TPS的硬件/后端/工作负载与AgentPerf Local回放时长;厂商实验不是本站实测。
- Artificial Analysis当前原榜独立评测原表 · 10月20日读取Super VL26、Bolt21;v4.3.2指数,来源未另标effort,不与厂商所选测试平均分混算。
先选一项小工作,再决定要不要搬回电脑
一个可比较的起点,是用同一组获准使用的收据或文档,要求输出相同字段,并保留缺失项和出处,再看错误是否真的减少、等待和资源占用是否可接受。这是编辑建议,不是本站已经完成的测试。若还需要联网搜索或外部工具,本地权重也不自动意味着整个流程离线,资料去向仍取决于工具设置。
同一时期的Qwen3.8 Flash Next FP4-Local则是另一种量化部署路线,并非NVIDIA重新发布一代Qwen能力。当前卡称检查点在磁盘约96GiB,验证机器是DGX Spark与RTX PRO 6000 Blackwell,还要求指定社区vLLM容器;不能把FP4、Local或磁盘大小理解成普通笔记本都能直接用。
如果只是偶尔用一次,先用现有服务比较完成质量和总费用,可能比购置硬件更容易判断。只有确定哪些材料必须留下、需要多长窗口、一天运行多少任务,才有依据选择本地后端;下载许可与运行配方也应沿当前模型卡核对。
来源与延伸阅读
- Super VL BF16模型卡NVIDIA官方模型卡 · 本轮读取120B/12B active、最高1M窗口、BF16硬件配方与OpenMDW1.1许可。
- Super VL NVFP4模型卡NVIDIA官方量化版本同一型号的量化部署路线;DGX Spark与其他GPU配置分别核对,不能套用BF16硬件要求。
- Bolt GGUF当前部署配方NVIDIA官方模型卡28GB/32GB配方、单并发、视觉projector和独立drafter、上下文共用限制。
- Qwen3.8 Flash Next FP4-Local当前卡NVIDIA量化路线 · 非Qwen新一代发布约96GiB磁盘检查点、受验证硬件与专用容器条件;磁盘大小不是运行内存承诺。