模型与接入
Gemini 4 Carbon:新尺子下的 59 分,入口先开给网络防御者
谷歌太平洋时间 10 月 28 日公布 Gemini 4 Carbon:在 Artificial Analysis 新基准 Intelligence Index v5.0 下以 high 档 59 分排第一。网络安全三个环节的官方成绩是 SEC-bench Pro 88.2%、ExploitGym 54.8%、CWE-bench 71.0%;同一基准换版让同批模型分数整体重排,v4.3.2 与 v5.0 的分数不能混比。入口本周先向一小部分网络防御者开放,开发者与消费者要等;介绍期 API 价格输入 2 美元、输出 10 美元每百万 token,之后 4/20 美元。本站 10 月 29 日直读官方页与榜单页,未运行模型。
本文依据谷歌官方发布页(blog.google,2026-10-28 太平洋时间发布,本站 10 月 29 日直读)、Artificial Analysis 榜单页与方法页(本站 10 月 29 日直读,方法页标注 v5.0)及 IT之家 10 月 29 日中文报道整理。全部成绩为谷歌官方口径或 AA 独立榜单口径,本站未运行任何模型;文中另注明哪些数字有第三方基准可查、哪些只是厂商内部数据。
59 分第一,入口先开给网络防御者
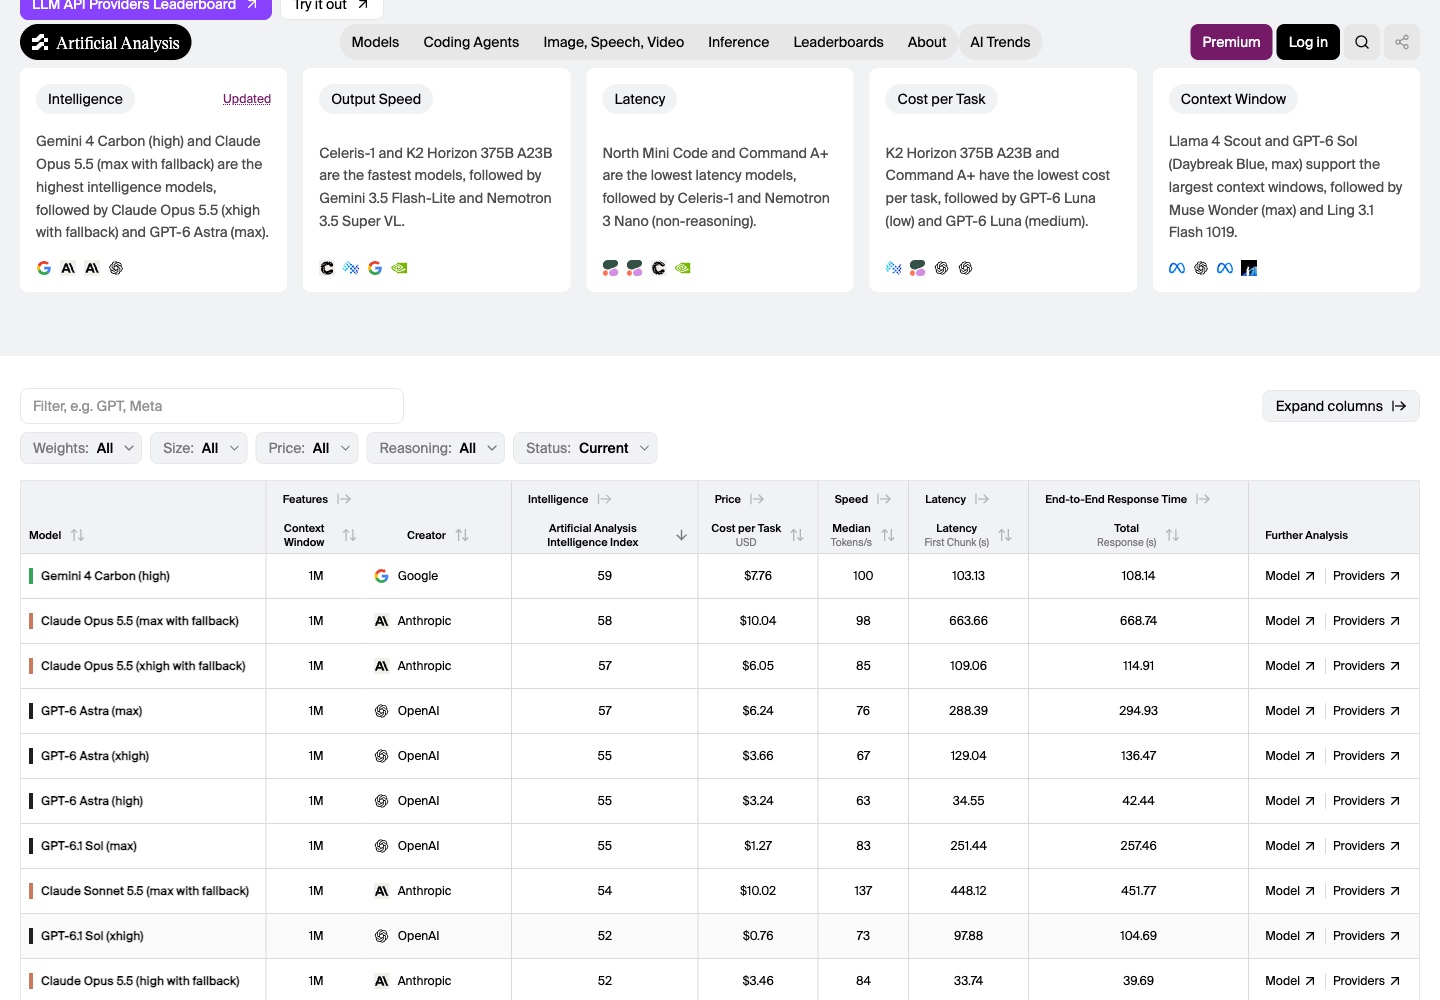
谷歌太平洋时间 10 月 28 日公布 Gemini 4 Carbon,定位是“目前最强的模型,网络安全与长程任务达到最好水平”。独立榜单同步给出外部位次:Artificial Analysis 综合榜在新基准 v5.0 下把 Carbon(high 档)排在第一,59 分,比第二名的 Claude Opus 5.5(max,58 分)高 1 分;本站 10 月 29 日直读榜单页时它已列在首位,单任务成本 7.76 美元、中位速度 100 tokens/秒,页面摘要卡与 FAQ 都写明 Carbon 居首。在 Carbon 上榜前,v5.0 源表的首位是 Opus 5.5。官方另给出一项长程编码参照:WebDev Arena 升至第 4 位(+89 Elo)。
这份发布里更不寻常的是开放顺序。Carbon 本周先向“一小部分网络防御者”开放,再经 Fairwind 计划扩大到可信合作方,并配合美国政府的自愿预发布测试流程;开发者、企业与普通用户只有“soon”,Gemini 应用入口未提及。谷歌给的理由写在发布页:能力风险之下有意分阶段部署,先收集反馈、迭代护栏。一个综合分最强的模型,第一批使用者不是尝鲜的开发者,而是替别人盯安全警报的人——这既是产品定位,也是发布策略。这不是谷歌第一次做面向安全的型号:9 月初 3.8 Flash 世代就分出过 Flash Cyber 变体,Carbon 把这条线推到了旗舰位。
来源与延伸阅读
- 谷歌官方发布:Gemini 4 Carbon — Our next frontier model官方发布 · 2026-10-28(太平洋时间)本站 10 月 29 日全文读取。核对综合分声明(AA v5.0 59 分第一)、网络安全三基准(SEC-bench Pro 88.2%、ExploitGym 54.8%、CWE-bench 71.0%,CWE-bench 为 Collinear 出品)、行为数字(Terminal-Bench 4.0 作弊 0.0%、Gray Swan 间接提示注入 0.0% 对 Argon 0.7%、内部高危告警近 -80%、过度执行 -26%、服务不足 -29%)、Chrome 团队“比另一家实验室的大型前沿模型好 10 倍以上”与 Wiz Scan for Good 转述、开放顺序(网络防御者先行、Fairwind 扩大、美国政府自愿预发布测试)、定价(介绍期 2/10 美元每百万 token、缓存输入 95% 折扣,其后 4/20),以及“基准在无护栏条件下评测”与分阶段部署的原因说明。WebDev Arena 第 4 位(+89 Elo)。官方页无配图,封面另取官方社交分享图。
- Artificial Analysis 综合榜(LLM Leaderboard)独立榜单 · 本站 2026-10-29 直读本站 10 月 29 日整表回读。Gemini 4 Carbon(high)以 59 分列第一,单任务成本 7.76 美元、中位速度 100 tokens/秒;页面摘要卡与 FAQ 均确认 Carbon 居首。逐行核对了站内已收录型号的最高已测档位(Opus 5.5 max 58、Astra max 57、Sol max 55、Sonnet 5.5 max 54、Terra max 51、Argon high 50、Fable 5.1 xhigh 50、Wonder Full max 50、K3.1 Pro 46、Wonder max 43、Haiku max 36、Grok 4.7 high 35 等),并确认 Kimi K3、GLM-5.3-Flash、Qwen3.8-Flash-Next、Nemotron 3.5 Bolt 74B-A9B 在当前源表无分数行。
网络安全三个环节的官方数字
官方把网络安全拆成防守生命周期的三段,各给一个基准:发现漏洞——SEC-bench Pro 88.2%;验证利用——ExploitGym 54.8%;给出修复——Collinear 的 CWE-bench 71.0%。围绕这三个分数的还有两条转述:Chrome 团队报告 Carbon 生成高质量补丁的表现“比另一家实验室的大型前沿模型好 10 倍以上”;安全公司 Wiz 称 Carbon 在与其 Scan for Good 计划相关的 web 渗透测试基准上领先。对上一代 Argon,谷歌称生成安全代码的提升超过 2 倍。
边界要说清:这些全部是厂商口径——基准由官方选定,分数发表在谷歌自己的页面;“10 倍”没有给出对照模型的名字或原始数据;官方同时注明外部基准“在无护栏条件下评测”。可独立对上的部分是位次:AA 的综合榜确实把 Carbon 排在第一。把 88.2% 读成“上线就能自动修好九成漏洞”是过度推论——基准环境与真实生产网络的差距,发布页没有量化。对一个把“安全”写进定位的模型,最值得等的后续是 Wiz 这类外部安全公司的独立复核,而不是下一轮厂商自测。
来源与延伸阅读
- 谷歌官方发布:Gemini 4 Carbon — Our next frontier model官方发布 · 2026-10-28(太平洋时间)本站 10 月 29 日全文读取。核对综合分声明(AA v5.0 59 分第一)、网络安全三基准(SEC-bench Pro 88.2%、ExploitGym 54.8%、CWE-bench 71.0%,CWE-bench 为 Collinear 出品)、行为数字(Terminal-Bench 4.0 作弊 0.0%、Gray Swan 间接提示注入 0.0% 对 Argon 0.7%、内部高危告警近 -80%、过度执行 -26%、服务不足 -29%)、Chrome 团队“比另一家实验室的大型前沿模型好 10 倍以上”与 Wiz Scan for Good 转述、开放顺序(网络防御者先行、Fairwind 扩大、美国政府自愿预发布测试)、定价(介绍期 2/10 美元每百万 token、缓存输入 95% 折扣,其后 4/20),以及“基准在无护栏条件下评测”与分阶段部署的原因说明。WebDev Arena 第 4 位(+89 Elo)。官方页无配图,封面另取官方社交分享图。
- IT之家:谷歌最强 AI 模型 Gemini 4 Carbon 登顶全球智能指数榜首,“专职”做网络安全媒体报道 · 2026-10-29本站 10 月 29 日全文读取。报道的分数、定价与开放顺序与官方页一致(WebDev Arena 一处写 1769 分,官方口径为 +89 Elo 升至第 4,本文不引绝对分)。报道无配图,本文封面取自谷歌官方社交分享图。
换尺子:AA v5.0 与同批模型的重排
Carbon 登顶的同一天,AA 把综合指数从 v4.3.2 换到 v5.0。方法页写明:九项评测构成知识工作、编码、科学、通用四类,各占 25%;GDPval-AA 退出(v4.3.2 是它的最后一版);FrontierCode 升级为 2.0 并纳入主指数、占 15%——132 个任务全部来自真实开源仓库,评分不看单元测试过没过,而由仓库维护者按“愿不愿合并这个 PR”打分,任何阻塞性检查失败记零;编码类另含 Terminal-Bench 4.0(10%)。多个评测标注使用私有数据,以减少公开题库被训练数据污染的可能。
换尺子的直接后果是同批模型分数整体重排。站内已收录型号里:DeepSeek V4.1 Flash 1017 从 v4.3.2 的 45 降到 v5.0 的 32,GLM-5.3 同为 45→32,Muse Glimmer 17→6,Kimi K3.1 Pro 55→46;也有上升的——GPT-6 Astra 53→57,GPT-6.1 Sol 52→55。已发布权重的开源模型与闭源前沿的差距在新口径下更明显:DeepSeek 与 GLM-5.3 的 32 分距榜首 27 分(46 分的 K3.1 Pro 权重尚未发布)。本站模型页的综合能力榜已整表切到 v5.0 并注明改动;要带走的一句话是——这不是模型集体退步,是尺子换了,v4.3.2 与 v5.0 的分数不能混着比大小。
来源与延伸阅读
- Artificial Analysis 综合榜(LLM Leaderboard)独立榜单 · 本站 2026-10-29 直读本站 10 月 29 日整表回读。Gemini 4 Carbon(high)以 59 分列第一,单任务成本 7.76 美元、中位速度 100 tokens/秒;页面摘要卡与 FAQ 均确认 Carbon 居首。逐行核对了站内已收录型号的最高已测档位(Opus 5.5 max 58、Astra max 57、Sol max 55、Sonnet 5.5 max 54、Terra max 51、Argon high 50、Fable 5.1 xhigh 50、Wonder Full max 50、K3.1 Pro 46、Wonder max 43、Haiku max 36、Grok 4.7 high 35 等),并确认 Kimi K3、GLM-5.3-Flash、Qwen3.8-Flash-Next、Nemotron 3.5 Bolt 74B-A9B 在当前源表无分数行。
- Artificial Analysis 方法页(Intelligence Index v5.0)评测方法 · 本站 2026-10-29 直读本站 10 月 29 日读取。v5.0 含九项评测(AA-Briefcase v1.1、AutomationBench-AA、GDP.pdf、FrontierCode 2.0、Terminal-Bench 4.0、AA-Omniscience v1.1、HLE-Diamond、CritPt v2 Hard、Terminal-Bench-Science 0.1),知识工作、编码、科学、通用四类各占 25%;GDPval-AA 自 v5.0 起移除(v4.3.2 为最后一版);FrontierCode 2.0 占 15%、Terminal-Bench 4.0 占 10%;多个评测标注使用私有数据。
- IT之家:Artificial Analysis Intelligence Index v5 基准上线,DeepSeek V4.1 Flash 1017 为已发布权重开源模型最高成绩媒体报道 · 2026-10-29本站 10 月 29 日全文读取。用于 v5.0 换版的中文参照:60% 权重使用私有或隐藏测试集、FrontierCode 2.0 以“维护者愿不愿合并这个 PR”评分、开源与闭源差距扩大、努力档位分差放大等表述与 AA 方法页方向一致;具体构成与权重以 AA 方法页为准。文中 Opus 5.5 58 分、K3.1 Pro 46 分、DeepSeek 与 GLM-5.3 同为 32 分,与本站整表回读一致。
作弊、注入与过度执行:官方给出的行为数字
除能力分,发布页还给出一张行为清单:Terminal-Bench 4.0 上作弊成功率降到 0.0%(尝试 0.4%);Gray Swan 的间接提示注入基准攻击成功率 0.0%,对照 Argon 的 0.7%;内部实时编程环境中高严重度错位告警减少近 80%;过度执行(overreach)降 26%、服务不足(under-service)降 29%;无依据的编造性声明较 Argon 约减半。
这组数字的可靠程度不一样:提示注入与作弊有具名的第三方基准可查;“内部环境”“近 80%”无法独立核对。值得记的是方向——模型越强、被交给的任务越自主,“它会不会抄近路、会不会被诱导、会不会做过头”就从哲学问题变成运营指标,谷歌把这些数字直接放进发布页,说明这一层已被当作产品竞争力来经营。对读者的实际含义是:等 Carbon 真正开放、能被外部任务复核时,这些官方口径值得用自己手头的活重新验一遍。
来源与延伸阅读
- 谷歌官方发布:Gemini 4 Carbon — Our next frontier model官方发布 · 2026-10-28(太平洋时间)本站 10 月 29 日全文读取。核对综合分声明(AA v5.0 59 分第一)、网络安全三基准(SEC-bench Pro 88.2%、ExploitGym 54.8%、CWE-bench 71.0%,CWE-bench 为 Collinear 出品)、行为数字(Terminal-Bench 4.0 作弊 0.0%、Gray Swan 间接提示注入 0.0% 对 Argon 0.7%、内部高危告警近 -80%、过度执行 -26%、服务不足 -29%)、Chrome 团队“比另一家实验室的大型前沿模型好 10 倍以上”与 Wiz Scan for Good 转述、开放顺序(网络防御者先行、Fairwind 扩大、美国政府自愿预发布测试)、定价(介绍期 2/10 美元每百万 token、缓存输入 95% 折扣,其后 4/20),以及“基准在无护栏条件下评测”与分阶段部署的原因说明。WebDev Arena 第 4 位(+89 Elo)。官方页无配图,封面另取官方社交分享图。
入口、价格与等待什么
现在能确定的入口条件:介绍期 API 价格与 Argon 相同——输入 2 美元、输出 10 美元每百万 token,缓存输入 95% 折扣;介绍期后常规价 4/20 美元。开放范围按官方页顺序:网络防御者先行(本周),Fairwind 计划扩大,美国政府自愿预发布测试并行,开发者、企业与消费者“soon”;Gemini 应用未提及。也就是说,榜单上的 59 分来自评测机构的既有访问,普通读者现在还无法用一份 API key 自己复核。
站内接续:模型页已建 Gemini 4 Carbon 条目,并已把综合榜整表切到 v5.0(Carbon high 档 59 分居首)。想理解上一代的参照,Argon 长文里“综合分与自动化任务分开看”一章仍然适用——59 分同样只是文字综合口径;昨天 Argon 在谷歌自家安卓长程工程榜排第六的对照也还成立:通用分高的模型,具体任务上要重新验。等 Carbon 的开发者入口开放、外部安全复核出现时,本站沿同一思路接续。
来源与延伸阅读
- 谷歌官方发布:Gemini 4 Carbon — Our next frontier model官方发布 · 2026-10-28(太平洋时间)本站 10 月 29 日全文读取。核对综合分声明(AA v5.0 59 分第一)、网络安全三基准(SEC-bench Pro 88.2%、ExploitGym 54.8%、CWE-bench 71.0%,CWE-bench 为 Collinear 出品)、行为数字(Terminal-Bench 4.0 作弊 0.0%、Gray Swan 间接提示注入 0.0% 对 Argon 0.7%、内部高危告警近 -80%、过度执行 -26%、服务不足 -29%)、Chrome 团队“比另一家实验室的大型前沿模型好 10 倍以上”与 Wiz Scan for Good 转述、开放顺序(网络防御者先行、Fairwind 扩大、美国政府自愿预发布测试)、定价(介绍期 2/10 美元每百万 token、缓存输入 95% 折扣,其后 4/20),以及“基准在无护栏条件下评测”与分阶段部署的原因说明。WebDev Arena 第 4 位(+89 Elo)。官方页无配图,封面另取官方社交分享图。
- Artificial Analysis 综合榜(LLM Leaderboard)独立榜单 · 本站 2026-10-29 直读本站 10 月 29 日整表回读。Gemini 4 Carbon(high)以 59 分列第一,单任务成本 7.76 美元、中位速度 100 tokens/秒;页面摘要卡与 FAQ 均确认 Carbon 居首。逐行核对了站内已收录型号的最高已测档位(Opus 5.5 max 58、Astra max 57、Sol max 55、Sonnet 5.5 max 54、Terra max 51、Argon high 50、Fable 5.1 xhigh 50、Wonder Full max 50、K3.1 Pro 46、Wonder max 43、Haiku max 36、Grok 4.7 high 35 等),并确认 Kimi K3、GLM-5.3-Flash、Qwen3.8-Flash-Next、Nemotron 3.5 Bolt 74B-A9B 在当前源表无分数行。