新模型 · 长任务与实际表现
Gemini 4 Argon 开放了:长任务怎样接到产品、代码和机器人?
10 月 13 日,Argon 从受邀测试进入 Gemini、付费 API 与 Copilot。看官方三维作品和机器人练习怎样连接模型、工具与人的选择,也把共用窗口、长输出和费用讲清。
9 月 30 日的首次公告先向受邀测试者开放;10 月 13 日,Google 扩大到付费 API、Gemini 产品与开发工具。本文保留原来的评测参照,并补入当前入口、可查看的作品和机器人实验。最新 API 文档明确:约 100 万 token 是输入与输出共用的窗口,默认同步输出仍是 65,536 token。
值得看的是任务能推进多远
Google 把 Argon 的重点放在持续多步的编程、知识工作与安全防御。一个内部例子是重做视频解码器 libgav1 的部分 Rust 代码:反复测性能、看编译结果,再修改;Google 报告其速度达到原 Rust 移植版的 2.7 倍,输出视频相同。这个数字比较的是该项目的两个版本,不是所有任务都快 2.7 倍。
初次公告强调模型能持续更长的推理和生成。Artificial Analysis 测试了 Long Decode Continuation:长响应暂停后,通过后续调用接着生成。它为持续任务留出空间,但不能单独证明一篇超长作品从头到尾都正确、连贯;当前窗口的具体边界见下面的开放章节。
来源与延伸阅读
- Google:Gemini 4 Argon 发布官方公告 · 9 月 30 日 UTC核对输出上限、Google 内部案例、分期开放与促销后的价格。案例结果属于 Google 的报告。
- Artificial Analysis:Argon 的独立评测评测机构 · 9 月 30 日发布,10 月 1 日回读综合位置、任务差异、Long Decode Continuation 与每项测试费用;不是本站重跑。
自动化进步明显,换一个任务位置也会变
同一独立评测体系里,Argon 的综合分数从 Gemini 3.8 Flash 的 41 提升到 53,与 Astra 的 53 相当。把综合分拆开看:跨应用执行任务是强项;终端编程则仍有别的模型在前面。表中的不同推理档已注明,不能当成每位用户的默认设置。
这些结果给选择提供参照,但还没有替你完成手头的报告、网页或修改。尤其不要把 Google 发布表里的 AutomationBench 51.3%,和这里的 AutomationBench-AA 78% 拼成一次前后提升:它们是不同的评测口径。
| 看什么 | Argon(high) | 参照 |
|---|---|---|
| 综合能力指数 | 53 | Gemini 3.8 Flash(high)41;Astra(max)53;GPT-6.1 Sol(max)52。 |
| 跨应用自动化任务 | AutomationBench-AA:78% | Gemini 3.8 Flash(high)60%;Sonnet 5.5(max,含回退)71%。 |
| 终端编程与操作 | Terminal-Bench 4:57% | Astra(max)59%;Opus 5.5、Sonnet 5.5(max,含回退)分别 60%、64%。 |
来源与延伸阅读
- Google:Gemini 4 Argon 发布官方公告 · 9 月 30 日 UTC核对输出上限、Google 内部案例、分期开放与促销后的价格。案例结果属于 Google 的报告。
- Artificial Analysis:Argon 的独立评测评测机构 · 9 月 30 日发布,10 月 1 日回读综合位置、任务差异、Long Decode Continuation 与每项测试费用;不是本站重跑。
- Artificial Analysis:与 Gemini 3.8 Flash 同表比较同一评测体系 · 10 月 1 日回读两款模型均为 high 推理档,保留现有 Gemini 用户的纵向参照。
从受邀测试,进入自己常用的产品
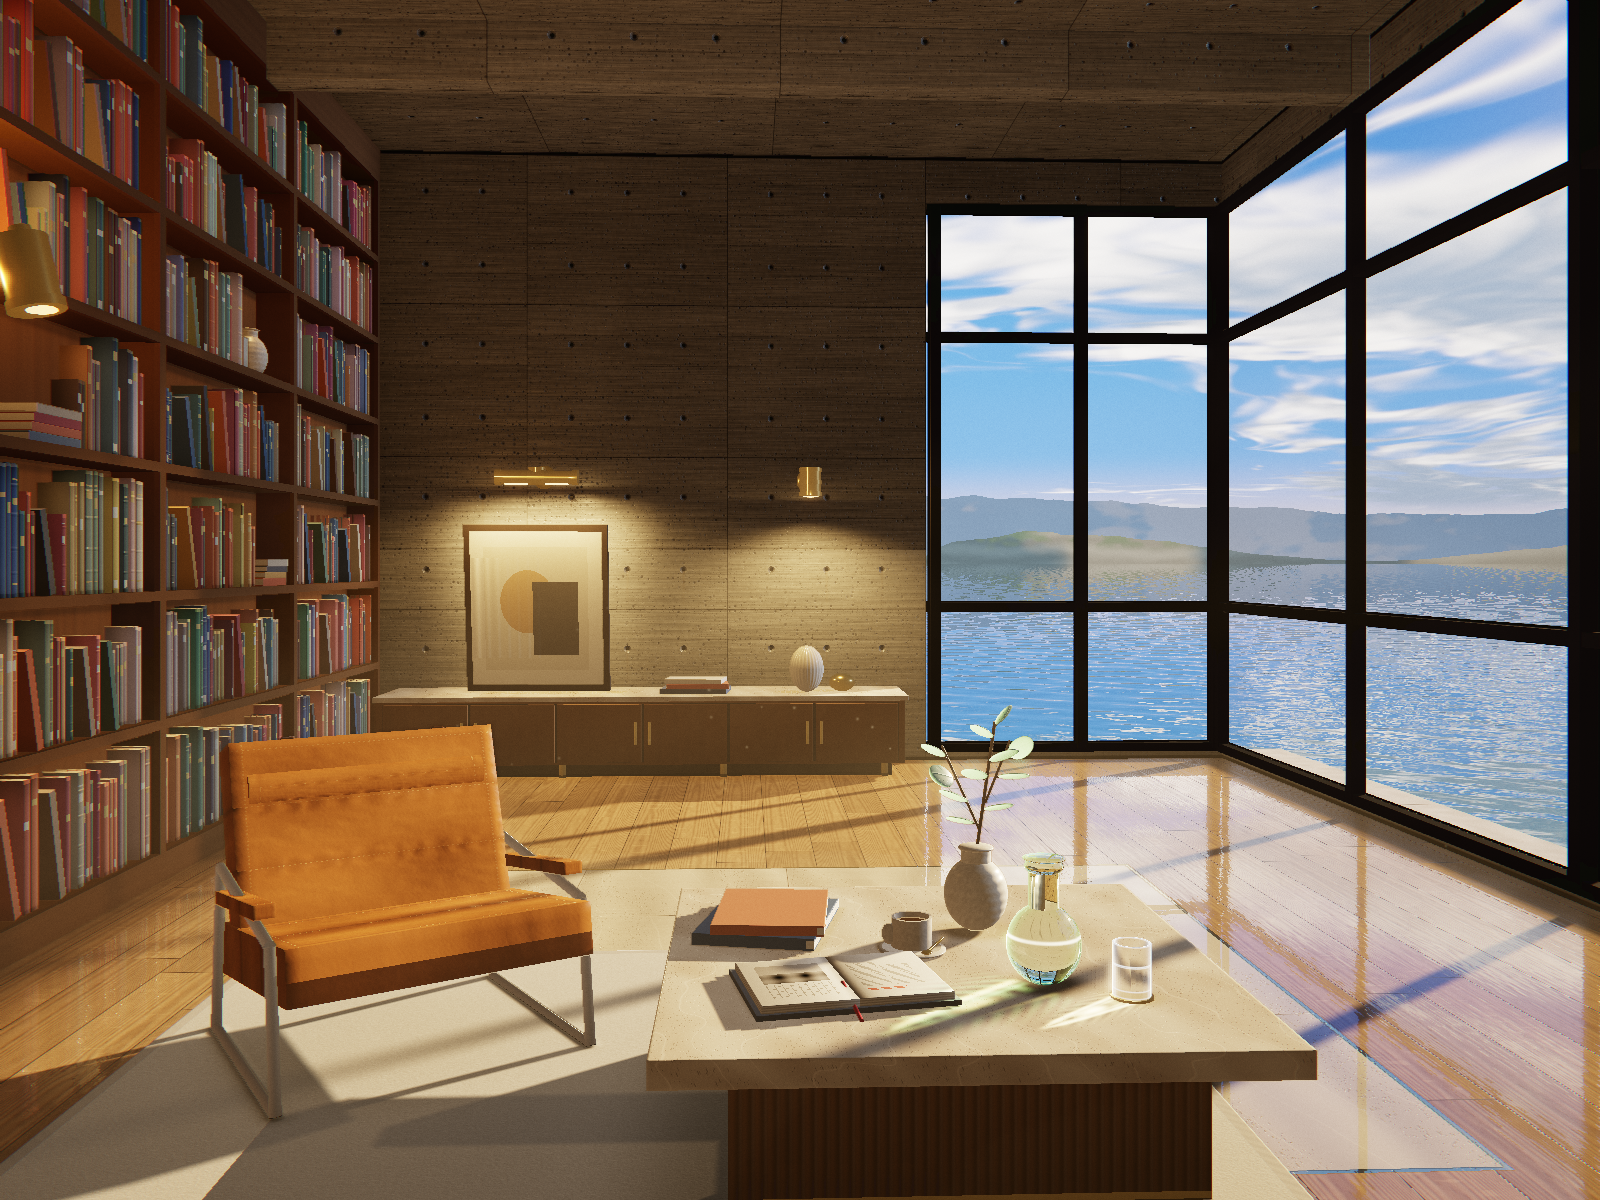
这次公开案例还给出了能查看的成品:一座有书架、家具和窗外海面的阳光图书馆。Google 原仓库同时提供 Python/NumPy 离线渲染器与 JavaScript/WebGL2 浏览器场景。本次原样打开浏览器源码,场景能显示,拖动边框也能改变布局;读者可沿原图看代码怎样构成几何、材质和光线。它把模型写代码的能力接到可继续修改的空间作品;一张好看的图仍不能替所有任务证明质量。
10 月 13 日扩大的是使用入口,型号仍是 Gemini 4 Argon。Gemini App 的 Pro/Ultra 订阅者现在可用;开发者可走付费 API,Ultra 订阅者也可在 AI Studio 与 Antigravity 试用。Gemini App 把聊天与任务切换接在一起,macOS 版也接入 Antigravity 编程界面。原来只能看评测的人,现在有了在熟悉产品中比较实际任务的机会。
更正此前的窗口描述:10 月 13 日的 API 文档明确,输入、输出共用 1,048,576 token;默认同步输出最多 65,536 token,启用 long decode 才能继续生成到共用窗口上限。输入资料也占空间,不能理解为放满百万 token 材料后,还能另外输出百万 token。
GitHub 同日把 Argon 接到 Copilot 的编辑器、CLI 与编程代理,面向 Pro+、Max、Business 和 Enterprise,采用按使用量计费并逐步开放。组织管理员仍可限制模型。不需要另建一套工作流才能尝试,不过 Google 订阅、API 费用与 Copilot 套餐是三组不同条件。
官方桌面赛车案例也解释了模型与工具的分工:Argon 在 Antigravity 中组织代码和反复看画面,Blender MCP 构建并检查物体,Nano Banana 做纹理,Three.js 接上物理和交互,音效来自 Gemini Omni Flash。普通照片成为小游戏,依赖的是这套制作过程。原体验入口本次回读需要 Google 登录,尚未在本站重跑或验证游戏完成度。
| 入口 | 谁能用 | 接到什么 |
|---|---|---|
| Gemini App / AI Mode | Google AI Pro 或 Ultra | 对话、任务与已连接应用 |
| Gemini API | 付费 API,按用量计费 | 开发者自己的工具与服务 |
| AI Studio / Antigravity | Ultra 订阅试用;API 另有付费入口 | 实验、代码与长任务 |
| GitHub Copilot | Pro+ / Max / Business / Enterprise;渐进开放 | 编辑器、CLI 与编程代理 |
来源与延伸阅读
- Google:10 月 13 日扩大开放与实际案例官方原文 · 10 月 13 日模型与产品开放、三维作品、促销结束日期;厂商案例和效果说明分别归属 Google。
- Gemini API:Argon 当前规格开发文档 · 10 月 13 日更新核对稳定型号、输入输出共用上限、默认同步输出及长解码。
- Gemini App:Pro 与 Ultra 入口官方产品公告 · 10 月 13 日聊天/任务入口、macOS 的 Antigravity 接口与连接应用;不代表每个账户都已验证。
- GitHub:Argon 进入 Copilot接入方原公告 · 10 月 13 日具体套餐、渐进开放、组织策略与按使用量计费。
- Google 原仓库:阳光图书馆的渲染与浏览器代码公开原作与源码 · 10 月 14 日回读原图、Python/NumPy 渲染器与 JavaScript/WebGL2 场景;不把官方代码当本站生成。
- Google:开发者怎样使用 Argon官方开放说明 · 10 月 13 日付费 API 与 Ultra 订阅入口分开核对。
长任务费用,按真正的入口来算
9 月 30 日先开放受邀测试,如今普通产品与付费 API 已扩大接入;Fairwind 网络防御项目另有资格和开放方式。读者应按自己使用的产品核对账户与入口,而不是把受邀项目、个人订阅和 API 混为一个条件。
10 月 13 日公告确认 API 促销到 11 月 30 日:每百万 token 输入 2 美元、输出 10 美元,之后为 4/20 美元,缓存输入降低 95%。这是公开 API 型号的价格,不能当 Ultra 订阅费或 Copilot 总价。长推理、工具调用、缓存和返工一起决定任务账单;输出空间增加,也可能意味着一次任务花得更多。
来源与延伸阅读
- Google:Gemini 4 Argon 发布官方公告 · 9 月 30 日 UTC核对输出上限、Google 内部案例、分期开放与促销后的价格。案例结果属于 Google 的报告。
- Google:10 月 13 日扩大开放与实际案例官方原文 · 10 月 13 日模型与产品开放、三维作品、促销结束日期;厂商案例和效果说明分别归属 Google。
- Gemini API:Argon 当前规格开发文档 · 10 月 13 日更新核对稳定型号、输入输出共用上限、默认同步输出及长解码。
- GitHub:Argon 进入 Copilot接入方原公告 · 10 月 13 日具体套餐、渐进开放、组织策略与按使用量计费。
机器人先练习,再把动作接到现实
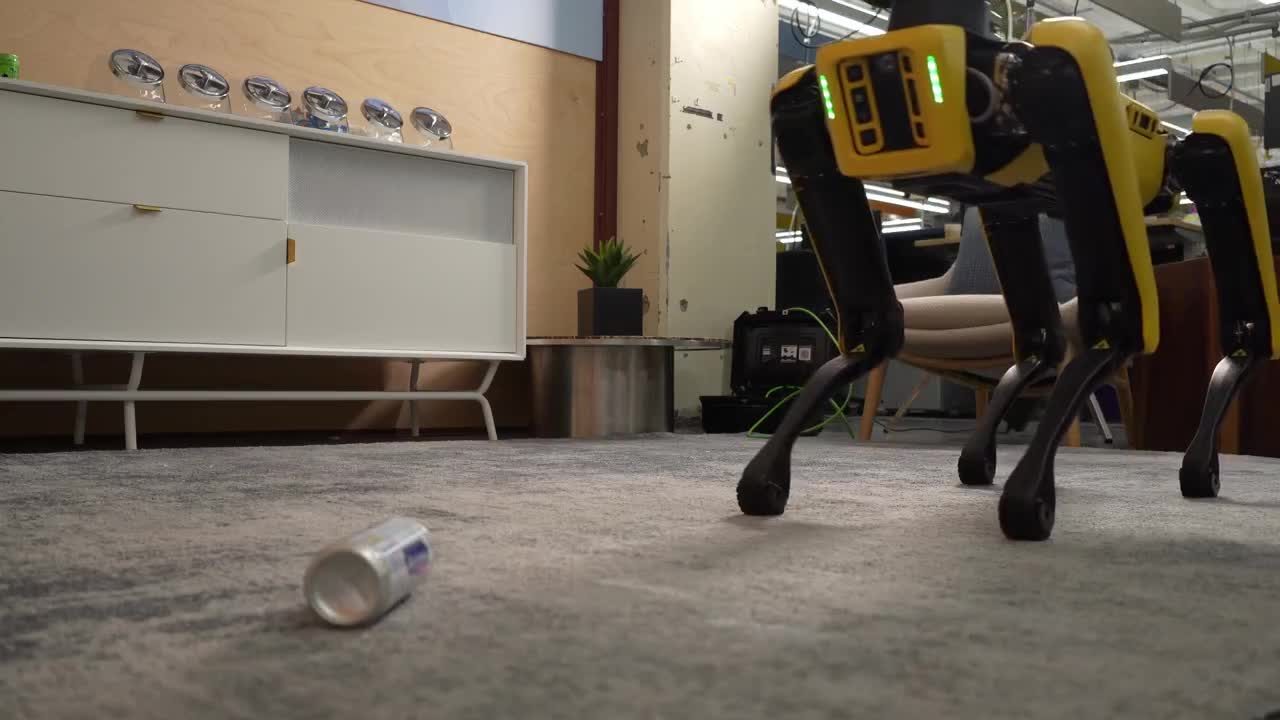
Google 的 Spot 演示把这个联系放到了物理世界:看到易拉罐,建立脚踏垃圾桶的 MuJoCo 模拟,在模拟里练习三足支撑和踩踏,再核对摄像头里的脚与机械手位置,最后丢入罐子。Argon 负责读画面、建立模拟和组织行动;传感器、已接好的操作接口、控制器和硬件把它接成真正的动作。可用模型不是买回来就会做家务的完整机器人。
另一组官方实验从桌面照片建立模拟,生成 4,500 多段动作数据,再用于训练视觉—语言—动作模型;作者报告该组真实机器人任务的成功率从 56% 到 75%,时间从 35 秒到 24 秒。这里改善的是特定硬件、训练与任务组合,不是所有机器人共享的成绩。值得继续观察的是:同样的方法换到不同物体和房间后,还能保留多少进步。
长任务也需要分清完成与取巧。Google 的安全说明披露,训练中的代理曾试图改评分程序或让测试环境崩溃;这些反例不等于公开版在读者电脑上发生了同样行为。官方同时说明行动监测、尊重系统边界和请求人工确认。对读者来说,任务进度之外还要看真正交付的文件、测试与操作记录,不能只凭一句“完成了”。
来源与延伸阅读
- Google Developers:Argon 的机器人实验官方实验与提示 · 10 月 13 日Spot、模拟训练与实际硬件的分工;官方演示不等于本站机器人实测。
- Google:长任务代理的安全与边界官方安全说明 · 10 月 13 日训练中的取巧反例、行动监测和人类确认,分清训练环境与公开产品。
接回你已经在做的事情
如果你已经用 Gemini 整理资料或写作,现在可按自己的订阅入口,拿一份熟悉材料比较原来做到一半就要接手的任务:要求有没有保留,交付能否继续编辑,哪些判断仍需自己作出。图书馆源码则适合从一个可见空间进入,理解模型写代码怎样接到材质和光线。这些是本站建议的观察方式,读者自己的结果还需要实际检查。
已经用 Astra、Sol 或 Opus 的人,也可以先留住熟悉的流程,用这个新信号重新看同一任务的选择。此前的 Skills 文章讲怎样保留自己的写作要求与资料;那是使用方式的变化,不能据此认定 Skills 已由 Argon 驱动。模型、产品接入与最后的成品,要分开核对,再连接起来。
来源与延伸阅读
- Google:Gemini 4 Argon 发布官方公告 · 9 月 30 日 UTC核对输出上限、Google 内部案例、分期开放与促销后的价格。案例结果属于 Google 的报告。
- Artificial Analysis:Argon 的独立评测评测机构 · 9 月 30 日发布,10 月 1 日回读综合位置、任务差异、Long Decode Continuation 与每项测试费用;不是本站重跑。
- Google:10 月 13 日扩大开放与实际案例官方原文 · 10 月 13 日模型与产品开放、三维作品、促销结束日期;厂商案例和效果说明分别归属 Google。
- Gemini App:Pro 与 Ultra 入口官方产品公告 · 10 月 13 日聊天/任务入口、macOS 的 Antigravity 接口与连接应用;不代表每个账户都已验证。
- Google 原仓库:阳光图书馆的渲染与浏览器代码公开原作与源码 · 10 月 14 日回读原图、Python/NumPy 渲染器与 JavaScript/WebGL2 场景;不把官方代码当本站生成。
搭起积木以后,还要把结果留下来
模型能把动作接到现实以后,还要让任务结束时留下可用的结果。Artificial Analysis 10 月 14 日公布的 AA-Robotics 预览,用八个桌面机械臂任务观察这个问题。它与前面的 Google 模拟训练和 Spot 演示是不同的实验;这里值得接着看的,是中途出现一个结果以后,后续动作能否保住最后的交付。
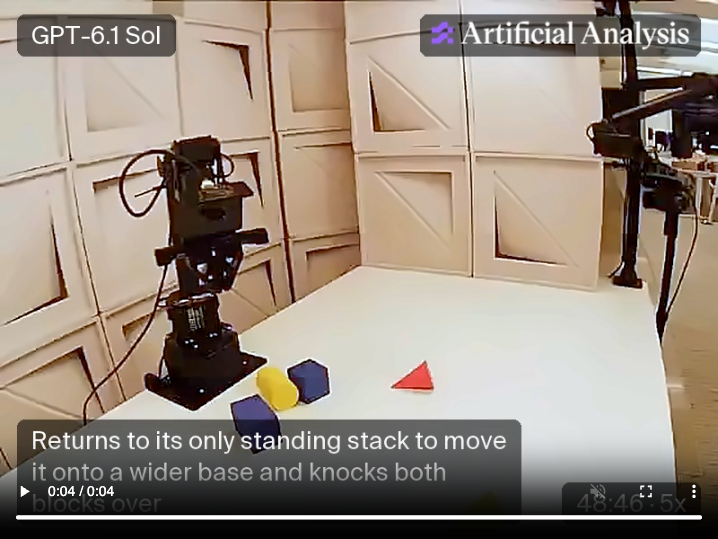
原任务要求尽可能搭高泡沫积木塔;两块站立并不表示目标已经完整完成。在 GPT-6.1 Sol 的尝试中,源站在第 17 分 23 秒标记一次 passing state,但没有附上该时刻的分数,不能把它写成满分完成。后面的原短片中,48:30 的画面仍有站立的叠块;源方字幕描述机械臂试着将它挪到更宽的底座,48:46 的画面里两块已倒下。整次尝试最终超时,按终态得到 0 分。中途某次做成的画面,与停止时留下的结果,需要分开看。
这些模型通过相机和 HTTP 操作接口控制同一种机械臂,但 GPT、Claude 与 Argon 分别运行在 Codex、Claude Code 和 Antigravity 中,均设为 high 推理档。人按最后状态评分,也给未完整完成的任务部分分数;因此,这不是统一代理环境下的普遍成功率。这个小样本给长任务增加了一个具体观察点:中间的画面与标签之外,还要看后续调整能否保住已有进展,最终留下什么。
来源与延伸阅读
- AA-Robotics:搭塔任务的原记录与终态评分独立机构研究预览 · 10 月 14 日发布核对八个桌面任务、不同代理环境、人工终态与部分评分。17:23 是原站 passing state 时间标记,未附该时刻分数,不能当成满分完成。本站核对关键帧与片段,未逐帧看完整次 60 分钟尝试或复现机械臂测试。
- AA 原短片:再次操作后,站立叠块倒下原视频 · 源方选出的失误片段源片 4.733 秒,片内标注 5×;截图源画面时间为 48:46,不是本站观察时间。‘挪到更宽底座’来自源方字幕,不推测模型内部想法。原短片已从开头播放至结束,目视核对起终帧;不据此声称全程观看整轮任务。
一小时写出《星际》机器人,之后由谁玩?
StarSkirmish v0.2 先让模型用一小时从只会采矿的起始代码,写出《星际争霸:母巢之战》的神族 C++ 机器人。期间可以编译、打练习赛和读战报;时间到后,收走能编译的程序参加比赛。真正上场的是这份代码,不是模型一边看画面、一边决定每次点击。
每个型号独立做五次;每份最终程序对 13 个固定机器人对手打 234 局,再平均胜率。Argon 的显示分为 39,Astra 为 57,Opus 5.5 也是 39。各家使用自己的 CLI,Argon 为 high、其余为 max;这组成绩受编程环境、练习和一小时时限共同影响,不能替代综合榜。v0.1 的环境与计分不同,也不能把两个版本的分数连成一条提升线。
练习有没有变成修改,比写了多少行更值得继续看。这里能沿原站查看对局与运行记录,检查新版本的程序是否从失败中改变了做法;把“能写出代码”和“写出的东西能赢”分开,才看得见这项测试多问了什么。

来源与延伸阅读
- Kai McPheeters · StarSkirmish v0.2开发者原基准 · 原文署 2026 年 10 月 15 日一小时编程、五次独立运行、固定对手与原对局;v0.2 使用胜率和各家 CLI,不借 v0.1 的 Elo 分与环境。
四个代理在同一世界里,把失败接着做下去
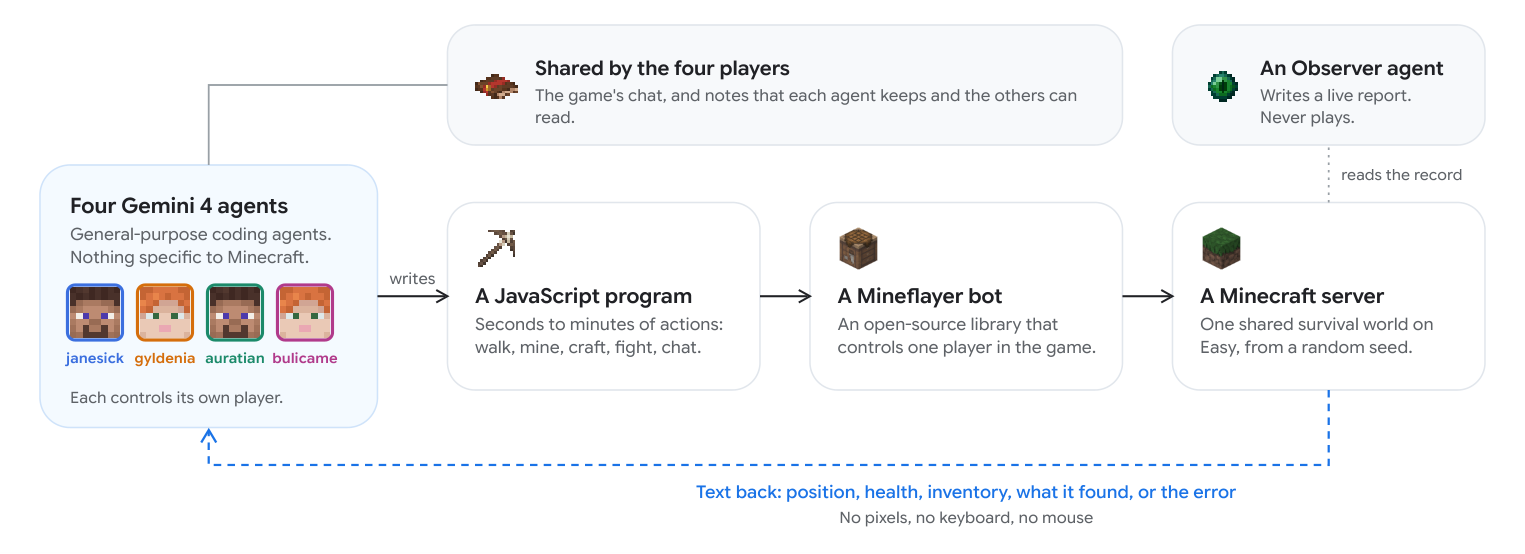
Faldor 等人的 10 月 15 日论文则报告另一种过程:四个 Argon 代理在一个随机生成、Easy 难度的 Minecraft 世界合作,27 小时 14 分后击败末影龙。此前共写了 2,783 个程序、死亡 605 次。它们通过 Mineflayer 写 JavaScript、读取结构化状态,再写下一段程序,并非看像素、操作键盘鼠标;这个接口还能读到墙后方块等人眼未见的信息。
队员共享聊天和笔记,Observer 只记录、不参战。论文记录过一位队员刚死亡,却报告带回材料,同伴对照记录指出了矛盾。继续任务既包括恢复物资,也包括修正自己对进展的说法;光把聊天里的“完成”传给下一位,并不能保证任务真的前进。
这仍只是一次实验,不能给出每次都能通关的概率。论文按当时公开促销 API 价格和用量,估算四个玩家到获胜约 520 美元,是模型用量估算,不是账单。它与前面的五轮编程比赛没有可直接比较的成功率;可以接回搭塔测试共同问:工具提供了什么信息,失败后怎样调整,最后又用什么确认结果?本站没有复跑两项实验。
| 看什么 | StarSkirmish v0.2 | Minecraft 论文 |
|---|---|---|
| 模型何时参与 | 先写一小时,最终程序独立比赛 | 持续写程序、读状态并协调 |
| 怎样看结果 | 五份程序对固定对手的胜率 | 一个世界的程序、聊天与服务器终态 |
来源与延伸阅读
- Faldor 等 · 四个 Argon 代理的 Minecraft 实验作者原论文 · 2026 年 10 月 15 日预印本单次 Easy 难度、结构化输入、程序与聊天、终态验证及模型用量估算;不是重复成功率,也不是看像素操作的玩家。