模型与接入
谷歌的安卓编程榜更新:Gemini 4 Argon 首秀排第六
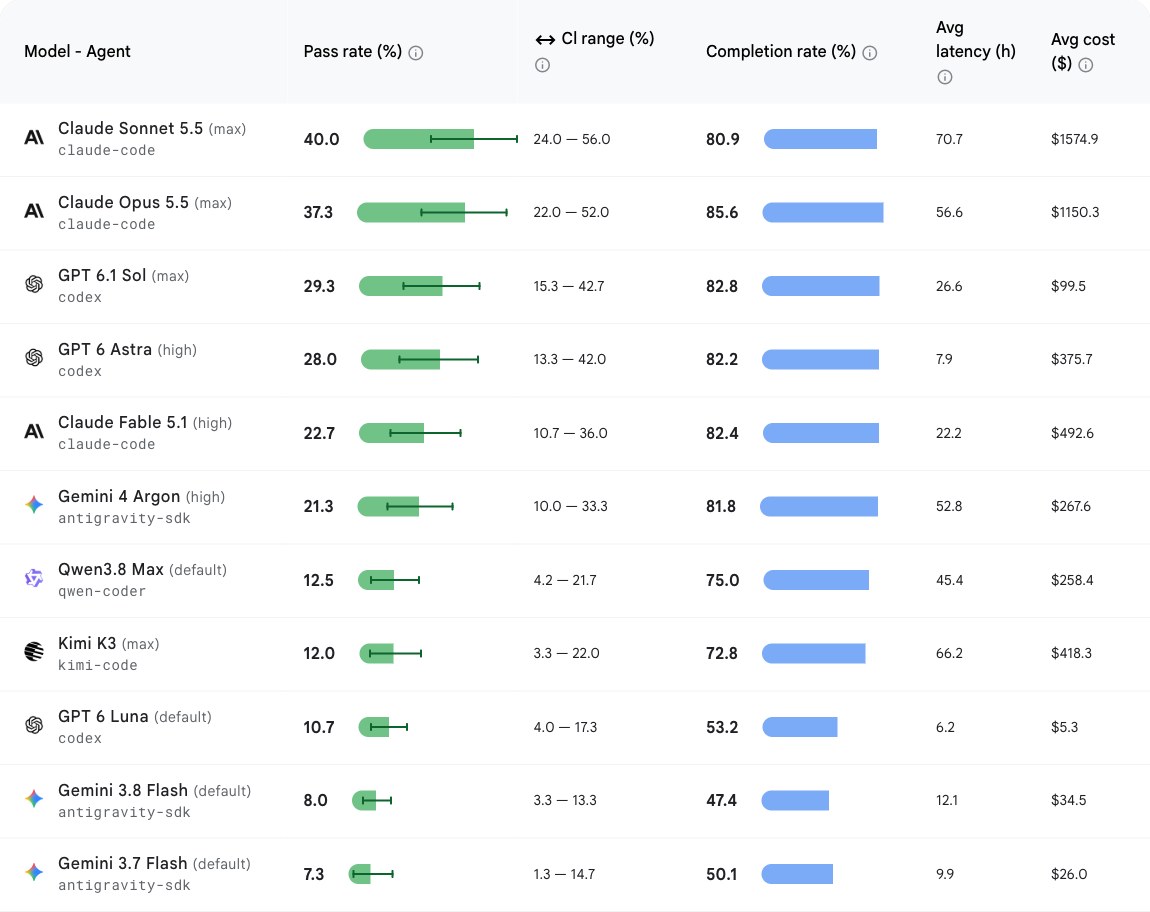
谷歌 10 月 26 日更新 Android Bench 2.0:结果开始标注推理等级,Claude Sonnet 5.5、GPT-6.1 Sol 与 Gemini 4 Argon 三个新组合上榜。Argon 首秀通过率 21.3%,在 11 个模型·agent 组合里排第六——站内 AA 综合榜记录里它与 Sonnet 5.5 只差 3 分(53 对 56),这份安卓长程任务榜上差距拉到近一倍(21.3 对 40.0)。与前一名 Claude Fable 5.1 的差距落在重叠的置信区间内;单轮成本 267.6 美元、平均耗时 52.8 小时。数字为谷歌官方口径,本站 10 月 28 日直读官方页,未复跑测试。
本文依据 Android Bench 官方榜单页(developer.android.com/bench,本站 10 月 28 日直读,页面标注最新结果截至 10 月 26 日)与 IT之家 10 月 28 日报道整理;全部数字为谷歌官方口径,本站未运行任何模型或 agent。正文榜单图为本站自官方页截取;封面为官方品牌图,经报道页面转载。
10 月 26 日这次更新改了什么
Android Bench 是谷歌为安卓开发做的工程基准。2.0 版的“长程任务”把 30 个任务放在真实仓库上:给一个“模型+agent”组合提需求,让它在真正的安卓项目里完成功能、迁移或修整——任务取自 Signal、Bitwarden、WordPress、Pocket Casts、Now in Android、Food Vibes、Fossify File Manager 这些真实应用,分迁移(13)、应用创建(10)、新功能(5)和应用转换(2)四类,每个任务跑 5 次。页面对每个组合给五个数:通过率(30 个任务在所有 run 里成功解决的平均百分比)、置信区间(p 值小于 0.05)、完成率(即使失败,离完整方案有多近)、平均耗时(跑完 30 个任务的小时数)和单轮平均成本。
10 月 26 日的更新有三件事,官方 Changelog 写得明白:结果开始标注所用推理等级;三个新组合上榜——claude-code 跑 Claude Sonnet 5.5、antigravity-sdk 跑 Gemini 4 Argon、codex 跑 GPT 6.1 Sol;同时归档了 Claude Sonnet 5 与 GPT 6 Sol(后者 10 月 6 日才加入,被 6.1 Sol 接替)。长程任务榜现在有 11 行。IT之家 10 月 28 日的报道把这些数字带到了中文读者面前,但两处与官方页对不上:报道说 Argon“排在第五位”,官方 11 行里它是第六;报道把 GPT-6 Sol 列入本轮新增,官方 Changelog 记的是 10 月 6 日加入、10 月 26 日归档。本文一律按官方页记。
来源与延伸阅读
- Android Bench 2.0 官方榜单页(Android Developers)官方榜单 · 页面标注最新结果截至 10 月 26 日本站 10 月 28 日直读。核对长程任务榜全部 11 行(模型·推理等级·agent、通过率、置信区间、完成率、平均耗时、单轮成本)、五个指标的官方定义、Changelog(9 月 17 日上线长程任务与 agent 口径;10 月 6 日加入 Opus 5.5 与 GPT 6 Luna/Sol、归档 Opus 5 与 GPT 5.6 三档;10 月 26 日标注推理等级、加入 Sonnet 5.5/Argon/GPT 6.1 Sol、归档 Sonnet 5 与 GPT 6 Sol)、任务类别构成,以及展开的逐任务结果(Flutter 转安卓任务全部 0/5 等)。页面另有 1.0 任务结果存档(100 任务、9 月世代模型),与 2.0 口径不混算。
- IT之家:谷歌更新 Android Bench 榜单,Gemini 4 Argon 编程能力大幅落后于 Claude 与 GPT媒体报道 · 10 月 28 日 10:09本站 10 月 28 日全文读取。本轮发现线索,并提供了榜单与品牌配图(封面官方品牌图取自该报道页面)。两处与官方页不一致已在正文按官方页更正:报道称 Argon“排在第五位”,官方 11 行中为第六;报道把 GPT-6 Sol 列入本轮新增,官方 Changelog 记录其为 10 月 6 日加入、10 月 26 日归档(由 GPT 6.1 Sol 接替)。报道另转述官宣后的“内部消息”——该模型难以处理部分编程任务。
Argon 首秀:21.3%,11 里的第六
Argon 的首秀成绩:通过率 21.3%(置信区间 10.0–33.3),完成率 81.8%,平均耗时 52.8 小时,单轮成本 267.6 美元——推理档位标注为 high,跑在谷歌自家的 antigravity-sdk 上,11 个组合里排第六。榜首 Claude Sonnet 5.5(max)是 40.0%,第二名是同门 Claude Opus 5.5(37.3%)。要先说清的是:与前一名 Claude Fable 5.1(22.7%)的差距,落在两个组合互相重叠的置信区间里——按官方 p<0.05 的口径,这一名之差算不上确定的强弱;“大幅落后”成立的地方是前两名对身后:40.0 对 21.3,接近两倍。
把这张表放进站内已有的线索里,分化点就很具体。站内 AA 综合能力榜的记录里(10 月 27 日观察),Argon 的 53 分与 Claude Fable 5.1、GPT-6 Astra 同档,距 Sonnet 5.5 的 56 只差 3 分——综合分上它们是近邻。换到这份安卓长程榜:Sonnet 5.5 是 40.0,Argon 是 21.3,差距拉到近一倍;倒是 Astra(28.0)与 Fable 5.1(22.7)仍与 Argon 相邻。也就是说,综合分接近的一批模型,在“真实仓库里做长程工程”这一类任务上被拉开了——被拉开最远的是 Argon 对 Claude 前两代旗舰。官宣后曾有“难以处理部分编程任务”的内部消息流传(IT之家转述),现在这有了一份公开的、谷歌自己给出的数字。
| 模型(推理等级)· agent | 通过率 · 置信区间 | 完成率 | 平均耗时 | 单轮成本 |
|---|---|---|---|---|
| Claude Sonnet 5.5(max)· claude-code | 40.0 · 24.0–56.0 | 80.9 | 70.7 h | $1574.9 |
| Claude Opus 5.5(max)· claude-code | 37.3 · 22.0–52.0 | 85.6 | 56.6 h | $1150.3 |
| GPT 6.1 Sol(max)· codex | 29.3 · 15.3–42.7 | 82.8 | 26.6 h | $99.5 |
| GPT 6 Astra(high)· codex | 28.0 · 13.3–42.0 | 82.2 | 7.9 h | $375.7 |
| Claude Fable 5.1(high)· claude-code | 22.7 · 10.7–36.0 | 82.4 | 22.2 h | $492.6 |
| Gemini 4 Argon(high)· antigravity-sdk | 21.3 · 10.0–33.3 | 81.8 | 52.8 h | $267.6 |
| Qwen3.8 Max(default)· qwen-coder | 12.5 · 4.2–21.7 | 75.0 | 45.4 h | $258.4 |
| Kimi K3(max)· kimi-code | 12.0 · 3.3–22.0 | 72.8 | 66.2 h | $418.3 |
| GPT 6 Luna(default)· codex | 10.7 · 4.0–17.3 | 53.2 | 6.2 h | $5.3 |
| Gemini 3.8 Flash(default)· antigravity-sdk | 8.0 · 3.3–13.3 | 47.4 | 12.1 h | $34.5 |
| Gemini 3.7 Flash(default)· antigravity-sdk | 7.3 · 1.3–14.7 | 50.1 | 9.9 h | $26.0 |
来源与延伸阅读
- Android Bench 2.0 官方榜单页(Android Developers)官方榜单 · 页面标注最新结果截至 10 月 26 日本站 10 月 28 日直读。核对长程任务榜全部 11 行(模型·推理等级·agent、通过率、置信区间、完成率、平均耗时、单轮成本)、五个指标的官方定义、Changelog(9 月 17 日上线长程任务与 agent 口径;10 月 6 日加入 Opus 5.5 与 GPT 6 Luna/Sol、归档 Opus 5 与 GPT 5.6 三档;10 月 26 日标注推理等级、加入 Sonnet 5.5/Argon/GPT 6.1 Sol、归档 Sonnet 5 与 GPT 6 Sol)、任务类别构成,以及展开的逐任务结果(Flutter 转安卓任务全部 0/5 等)。页面另有 1.0 任务结果存档(100 任务、9 月世代模型),与 2.0 口径不混算。
- IT之家:谷歌更新 Android Bench 榜单,Gemini 4 Argon 编程能力大幅落后于 Claude 与 GPT媒体报道 · 10 月 28 日 10:09本站 10 月 28 日全文读取。本轮发现线索,并提供了榜单与品牌配图(封面官方品牌图取自该报道页面)。两处与官方页不一致已在正文按官方页更正:报道称 Argon“排在第五位”,官方 11 行中为第六;报道把 GPT-6 Sol 列入本轮新增,官方 Changelog 记录其为 10 月 6 日加入、10 月 26 日归档(由 GPT 6.1 Sol 接替)。报道另转述官宣后的“内部消息”——该模型难以处理部分编程任务。
怎么读这份榜单
按它自己的口径,至少有四件事要先摆平。一,测的是“模型+agent”组合——claude-code、codex、antigravity-sdk、qwen-coder、kimi-code 各带自家模型上场,同一模型换 agent 就是另一行成绩;Argon 走谷歌自家的 antigravity-sdk。二,推理等级这次虽然标了,但三档混排:前三个名次是 max,Argon、Fable 5.1、Astra 是 high,Qwen3.8 Max 和 GPT 6 Luna 是 default——相邻名次先对齐档位再比。三,置信区间都很宽(榜首 24.0–56.0),个位数的名次差大多不构成统计区分。四,成本是正表指标:榜首与第三名之间 15.8 倍的单轮成本差(1574.9 对 99.5 美元),是这张表里最刺眼的一格——Argon 的 267.6 美元比榜首便宜八成多,但比名次更高的 6.1 Sol 贵约 1.7 倍。
耗时容易被忽略:Argon 的 52.8 小时排在慢的一方,比它更慢的只有 Sonnet 5.5(70.7)、Kimi K3(66.2)和 Opus 5.5(56.6);同榜的 Astra 用 7.9 小时拿到 28.0%——更快,名次也更高。完成率一列前六名挤在 80.9–85.6 之间,说明拉开差距的不是“做不下去”,而是最后一关:按官方定义,完成率衡量失败的那些 run 离完整方案有多近,Argon 的多数 run 走到了接近完成、卡在测试或校验上。逐任务结果还给出了全榜共同的难度标记:官方页目前载有的各组合逐任务表里,“把 Flutter 项目转成原生安卓”的 Habo 任务没有任何组合通过(全部 0/5),React Native 转安卓只有一组拿到 2/5,Signal 电话号码输入的 Compose 迁移最多 1/5。另外别把两代口径混算:页面下方的 1.0 任务结果(100 个任务、9 月世代模型、Claude Opus 5 以 91.8% 居首)是存档,与 2.0 的 30 任务长程榜不可比。
来源与延伸阅读
- Android Bench 2.0 官方榜单页(Android Developers)官方榜单 · 页面标注最新结果截至 10 月 26 日本站 10 月 28 日直读。核对长程任务榜全部 11 行(模型·推理等级·agent、通过率、置信区间、完成率、平均耗时、单轮成本)、五个指标的官方定义、Changelog(9 月 17 日上线长程任务与 agent 口径;10 月 6 日加入 Opus 5.5 与 GPT 6 Luna/Sol、归档 Opus 5 与 GPT 5.6 三档;10 月 26 日标注推理等级、加入 Sonnet 5.5/Argon/GPT 6.1 Sol、归档 Sonnet 5 与 GPT 6 Sol)、任务类别构成,以及展开的逐任务结果(Flutter 转安卓任务全部 0/5 等)。页面另有 1.0 任务结果存档(100 任务、9 月世代模型),与 2.0 口径不混算。
边界与站内参照
口径先钉住:本文全部数字来自 Android Bench 官方页,谷歌报告、本站 10 月 28 日直读;本站没有运行任何模型或 agent,这不是独立复核,而是对官方发布的准确转述。榜单本身在动:9 月 17 日上线长程任务与 agent 口径,10 月 6 日与 10 月 26 日两轮换血——引用这些数字要带日期。谷歌在自己的安卓主场给自己家的模型测出第六,并把归档、换血记录全部公开,这份透明度值得记录;但它仍是一家厂商自设的基准,任务集和 agent 选择都由谷歌决定。IT之家是本轮的发现线索,两处出入已按官方页更正。
站内三张独立榜单(AA 综合能力、Pi 编程、Physics-IQ 物理)口径各管各的,Android Bench 不并入其中——它不在本站持续跟踪的榜单范围,本轮也不改模型目录分数;Argon 的 AA 53 分与原观察日期保留。想在站内接着看:既有 Argon 文章的“自动化、终端编程与综合分分开看”一章,讲的正是同一件事的上一集——通用分接近的模型,具体任务上可能换一副面孔;今早的 Genie 4 一文里,Argon 在世界模型实验中承担的是与 Gemini Robotics 配合的推理层。同一批模型,榜单不同、任务不同,名次和用法都不同——这是本轮最值得带走的一句话。
来源与延伸阅读
- Android Bench 2.0 官方榜单页(Android Developers)官方榜单 · 页面标注最新结果截至 10 月 26 日本站 10 月 28 日直读。核对长程任务榜全部 11 行(模型·推理等级·agent、通过率、置信区间、完成率、平均耗时、单轮成本)、五个指标的官方定义、Changelog(9 月 17 日上线长程任务与 agent 口径;10 月 6 日加入 Opus 5.5 与 GPT 6 Luna/Sol、归档 Opus 5 与 GPT 5.6 三档;10 月 26 日标注推理等级、加入 Sonnet 5.5/Argon/GPT 6.1 Sol、归档 Sonnet 5 与 GPT 6 Sol)、任务类别构成,以及展开的逐任务结果(Flutter 转安卓任务全部 0/5 等)。页面另有 1.0 任务结果存档(100 任务、9 月世代模型),与 2.0 口径不混算。
- IT之家:谷歌更新 Android Bench 榜单,Gemini 4 Argon 编程能力大幅落后于 Claude 与 GPT媒体报道 · 10 月 28 日 10:09本站 10 月 28 日全文读取。本轮发现线索,并提供了榜单与品牌配图(封面官方品牌图取自该报道页面)。两处与官方页不一致已在正文按官方页更正:报道称 Argon“排在第五位”,官方 11 行中为第六;报道把 GPT-6 Sol 列入本轮新增,官方 Changelog 记录其为 10 月 6 日加入、10 月 26 日归档(由 GPT 6.1 Sol 接替)。报道另转述官宣后的“内部消息”——该模型难以处理部分编程任务。