模型变化 · 从能力到日常使用
Sonnet 5.5 来了,已经用 Opus 的人怎么选?
接近旗舰的测评分数,不等于每个任务都更省。把官方定位、独立测试与 Copilot 接入放在一起,看日常迭代和复杂工作怎样分工。
Anthropic 于 9 月 28 日发布 Sonnet 5.5。本文于北京时间 9 月 29 日核对并整理:它带来的问题不只是排名涨了多少,还包括我们是否需要重新分配手上的工作。
它的重点,是让明确的任务更快往前走
Anthropic 把 Sonnet 5.5 放在 Opus 5.5 旁边:日常任务、修 bug、文档和表格是它强调的用途,复杂且需要持续判断的开放任务仍是 Opus 的定位。官方称输出比 Sonnet 5 快 30% 以上,大多数工作每任务成本最多降低 30%;这属于厂商测试结果。
发布页还给了同题 HTML 演示:鸟群、风吹沙丘,以及由 24 个小钟组成的时钟。对只想知道“能做什么”的读者,这些前后画面比抽象排名直观。可以沿同一道题比较效果和等待过程,但不能把几段官方演示当作所有创作任务的稳定表现。
来源与延伸阅读
- Anthropic:Sonnet 5.5 发布与同题演示官方发布 · 9 月 28 日模型定位、价格、默认推理档位与 Sonnet 5 前后演示;厂商测试与引述不等于本站实测。
分数接近 Opus,不代表把档位拉满最划算
Artificial Analysis 在最高推理档位测得 Sonnet 5.5 的综合指数为 56,位于 Opus 5.5 的 58 之后;但同一套评测的每任务成本为 7.60 美元,比 Sonnet 5 高约 50%。接近旗舰的结果,在这套测试中伴随着更多输出 token。这个金额是评测任务均值,不是问一个日常问题的报价。
这与“多数工作更省”的说法并非同一条件。官方列出的 API 输入/输出单价是每百万 token 2/10 美元,Opus 5.5 为 4/20 美元;Claude 应用和 Claude Code 默认 Medium,平台 API 默认 High。单价、推理档位、实际消耗量要分开看,不能用“单价一半”推出“总费用一半”。
这组独立测评使用发布前部署。评测方还说明,当时存在影响结构化输出的缺陷,正式版已修复,相关项目准备重跑。因此这里保留评测日期与条件,后续应跟进重测,而不是把榜单当成永久位置。
来源与延伸阅读
- Anthropic:Sonnet 5.5 发布与同题演示官方发布 · 9 月 28 日模型定位、价格、默认推理档位与 Sonnet 5 前后演示;厂商测试与引述不等于本站实测。
- Artificial Analysis:独立测评独立评测 · 9 月 28 日分数与任务成本需一起看;使用发布前部署,评测方注明将重跑有关项目。
已经在用 Copilot,可以从手上的小任务试起
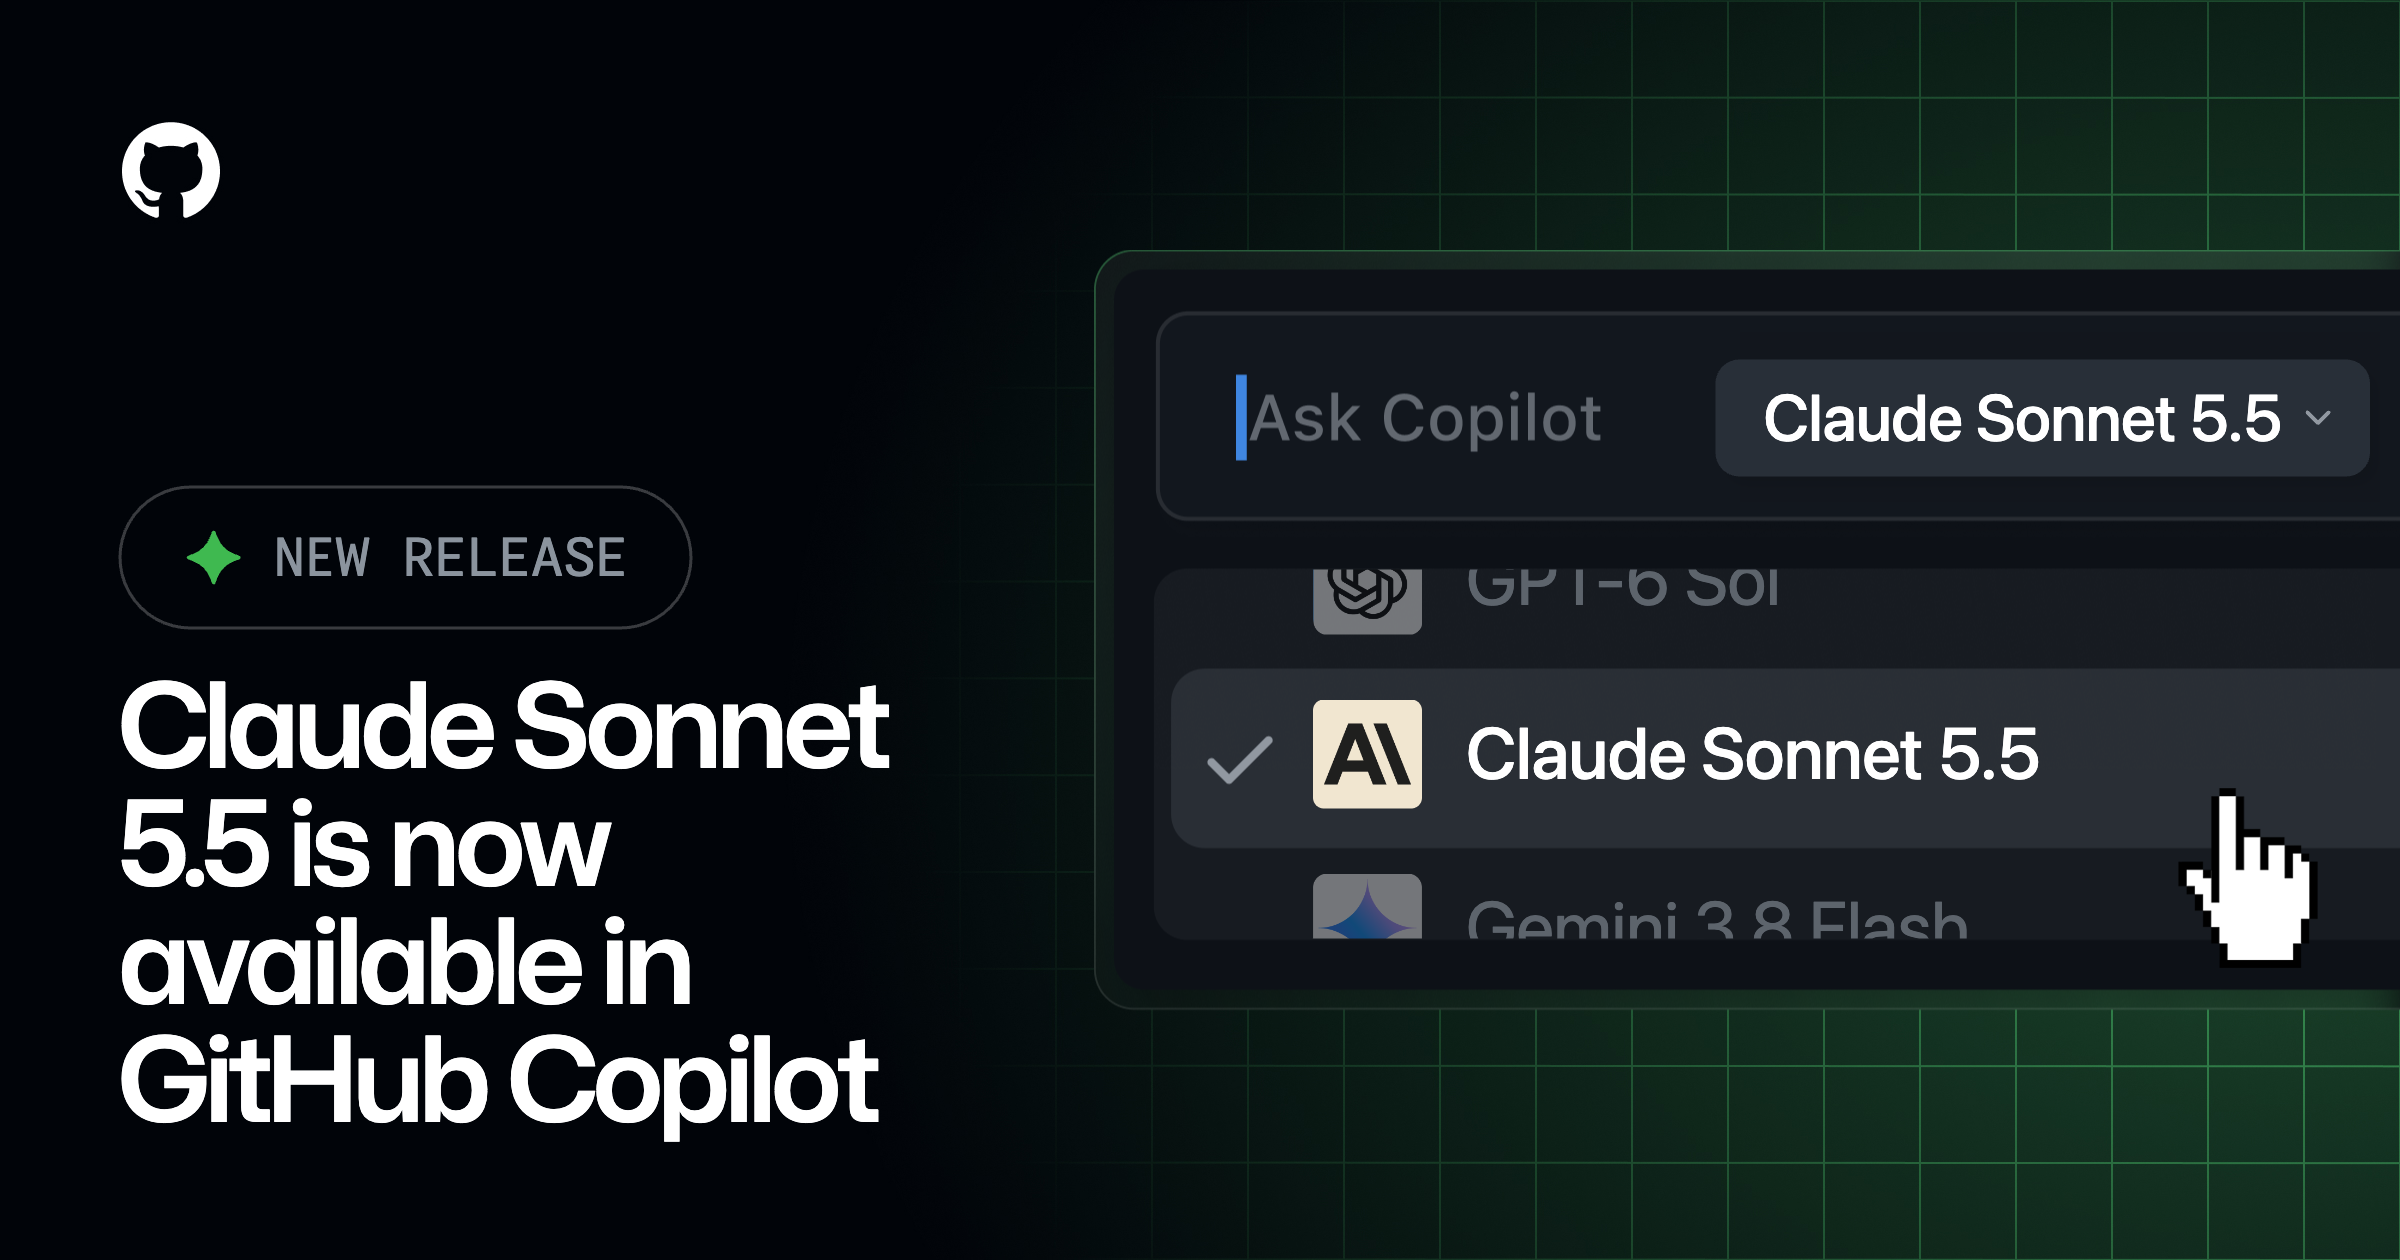
GitHub 已宣布在 Copilot 中开放 Sonnet 5.5,覆盖 Pro、Pro+、Max、Business 和 Enterprise,逐步推出到 VS Code、CLI 等入口;企业账户还受管理员模型策略影响。GitHub 的早期测试称,它以更少步骤、token 和工具调用完成编码任务。这是接入方测试,不是个人开发者的独立作品验证。
本站建议先拿一个自己熟悉、能验收的小修改做比较,例如修一个页面错位或补一项表单校验。记录完成时间、返工次数和实际账单,比只问“哪个更强”更能回答你是否值得换。不要在测试途中同时更换任务范围、提示方式和档位,否则很难知道差异来自哪里。
来源与延伸阅读
- GitHub:Copilot 开放 Sonnet 5.5产品接入 · 9 月 28 日开放计划、模型选择器及渐进推出说明;配图来自这份公告。
先安排分工,再决定是否切换
如果你已经在用 Sonnet 5,可以拿相同任务看新版是否减少等待和返工;如果已经用 Opus 5.5,不必仅凭接近的分数立刻替换全部工作。可以先将范围明确的修改交给 Sonnet,保留需要反复权衡的任务给原来的模型,再依据自己的结果调整。这是基于当前材料提出的使用思路,不是已经验证的通用最优组合。
本站的 Opus 专题已经接上视频作品与制作经验。Sonnet 是否能接手其中的字幕、版式或代码修改,还需要同项目的作者记录与作品对照;目前不把 Opus 的案例直接算成 Sonnet 的能力证明。接下来持续看独立开发者的实际成品、返工记录,以及 Artificial Analysis 的重测结果。
来源与延伸阅读
- Anthropic:Sonnet 5.5 发布与同题演示官方发布 · 9 月 28 日模型定位、价格、默认推理档位与 Sonnet 5 前后演示;厂商测试与引述不等于本站实测。
- Artificial Analysis:独立测评独立评测 · 9 月 28 日分数与任务成本需一起看;使用发布前部署,评测方注明将重跑有关项目。
- GitHub:Copilot 开放 Sonnet 5.5产品接入 · 9 月 28 日开放计划、模型选择器及渐进推出说明;配图来自这份公告。