模型更新 · 能力与使用入口
Mistral Large 4 来了:先看图纸、代码与实际入口
新一代图文模型开放 API 预览。把官方的图纸演示、代码任务成绩与独立综合分数接起来,看看它在已有 GLM、Kimi 和 Beam 选择之外带来了什么。
2026 年 10 月 6 日起经 Mistral Studio 的 API 公开预览使用;10 月 29 日起,权重也按此前的月底承诺开放(见后两章)。
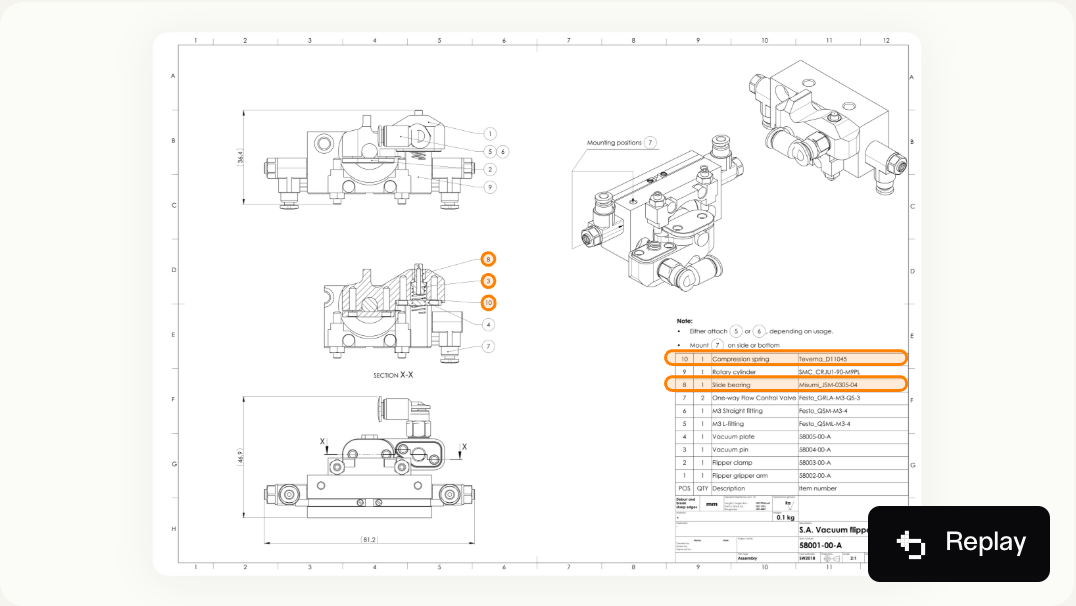
把问题指回图中的位置
Mistral 10 月 6 日公布 Large 4 公开预览,定位为万亿参数级的通用图文模型。发布资料强调代码、工具任务和视觉理解,并给出图纸、图表与文档演示。
图纸例子从“两处零件是否接触”这样的具体问题开始,先查零件表,再放大剖视图、对照编号。值得看的不是回复写得多长,而是它怎样把一句问题接回可以检查的位置。这是官方组织的回放示例,后续仍可沿同一任务观察独立使用结果。
来源与延伸阅读
- Mistral Large 4 发布说明官方 · 2026 年 10 月 6 日模型定位、官方演示和任务图表。
- 发布页中的视觉演示官方公开回放展示定位与图纸检查过程;演示数据标内部型号 patchstral-sft-260921,不作为本站调用当前 API 的记录。
具体任务与综合分数,分别提供参照
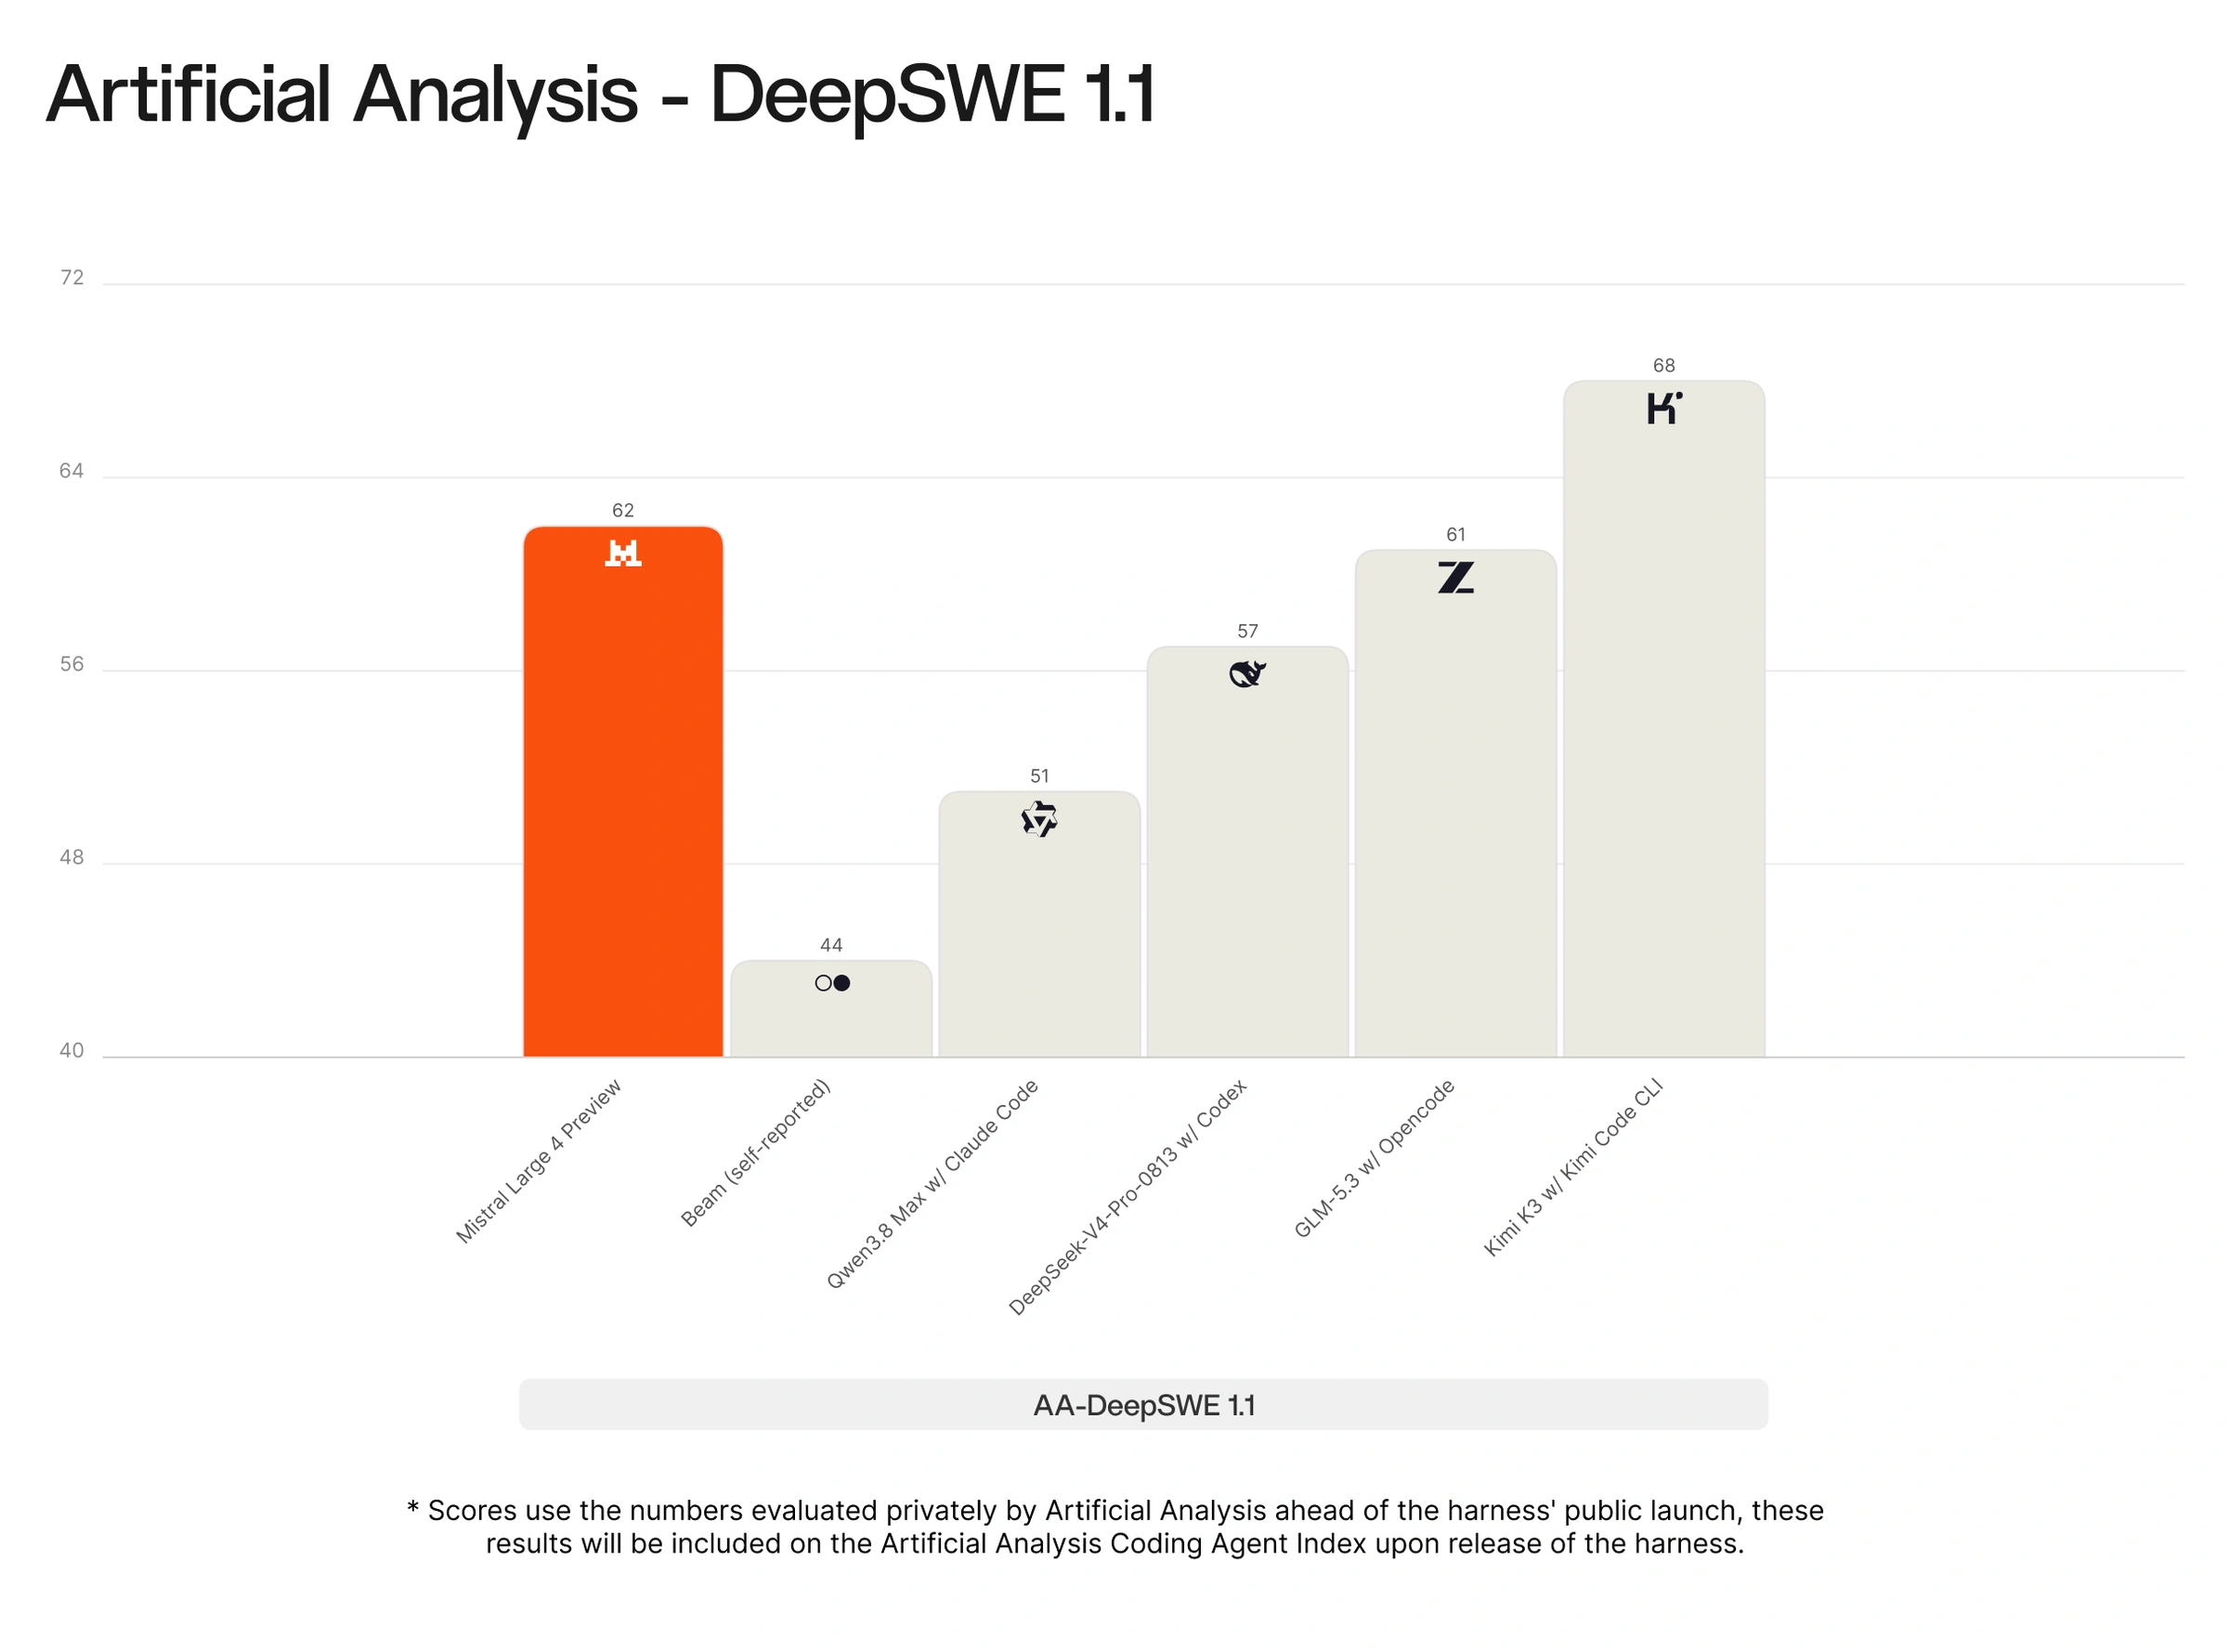
Mistral 发布页给出 DeepSWE 1.1 为 61.7% 的成绩,图中取整为约 62,并列出 GLM、Kimi 等模型与各自的工具。它回答的是特定代码任务的表现;图中的工具条件与自报项目,需要连同分数一起读。
另看 Artificial Analysis 当前综合榜,Mistral Large 4 Preview 为 38。下表保留同一来源中几种已有选择的实际档位:它帮助建立大致位置,不能把不同档位当成相同计算预算,也不能将综合分数直接换算成图纸或中文任务的成功率。
| 模型与设置 | 综合指数 |
|---|---|
| GLM-5.3 · max | 45 |
| Kimi K3 · max | 44 |
| DeepSeek V4.1 Flash · max | 39 |
| Mistral Large 4 Preview · 源表未标推理档位 | 38 |
来源与延伸阅读
- Mistral Large 4 发布说明官方 · 2026 年 10 月 6 日模型定位、官方演示和任务图表。
- Artificial Analysis 综合榜独立机构 · 10 月 7 日核对v4.3.2 同一来源的整数显示成绩;配置各自保留。
现在从 API 进入,权重发布继续跟进
当前模型卡提供 mistral-large-4 入口与 1M 上下文,列出图文对话、文档问答、工具调用和结构化输出等能力。使用的是托管服务;月底发布权重仍是官方计划,不能把今天的预览理解成已经可以下载同版模型。
这可以接回我们已有的两条线:Beam 同样需要分清预览接口与权重进度;GLM、Kimi 的 Bedrock 示例则说明,模型还要经过服务与工具接入,才进入实际工作。下一步值得继续收集的是同一份材料、同一套工具下的公开结果与返工。
来源与延伸阅读
- Mistral Large 4 模型卡官方文档 · 10 月 7 日核对公开预览、模型编号、上下文和当前调用条件。
- Mistral 更新记录官方 · 10 月 6 日发布条目API 预览已经开放,权重仍为后续计划。
权重如约开放,许可把“开放”划在哪
预览时官方承诺月底发布权重,10 月 29 日兑现:Hugging Face 上同时放出 FP8 主仓库(54 个分片)与面向 Blackwell 显卡的官方 NVFP4 量化,社区 GGUF 由 Unsloth 与 llama.cpp 团队同日提供;vLLM、SGLang、transformers 与 llama.cpp 当天可用,完整技术报告仍未发布。托管入口不变,API 仍叫 mistral-large-4,定价为每百万 token 输入 0.70 美元、缓存输入 0.07 美元、输出 2.10 美元。
许可名为 Mistral Ecosystem Open-Weight License,是一份修改版 MIT:使用、修改、微调和商用都自由,只有一条附加条件——把模型作为服务(MaaS)对外经营的业务,商用前须与 Mistral 另签商业授权。自部署、内部使用或把模型嵌入产品功能都不受限;对照同月开放权重的 Beam 1.0 采用 Apache 2.0,判断“开放权重”的含金量要看许可条款,不能只看能否下载。
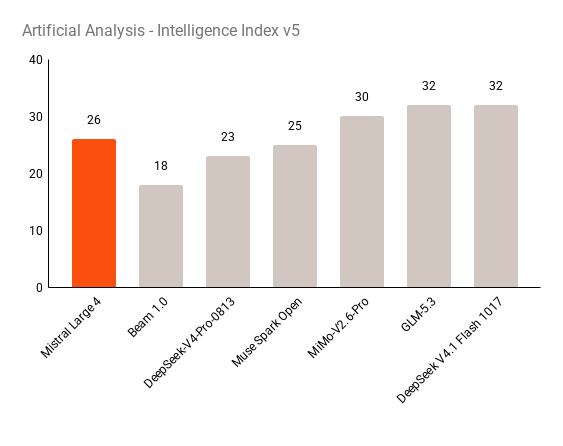
Artificial Analysis 的源表同日调整:Preview 行撤下,发布版权重以 high 档 26 分进入 v5.0 综合指数(medium 为 23),本站综合榜已随本轮整表重读同步——其余 28 行分数全部未变。厂商模型卡称其为“西方开放权重中最高”,官方图表也如实画出更高的中国开放模型:GLM-5.3 与 DeepSeek V4.1 Flash 1017 均为 32。综合指数主要衡量英文文字任务,不能替代图纸或中文场景的实际表现。
来源与延伸阅读
- Mistral Large 4 开放权重发布页官方 · 2026 年 10 月 29 日任务图表、许可说明、API 定价与安全边界说明。
- 权重仓库与模型卡官方仓库 · 10 月 30 日核对FP8 主权重 54 个分片、NVFP4 变体入口、部署配方与许可原文;仓库另列官方 NVFP4 量化。
- Artificial Analysis 综合榜独立机构 · 10 月 7 日核对v4.3.2 同一来源的整数显示成绩;配置各自保留。
预览之后的三周强化学习:编码领先,安全有边界
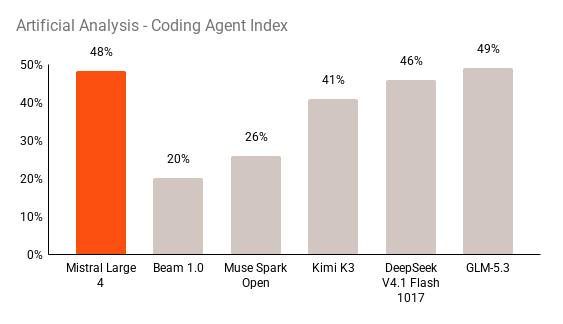
厂商公布的成绩均为厂商口径:Cognition 私有的 FrontierCode 2.0 得 19.7%,在其并列的模型中领先(Beam 1.0 为 19.3%、GLM-5.3 为 17.8%);Terminal-Bench 4.0 从预览自报的 28% 升到 41%,输出 token 减少 30%;Artificial Analysis Coding Agent Index 得 48%,与 GLM-5.3(49%)在此口径内并列,平均每任务 token 少 47%。这组数字描述的是代理式编码的性价比,不是本站实测。
安全是这次发布的主打,但要看清位置:Artificial Analysis Cyber Index 得 51%,厂商自己的图表也画出更高的 DeepSeek V4.1 Flash 1017(57%)与 MiMo-V2.6-Pro(56%)。差异在拒答平衡:对恶意网络请求的平均拒答率 96.6%,为厂商所测开放模型中最高,防御任务表现保留,代理安全基准 B3 抵抗 97.1% 的攻击(预览为 93.3%)。
边界也写在明处:预览发布后官方监测线上流量,模型会拒绝针对真实目标的黑盒攻击,但厂商认为仍存在实施真实攻击的潜力,正在修改护栏;面向渗透测试、红队等用途的专门变体只对通过审查并受合同约束的伙伴开放。截至本节发布,上述数字都未经本站复测,权重也未在本站下载或运行。
来源与延伸阅读
- Mistral Large 4 开放权重发布页官方 · 2026 年 10 月 29 日任务图表、许可说明、API 定价与安全边界说明。