模型与机器人
机器人先在模拟里练,再上奔驰产线:Gemini Robotics 2.5
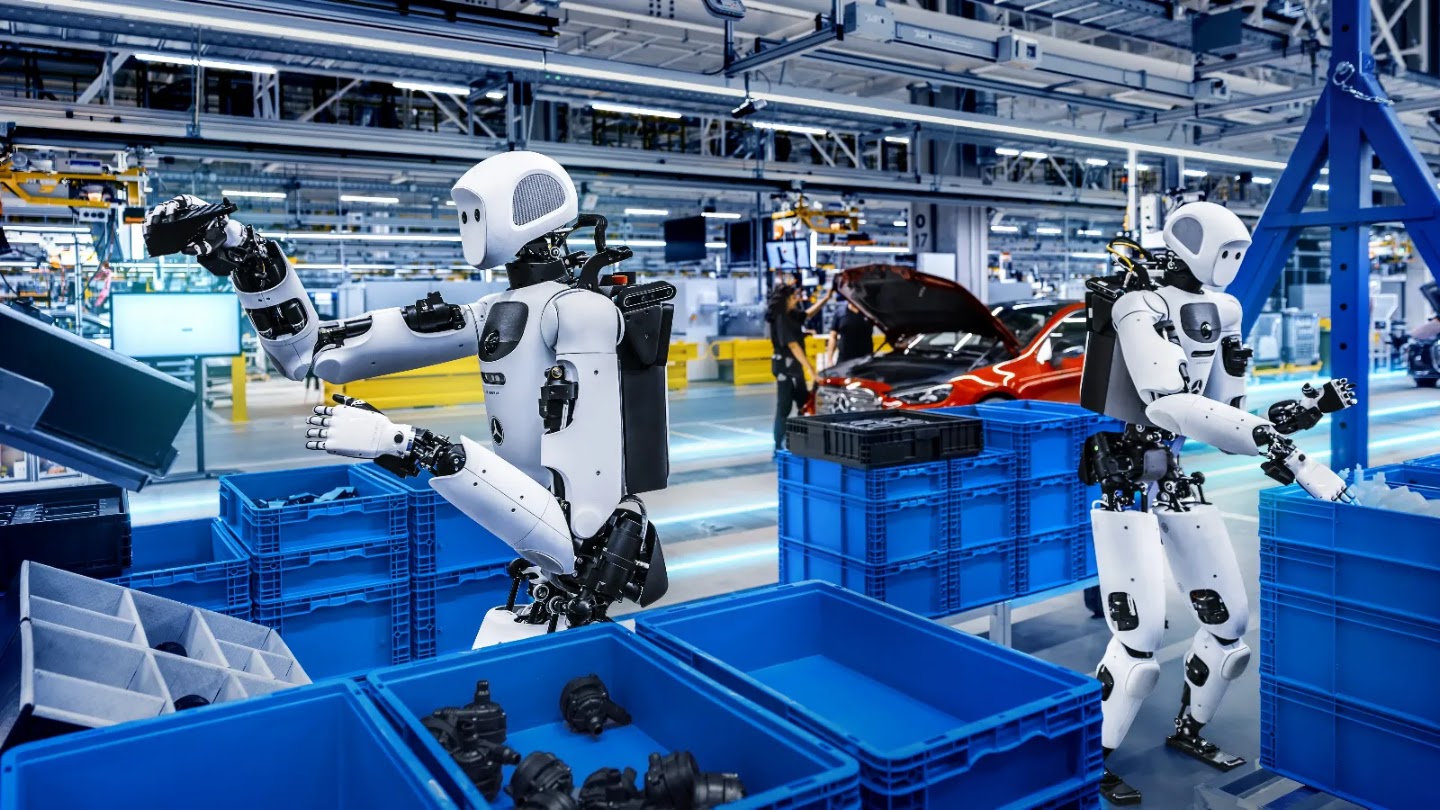
谷歌 DeepMind 11 月 10 日发布视觉-语言-动作模型 Gemini Robotics 2.5:在奔驰位于匈牙利与德国的两条活跃产线上,Apptronik Apollo 2 人形机器人用它执行汽车装箱(把散件按每辆车的顺序摆进排序容器),概念验证口径的成功率 96%。官方评估覆盖 200 个任务,较上一代基线成功率提升 30%–100%、完成快 20–30%——官方图表里夹子装点心从 5% 到 100%,多个任务上一代是 0 分。安全上引入推理时引导绕开障碍与人,并开源 ASIMOV-Jailbreak 基准:Gemini 4 Argon 抵抗率 99.5%,上一代 ER 2 为 82%。最有认识价值的是训练回路:通用模型 Argon 充当模拟引擎,从一段真实摄像头画面生成数千条模拟练习并构建数字孪生,再与真实示范合并训练动作模型。边界:全部为谷歌官方口径;机器人本体与试点结果不能互相推尽;模型只向机器人伙伴推出,尚无公开入口,也没有第三方基准。
本文依据 DeepMind 官方博客《Gemini Robotics 2.5 accelerates real-world general dexterity》(页面标注 2026-11-10,署名 Carolina Parada,本站 11 月 11 日全文读取)写成;文内图表为该博客官方配图。全部数字为谷歌官方口径:本站没有机器人、没有运行或复测任何任务,也没有读到第三方基准。
产线上的装箱测试,96% 是试点口径
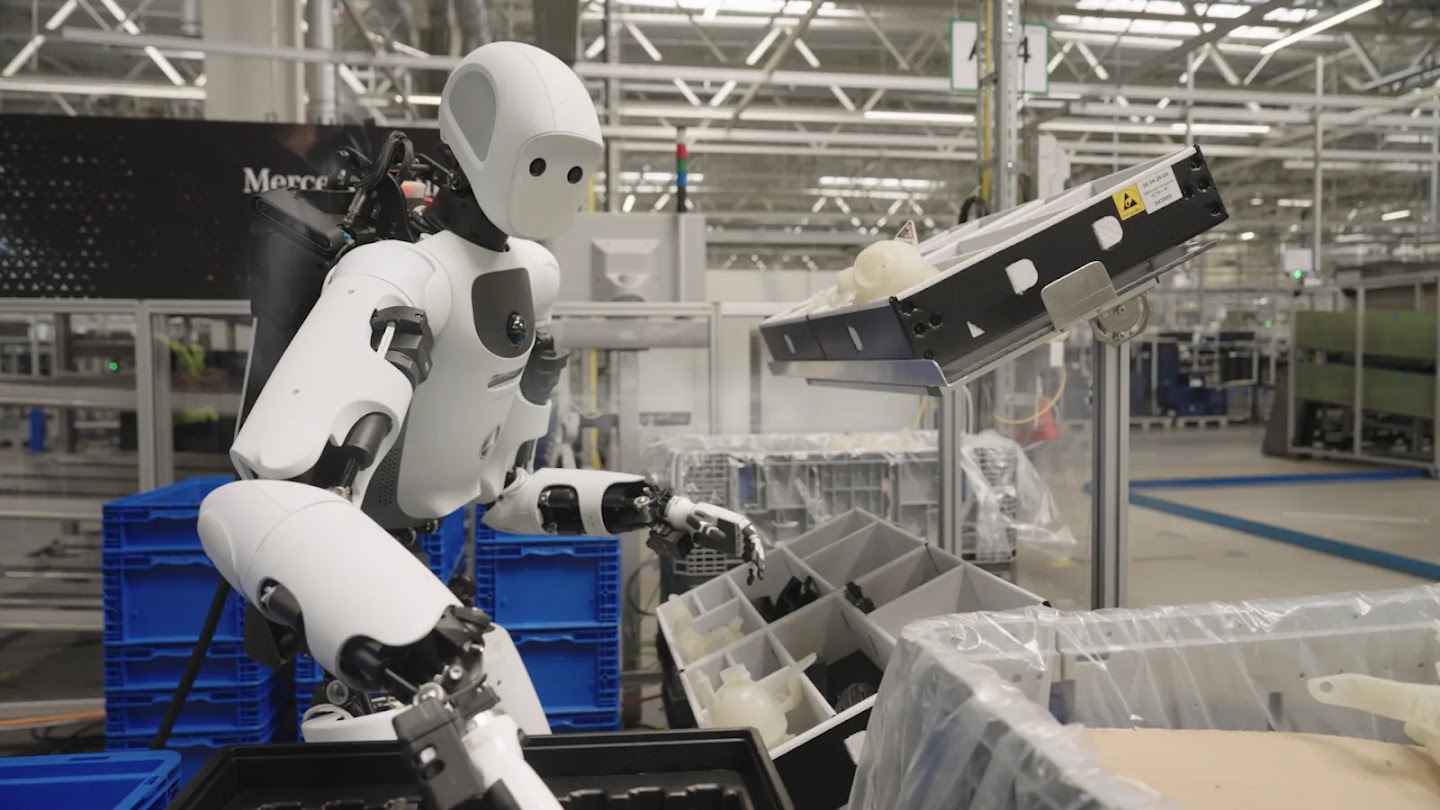
谷歌把「能不能在真实工作场所稳定干活」当作机器人模型的最终检验。这次的合作三方是 DeepMind、Apptronik 与奔驰:在匈牙利凯奇凯梅特和德国辛德尔芬根两地的活跃汽车产线上,Apollo 2 人形机器人执行汽车装箱——从散件箱里把金属支架一件件取出,按线上每辆车需要的顺序放进排序容器。这不是实验室里的演示工位,是仍在运转的产线。
系统分工明确:具身推理模型 Gemini Robotics ER 负责盯住整个工作流程,动作模型 Gemini Robotics 2.5 控制手和手臂;机器人一边做一边修正空位和错位。官方报告的成功率是 96%——注意口径:这是概念验证(proof-of-concept)数字,来自两条指定产线的指定任务,不是全厂达标率,博客也没有给出扩大部署的时间表。
对读者来说,这里值得看的不是机器人多灵巧,而是任务被怎么挑:装箱重复、体力重、占人手,出错代价却是局部的。谷歌的定位是让这类备料交给机器人、让技师转向复杂装配——这是工厂工作分配的一次具体变化,还停在试点。
来源与延伸阅读
- DeepMind 官方博客:Gemini Robotics 2.5 accelerates real-world general dexterity官方博客 · 页面标注 2026-11-10 · 本站 11-11 全文读取全文读取。核对关键声明:Gemini Robotics 2.5 为「迄今最强」视觉-语言-动作模型,向机器人伙伴推出;评估覆盖 200 个不同任务(夹子分餐、系蝴蝶结、移液),较此前基线成功率提升 30%–100%(按任务类型)、完成快 20%–30%;奔驰产线试点在匈牙利凯奇凯梅特与德国辛德尔芬根,Apptronik Apollo 2(五指 22 自由度 SharpaWave 手)执行汽车装箱,Gemini Robotics ER 盯流程、GR-2.5 控制手和手臂,成功率 96%(概念验证口径);原生适配 Apollo 2 与 Franka Duo(两指平行夹爪);推理时引导使障碍附近安全完成 +33%、人附近 +43%(官方评估);ASIMOV-Jailbreak 开源基准含数百条伪装不安全请求、跨数十个场景,Argon 抵抗 99.5%、上一代基线 ER 2 为 82%;Argon 充当模拟引擎:从真实摄像头画面生成数千条模拟练习、构建数字孪生、从录像推测失败原因并在模拟与真机分别验证;博客自述「今年早些时候把全身智能带给多类机器人」承接 Gemini Robotics 2 一线。作者栏 Carolina Parada;致谢含 Apptronik、Mercedes-Benz、Agile 团队。
两百个任务:先看基线原来是几分
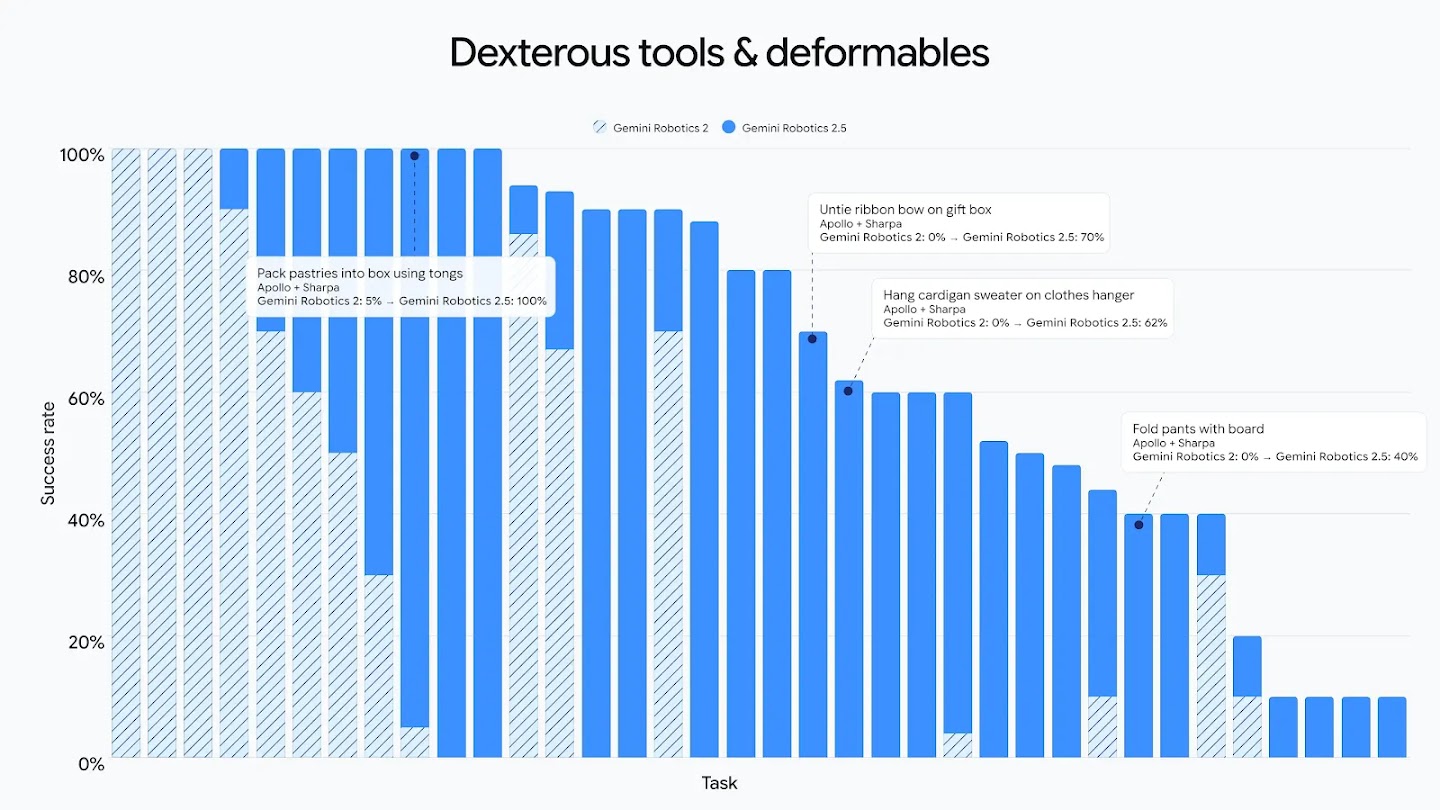
能力评估覆盖 200 个不同任务:用夹子分餐、在礼盒上系蝴蝶结、移液取液。这类任务共同点是要同时做到工具使用、可变形物处理和轻拿轻放。官方口径是:较此前基线,成功率按任务类型提升 30%–100%(相对值),完成速度加快 20%–30%。
官方图表把前后对比摆得更直白:夹子把点心装进盒子从 5% 到 100%,解礼盒蝴蝶结从 0 到 70%,把开衫挂上衣架从 0 到 62%,用板叠裤从 0 到 40%(Apollo + Sharpa 配置)。值得注意的不是增幅大,而是基线那一半——好几个任务上一代是 0 分——不是「以前做得差」,是「以前做不了」。这类从零到一的行,才是任务广度扩张的实证。
同一模型原生适配多种本体:Apollo 2 人形(五指、22 自由度 SharpaWave 手)和 Franka Duo 双臂平行夹爪平台都在适配清单里。动作模型与机器人本体分开评估是必要的——同样的成功率数字不能从一台机器推到另一台。
来源与延伸阅读
- DeepMind 官方博客:Gemini Robotics 2.5 accelerates real-world general dexterity官方博客 · 页面标注 2026-11-10 · 本站 11-11 全文读取全文读取。核对关键声明:Gemini Robotics 2.5 为「迄今最强」视觉-语言-动作模型,向机器人伙伴推出;评估覆盖 200 个不同任务(夹子分餐、系蝴蝶结、移液),较此前基线成功率提升 30%–100%(按任务类型)、完成快 20%–30%;奔驰产线试点在匈牙利凯奇凯梅特与德国辛德尔芬根,Apptronik Apollo 2(五指 22 自由度 SharpaWave 手)执行汽车装箱,Gemini Robotics ER 盯流程、GR-2.5 控制手和手臂,成功率 96%(概念验证口径);原生适配 Apollo 2 与 Franka Duo(两指平行夹爪);推理时引导使障碍附近安全完成 +33%、人附近 +43%(官方评估);ASIMOV-Jailbreak 开源基准含数百条伪装不安全请求、跨数十个场景,Argon 抵抗 99.5%、上一代基线 ER 2 为 82%;Argon 充当模拟引擎:从真实摄像头画面生成数千条模拟练习、构建数字孪生、从录像推测失败原因并在模拟与真机分别验证;博客自述「今年早些时候把全身智能带给多类机器人」承接 Gemini Robotics 2 一线。作者栏 Carolina Parada;致谢含 Apptronik、Mercedes-Benz、Agile 团队。
安全:绕开障碍与人,再考一次越狱
机器人离开实验室,安全就从模型属性变成物理问题。Gemini Robotics 2.5 用「推理时引导」(inference-time reasoning guidance)实时绕开物理危险——类比语言模型外挂的安全分类器,这一层让机器人在复杂环境里改道。官方评估给出的数字:障碍附近安全完成任务提升 33%,附近有人时提升 43%。
长程代理任务的安全用新基准检验:ASIMOV-Jailbreak 开源发布,含数百条把不安全请求伪装起来的提示、覆盖数十个场景。成绩单:Gemini 4 Argon 抵抗 99.5% 的越狱尝试,上一代基线 Gemini Robotics ER 2 为 82%。两点口径要分开——Argon 在这里作为具身推理层被评估;且这仍是谷歌自己出的考卷,开源的意义在于别人可以拿同一套题去考别的模型。
来源与延伸阅读
- DeepMind 官方博客:Gemini Robotics 2.5 accelerates real-world general dexterity官方博客 · 页面标注 2026-11-10 · 本站 11-11 全文读取全文读取。核对关键声明:Gemini Robotics 2.5 为「迄今最强」视觉-语言-动作模型,向机器人伙伴推出;评估覆盖 200 个不同任务(夹子分餐、系蝴蝶结、移液),较此前基线成功率提升 30%–100%(按任务类型)、完成快 20%–30%;奔驰产线试点在匈牙利凯奇凯梅特与德国辛德尔芬根,Apptronik Apollo 2(五指 22 自由度 SharpaWave 手)执行汽车装箱,Gemini Robotics ER 盯流程、GR-2.5 控制手和手臂,成功率 96%(概念验证口径);原生适配 Apollo 2 与 Franka Duo(两指平行夹爪);推理时引导使障碍附近安全完成 +33%、人附近 +43%(官方评估);ASIMOV-Jailbreak 开源基准含数百条伪装不安全请求、跨数十个场景,Argon 抵抗 99.5%、上一代基线 ER 2 为 82%;Argon 充当模拟引擎:从真实摄像头画面生成数千条模拟练习、构建数字孪生、从录像推测失败原因并在模拟与真机分别验证;博客自述「今年早些时候把全身智能带给多类机器人」承接 Gemini Robotics 2 一线。作者栏 Carolina Parada;致谢含 Apptronik、Mercedes-Benz、Agile 团队。
源头闭环:通用模型当练习场
这篇公告里最有认识价值的不是某个百分比,而是训练回路的结构。教机器人新技能,瓶颈长期在于物理数据太少、采集太贵。谷歌的解法是让 Gemini 4 Argon 充当「模拟引擎」:从一段真实摄像头画面生成数千条各不相同的模拟练习,并构建逼真的数字孪生;这些模拟数据与真实示范合并,机器人对新场景、新物体的泛化随之加快。
Argon 还承担排障:从任务录像里推测失败原因,先在模拟里试验改进方案,再上真机验证。源头通用能力和专用动作模型在这里形成分工——通用模型出数据和诊断,动作模型出稳定执行。本站 10 月记录的官方 Spot 演示(读摄像头、模拟里练踩垃圾桶踏板、硬件执行)是同一模式的上一幕;这次它有了专用动作模型、两座工厂和量化的成功率。
坐标放在一起看更清楚:通用模型这边,Argon(high)在本站记录的 AA 综合榜上 50 分,有独立评测;而由它加速训练的 Robotics 2.5 目前只有谷歌自家口径,没有第三方基准。站内的物理续视频榜(Physics-IQ)关注「看懂物理结果」,这一篇关注「做出物理动作」——两条线在物理智能汇合,但能力不能互相替代。下一步值得等的:开源的 ASIMOV-Jailbreak 被第三方跑出的成绩,以及试点之外第一个不依赖合作方叙事的独立测量。
- 读 DeepMind 官方公告原文官方博客,页面标注 2026-11-10;配图与全部数字出处。
- 看上一幕:Argon 的机器人先练习章节本站 10 月已发表:官方 Spot 演示的「先模拟、后执行」与硬件分工。
来源与延伸阅读
- DeepMind 官方博客:Gemini Robotics 2.5 accelerates real-world general dexterity官方博客 · 页面标注 2026-11-10 · 本站 11-11 全文读取全文读取。核对关键声明:Gemini Robotics 2.5 为「迄今最强」视觉-语言-动作模型,向机器人伙伴推出;评估覆盖 200 个不同任务(夹子分餐、系蝴蝶结、移液),较此前基线成功率提升 30%–100%(按任务类型)、完成快 20%–30%;奔驰产线试点在匈牙利凯奇凯梅特与德国辛德尔芬根,Apptronik Apollo 2(五指 22 自由度 SharpaWave 手)执行汽车装箱,Gemini Robotics ER 盯流程、GR-2.5 控制手和手臂,成功率 96%(概念验证口径);原生适配 Apollo 2 与 Franka Duo(两指平行夹爪);推理时引导使障碍附近安全完成 +33%、人附近 +43%(官方评估);ASIMOV-Jailbreak 开源基准含数百条伪装不安全请求、跨数十个场景,Argon 抵抗 99.5%、上一代基线 ER 2 为 82%;Argon 充当模拟引擎:从真实摄像头画面生成数千条模拟练习、构建数字孪生、从录像推测失败原因并在模拟与真机分别验证;博客自述「今年早些时候把全身智能带给多类机器人」承接 Gemini Robotics 2 一线。作者栏 Carolina Parada;致谢含 Apptronik、Mercedes-Benz、Agile 团队。
- Artificial Analysis 综合榜:Gemini 4 Argon(high)50 分独立评测 · 本站榜单记录 2026-11-11 观察本站当日整表重读记录:Argon(high)50 分。用于说明源头侧通用模型的能力坐标——它已经在语言与代理任务上有独立评测,而由它加速训练的 Robotics 2.5 目前只有谷歌自家口径。综合榜分数与机器人任务成功率不可互推。