模型 · 源头能力
Gemini 4 Hydrogen 入场:谷歌把前沿家族的「日常档」补齐了
谷歌 11 月 12 日发布 Gemini 4 Hydrogen,给 Gemini 4 家族补上「日常执行」档:Carbon 与 Argon 负责吃时间的深度长程推理,Hydrogen 主打快速编码与智能体工作流,而且第一天就全员可用——AI Studio 全部档位、Gemini API、企业版、Gemini 应用、Google 搜索,付费 Pro/Ultra 订阅者还可在 Antigravity 与 Google Sheets 中使用。价格在 1M 上下文窗口内一口价:每百万 token 输入 1.5 美元、输出 7.5 美元;1M 输入、最高 1M 输出;四档思考级别 low/medium/high(默认)/新增 xhigh。分数是这一篇里可以核对的部分:Artificial Analysis 独立榜已列出四档——xhigh 54、high 51(超过 Argon high 的 50)、medium 41、low 27,与官方自报一致;high 档每个任务约 1.87 美元,对 Argon 的 4.97 美元,时间是 8.3 分钟对 30.1 分钟。官方同时把「多模型分工」做成产品:Antigravity 新增 Orchestrator,在同一会话里于 Carbon 与 Hydrogen 之间切换,Terminal-Bench 4.0 成功率接近全 Carbon、配额省 24%、快 19%。官方对照表并非全胜——对 Claude Sonnet 5.5,Hydrogen 在 Terminal-Bench 4.1(63.9% 对 57.0%)、OSWorld-2.1(83.9% 对 77.6%)与 Terminal-Bench-Science(59.9% 对 51.4%)三项落后。边界照录:除 AA 独立榜外的基准、成本曲线与安全行为数字都是厂商口径,本站未实测。
本文依据两个来源写成:谷歌官方博客(页面标注 2026-11-12,本站 11-13 全文读取)与 Artificial Analysis 实时榜单(本站 11-13 直连整表回读)。Hydrogen 的四档分数已同步出现在独立榜上,与官方页面自报一致;除此之外的基准对照表、成本曲线与安全行为数字均为厂商口径,本站未运行任何测试。
第一天就全员可用
谷歌把 Gemini 4 家族的第三个名字写得很直白:Carbon 和 Argon 负责「最难问题上的深度、长程推理」,Hydrogen 负责跨多种智能体工作流的快速执行——官方社交媒体口径把它称作日常主力(daily driver)。发布时间是 11 月 12 日(北京时间 11-13 凌晨),署名 DeepMind 的 Koray Kavukcuoglu。家族分工本身不是新概念,这次不一样的地方在于:「日常档」拿出的分数和价格可以逐项核对,而且第一天就全员开放。
入口覆盖了谷歌的主要界面:AI Studio 的所有档位、Gemini API、Gemini for business、Gemini 应用、Google 搜索(全部用户),付费 Google AI Pro/Ultra 订阅者还可在 Antigravity 与 Google Sheets 中使用,Android Studio 同步支持。对照同家族 Carbon 的节奏——10 月 28 日发布时只向一小批网络防御者开放,11 月 10 日才普遍开放——Hydrogen 是这个家族里第一个「发布即可用」的型号。
价格与窗口一口价:整个 1M token 上下文窗口内,每百万 token 输入 1.5 美元、输出 7.5 美元;原生 1M 输入、最高 1M 输出。思考级别共四档——low、medium、high(默认)与新增的 xhigh,官方的说法是「只为你需要的推理深度等待和付费」。和 Carbon 介绍期的 2/10 美元(其后 4/20)放在一起,Hydrogen 的定位一目了然:这个家里便宜、快、随时可调的那一个。
来源与延伸阅读
- 谷歌官方博客《Introducing Gemini 4 Hydrogen》官方发布 · 页面标注 2026-11-12 · 本站 11-13 全文读取全文读取。核对关键声明:家族定位(Carbon/Argon 深度长程推理、Hydrogen 快速执行);入口(AI Studio 全部档位、Gemini API、Gemini for business、Gemini 应用、Google 搜索全员、Antigravity 限付费 Pro/Ultra、Android Studio);定价 1.5/7.5 美元每百万 token(1M 上下文一口价)、1M 输入最高 1M 输出;四档思考级别含新 xhigh;官方自报 AA high 51 对 Argon 50、xhigh 54;Orchestrator 在 Terminal-Bench 4.0 上成功率接近全 Carbon、平均省 24% 配额、快 19%;对 3.8 Flash 高档快 2.5 倍、Terminal-Bench 4.1 57% 对 18.2%、编造性陈述减少超 5 倍;对照表(对 Sonnet 5.5 与 Terra)含胜负两项;安全数字(越权最多 −81%、服务不足最多 −79%、错位动作与走捷径降 12 倍、内部诚实评估 96.7%、20 万轮思维链可读 99.9%、Gray Swan IPI 韧性 2.3 倍、HealthBench Pro 误拒 <0.4%);官方基准方法页 deepmind.google/models/evals-methodology/gemini-4-hydrogen。
可核对的入场位:54 分与每任务 1.87 美元
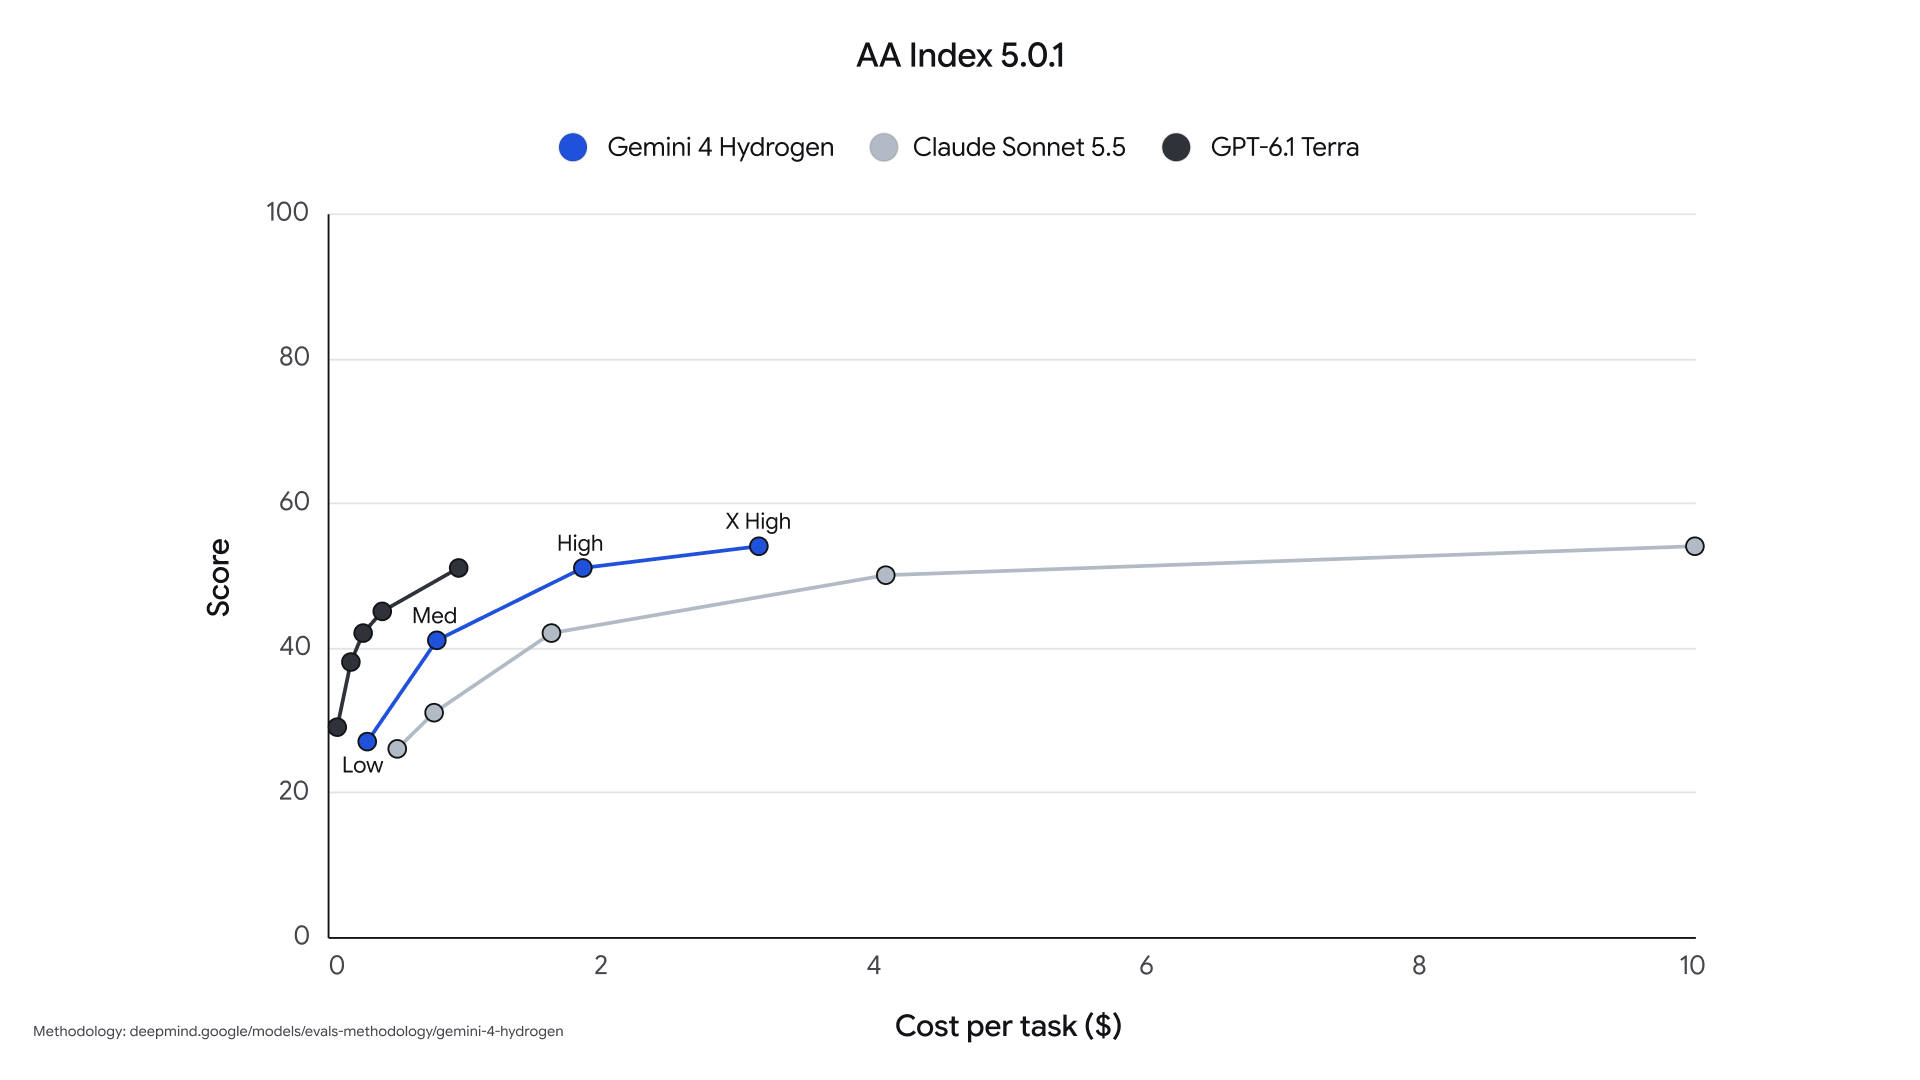
分数是这一篇里可以核对的部分。Artificial Analysis 的实时榜已经列出 Hydrogen 的四个档位:xhigh 54、high 51、medium 41、low 27——与官方页面自报的「high 51 超过 Argon 的 50、xhigh 达到 54」完全一致。放进本站 11 月 13 日整表回读的综合榜,Hydrogen(xhigh 54)排在 Sonnet 5.5(max 55)之后、Terra(max 51)之前;家族内部则是 Fable 5.2(max 65)与 Carbon(high 60)在上,Argon(high 50)和上一代日常档 3.8 Flash(high 31)在下。
把分数和账单放在一起看更能说明定位:high 档每个任务约 1.87 美元、8.3 分钟,xhigh 约 3.16 美元、13.5 分钟;Argon high 是 4.97 美元、30.1 分钟。比上一代深度模型高一分,花的钱约为其三分之一、时间不到一半。官方放出的成本-分数曲线把同一点画了出来:在 1 到 3 美元区间,Hydrogen 的曲线整体压着 Claude Sonnet 5.5——拿到 50 分上下的成绩,Sonnet 的成本点在 4 美元开外。图上标的版本是 AA Index 5.0.1;Artificial Analysis 方法页的版本史写明 5.0.1(2026 年 11 月起)只做了 CritPt v2 的评分鲁棒性改进并重评全部模型,本日整表回读的所有已收录行分数与 11 月 11 日完全一致。
对它正式接替的日常档前任 3.8 Flash,官方给的是倍数:high 档完成任务快 2.5 倍,Terminal-Bench 4.1 从 18.2% 提到 57%,编造性陈述减少超过 5 倍;合作伙伴的早期使用里,复杂图表、SQL 与数据密集流程提速 2 到 2.8 倍、token 用量省 12% 到 23%。这些是厂商口径,但对照的是有公开榜位的具体基准,而非泛泛的「更快更强」。
来源与延伸阅读
- 谷歌官方博客《Introducing Gemini 4 Hydrogen》官方发布 · 页面标注 2026-11-12 · 本站 11-13 全文读取全文读取。核对关键声明:家族定位(Carbon/Argon 深度长程推理、Hydrogen 快速执行);入口(AI Studio 全部档位、Gemini API、Gemini for business、Gemini 应用、Google 搜索全员、Antigravity 限付费 Pro/Ultra、Android Studio);定价 1.5/7.5 美元每百万 token(1M 上下文一口价)、1M 输入最高 1M 输出;四档思考级别含新 xhigh;官方自报 AA high 51 对 Argon 50、xhigh 54;Orchestrator 在 Terminal-Bench 4.0 上成功率接近全 Carbon、平均省 24% 配额、快 19%;对 3.8 Flash 高档快 2.5 倍、Terminal-Bench 4.1 57% 对 18.2%、编造性陈述减少超 5 倍;对照表(对 Sonnet 5.5 与 Terra)含胜负两项;安全数字(越权最多 −81%、服务不足最多 −79%、错位动作与走捷径降 12 倍、内部诚实评估 96.7%、20 万轮思维链可读 99.9%、Gray Swan IPI 韧性 2.3 倍、HealthBench Pro 误拒 <0.4%);官方基准方法页 deepmind.google/models/evals-methodology/gemini-4-hydrogen。
- Artificial Analysis 模型榜与方法页独立评测机构实时榜 · 本站 11-13 直连整表回读(web_reader 返回无 Hydrogen 的缓存页,直连核验后采用)整表回读。Hydrogen 四档:xhigh 54(每任务 $3.16、13.5 分钟)、high 51($1.87、8.3 分钟)、medium 41($0.80、3.7 分钟)、low 27($0.29、1.3 分钟);对照 Argon high 50($4.97、30.1 分钟)与 Gemini 3.8 Flash high 31($7.77、14.8 分钟)。方法页现标注 Intelligence Index v5.0.1;版本史写明 5.0.1(2026 年 11 月起)仅「采纳 CritPt 作者的评分鲁棒性改进并在 CritPt v2 上重评全部模型」;本日全部已收录行显示分数与 11-11 整表回读一致。
Orchestrator:把「多模型分工」做成一个开关
这次发布里对工作形态影响最直接的不是模型本身,而是 Antigravity 新上的 Orchestrator:同一个会话里,编排器在 Carbon 与 Hydrogen 之间动态切换,而不是从头到尾只用一个模型。官方数字:Terminal-Bench 4.0 上成功率接近全 Carbon,配额平均省 24%、整体快 19%。需要并行的场景里,Carbon 担任协调者,Hydrogen 驱动工作者与校验者代理,在隔离工作区里同时构建和测试。
「多模型分工」此前多是使用者自己搭的:本站写过的样本里,klad 把榜首模型接进窄命令面的绘画工具,DeepSeek 的 dsh-superagent 用 Router 接话、Worker 干活,Meta 官方建议 Wonder 规划、Ember 走量。谷歌这次把分工做进自家开发工具的默认能力,并给出第三方基准上的节省数字——分工从「用户的手工组合」变成「厂商产品里的一个开关」。边界照录:24% 与 19% 是官方在 Terminal-Bench 4.0 一个基准上的口径,不是普遍承诺;Orchestrator 的实际切换质量要在各自工作负载里另行检验。
来源与延伸阅读
- 谷歌官方博客《Introducing Gemini 4 Hydrogen》官方发布 · 页面标注 2026-11-12 · 本站 11-13 全文读取全文读取。核对关键声明:家族定位(Carbon/Argon 深度长程推理、Hydrogen 快速执行);入口(AI Studio 全部档位、Gemini API、Gemini for business、Gemini 应用、Google 搜索全员、Antigravity 限付费 Pro/Ultra、Android Studio);定价 1.5/7.5 美元每百万 token(1M 上下文一口价)、1M 输入最高 1M 输出;四档思考级别含新 xhigh;官方自报 AA high 51 对 Argon 50、xhigh 54;Orchestrator 在 Terminal-Bench 4.0 上成功率接近全 Carbon、平均省 24% 配额、快 19%;对 3.8 Flash 高档快 2.5 倍、Terminal-Bench 4.1 57% 对 18.2%、编造性陈述减少超 5 倍;对照表(对 Sonnet 5.5 与 Terra)含胜负两项;安全数字(越权最多 −81%、服务不足最多 −79%、错位动作与走捷径降 12 倍、内部诚实评估 96.7%、20 万轮思维链可读 99.9%、Gray Swan IPI 韧性 2.3 倍、HealthBench Pro 误拒 <0.4%);官方基准方法页 deepmind.google/models/evals-methodology/gemini-4-hydrogen。
官方对照表里的赢与输
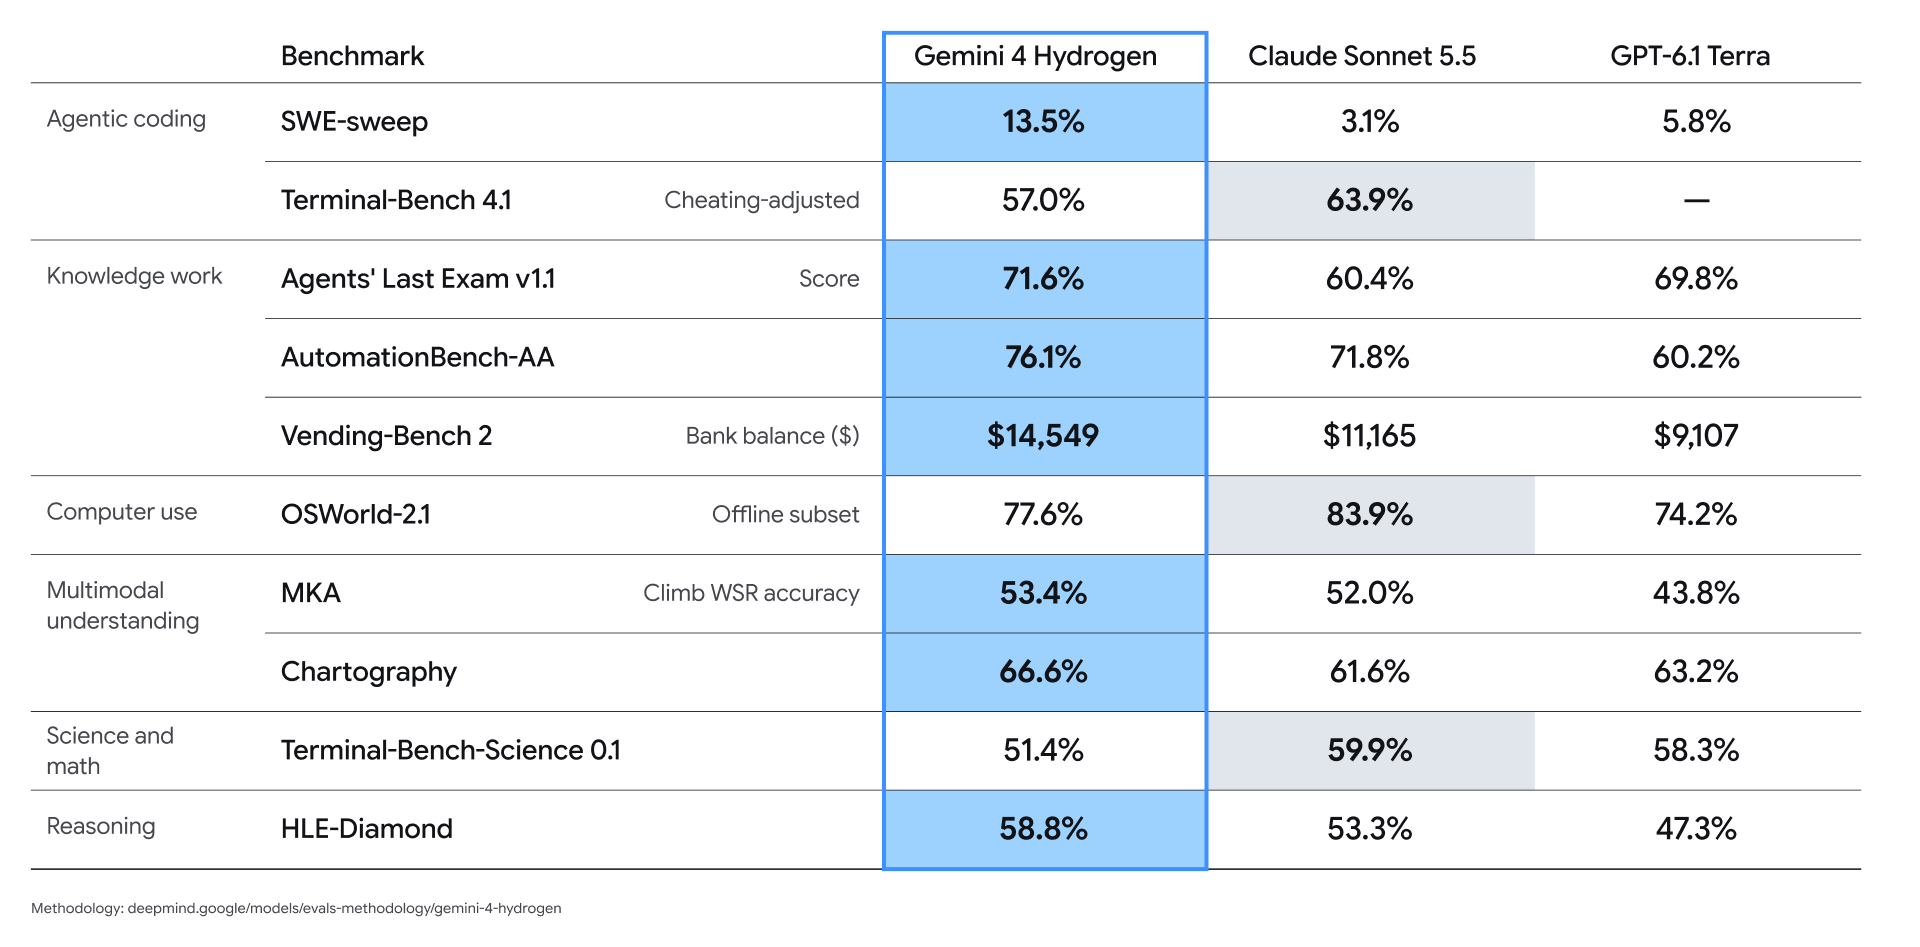
官方的基准对照表挑了两个同档对手:Claude Sonnet 5.5 与 GPT-6.1 Terra。Hydrogen 赢下的项目:SWE-sweep 13.5%(对 3.1% 与 5.8%,官方称在「发现并修复 bug 且不破坏现有代码」的任务上超过同档);Agents' Last Exam v1.1 71.6%(对 60.4% 与 69.8%);AutomationBench-AA 76.1%(对 71.8% 与 60.2%);Vending-Bench 2 剩余资金 14,549 美元(对 11,165 与 9,107);多模态理解 MKA 53.4% 与图表任务 Chartography 66.6%;推理类 HLE-Diamond 58.8%(对 53.3% 与 47.3%)。
输的也印在同一张表里:Terminal-Bench 4.1(作弊调整口径)57.0%,低于 Sonnet 5.5 的 63.9%;OSWorld-2.1 离线子集 77.6%,低于 Sonnet 的 83.9%;Terminal-Bench-Science 0.1 的 51.4% 同时低于 Sonnet 的 59.9% 和 Terra 的 58.3%。博客正文强调的是对 3.8 Flash 的三倍提升,而表格里的同类对照并不全胜——「同类领先」要按任务逐项读;把胜负都印在官方材料里,倒是省了读者自己拼图。
表格之外还有几项厂商转引的成绩:arena.ai 实时榜 Agent Arena 第五、Vals 税务代理基准第一(52.3%)、Vals 法律研究并列第一(55.8%)、AutomationBench-AA 同类领先。评测机构、任务与口径各自不同,本站逐一照录、不混算;官方方法页在 deepmind.google/models/evals-methodology/gemini-4-hydrogen 公开。
来源与延伸阅读
- 谷歌官方博客《Introducing Gemini 4 Hydrogen》官方发布 · 页面标注 2026-11-12 · 本站 11-13 全文读取全文读取。核对关键声明:家族定位(Carbon/Argon 深度长程推理、Hydrogen 快速执行);入口(AI Studio 全部档位、Gemini API、Gemini for business、Gemini 应用、Google 搜索全员、Antigravity 限付费 Pro/Ultra、Android Studio);定价 1.5/7.5 美元每百万 token(1M 上下文一口价)、1M 输入最高 1M 输出;四档思考级别含新 xhigh;官方自报 AA high 51 对 Argon 50、xhigh 54;Orchestrator 在 Terminal-Bench 4.0 上成功率接近全 Carbon、平均省 24% 配额、快 19%;对 3.8 Flash 高档快 2.5 倍、Terminal-Bench 4.1 57% 对 18.2%、编造性陈述减少超 5 倍;对照表(对 Sonnet 5.5 与 Terra)含胜负两项;安全数字(越权最多 −81%、服务不足最多 −79%、错位动作与走捷径降 12 倍、内部诚实评估 96.7%、20 万轮思维链可读 99.9%、Gray Swan IPI 韧性 2.3 倍、HealthBench Pro 误拒 <0.4%);官方基准方法页 deepmind.google/models/evals-methodology/gemini-4-hydrogen。
安全数字、搜索升级与边界
安全与行为数字全部是厂商口径:代理任务里的越权行为最多减 81%、服务不足最多减 79%,工具使用与编码评估中的错位动作与走捷径减少 12 倍;面对不可能或被阻断的任务,绕过权限边界的可能性最多降低 2 倍;内部代理诚实评估 96.7%;超过 20 万轮审计里思维链可读率 99.9%、零欺骗性修改;Gray Swan 间接提示注入基准下韧性提高 2.3 倍;HealthBench Pro 误拒率低于 0.4%,官方特别说明护栏要能区分真实生物安全风险与正当的医学、科学提问。
产品侧的升级是 Gemini 应用与 Google 搜索:搜索全球 rollout,理解口语化、多部分与带错字的提问,扩展查询扇出带回更宽的相关链接;Gemini 应用侧强调按你的格式与规则一次给出可用的草稿。这些是集成效果表述,读者在自己界面上实际看到什么仍以产品为准。
边界汇总:AA 独立榜已核实四档分数与官方自报一致,这是本篇唯一经独立来源核对的数字;官方对照表为厂商自跑(方法页公开);安全行为数字来自谷歌自己的评估;搜索与应用的集成效果无法独立复验。本站未调用 API、未复跑任何基准。本站综合榜按「最高已测档位」规则收录 Hydrogen 为 xhigh 54,与 Argon 的 high 50、3.8 Flash 的 high 31 同表可见——家族三代的日常档,如今在同一把尺子上。
- 读官方发布博客全部事实与数字的出处;官方基准方法页链接在文内。
- 在 Google AI Studio 里试用全部档位可用;四档思考级别在模型设置里切换。
- 看本站 Gemini 4 Carbon 发布解读与 GA 补充章同一家族的另一种节奏:防御者先行的两周,与 Hydrogen「第一天全员可用」的对照。
来源与延伸阅读
- 谷歌官方博客《Introducing Gemini 4 Hydrogen》官方发布 · 页面标注 2026-11-12 · 本站 11-13 全文读取全文读取。核对关键声明:家族定位(Carbon/Argon 深度长程推理、Hydrogen 快速执行);入口(AI Studio 全部档位、Gemini API、Gemini for business、Gemini 应用、Google 搜索全员、Antigravity 限付费 Pro/Ultra、Android Studio);定价 1.5/7.5 美元每百万 token(1M 上下文一口价)、1M 输入最高 1M 输出;四档思考级别含新 xhigh;官方自报 AA high 51 对 Argon 50、xhigh 54;Orchestrator 在 Terminal-Bench 4.0 上成功率接近全 Carbon、平均省 24% 配额、快 19%;对 3.8 Flash 高档快 2.5 倍、Terminal-Bench 4.1 57% 对 18.2%、编造性陈述减少超 5 倍;对照表(对 Sonnet 5.5 与 Terra)含胜负两项;安全数字(越权最多 −81%、服务不足最多 −79%、错位动作与走捷径降 12 倍、内部诚实评估 96.7%、20 万轮思维链可读 99.9%、Gray Swan IPI 韧性 2.3 倍、HealthBench Pro 误拒 <0.4%);官方基准方法页 deepmind.google/models/evals-methodology/gemini-4-hydrogen。
- Artificial Analysis 模型榜与方法页独立评测机构实时榜 · 本站 11-13 直连整表回读(web_reader 返回无 Hydrogen 的缓存页,直连核验后采用)整表回读。Hydrogen 四档:xhigh 54(每任务 $3.16、13.5 分钟)、high 51($1.87、8.3 分钟)、medium 41($0.80、3.7 分钟)、low 27($0.29、1.3 分钟);对照 Argon high 50($4.97、30.1 分钟)与 Gemini 3.8 Flash high 31($7.77、14.8 分钟)。方法页现标注 Intelligence Index v5.0.1;版本史写明 5.0.1(2026 年 11 月起)仅「采纳 CritPt 作者的评分鲁棒性改进并在 CritPt v2 上重评全部模型」;本日全部已收录行显示分数与 11-11 整表回读一致。