研究到创作 · 视频连贯性
AI 短片切个镜头,钢琴手就变成了小提琴手
Google 把错误版与修正版并排放出。沿着这次角色错位,看视频怎样被检查、重做,以及研究演示离日常创作工具还有哪一步。
Google 9 月 24 日整理了多镜头视频研究。这里展示的是研究团队的 8 秒对照片段;本站核对了原视频画面,没有复现生成过程。原文没有提供普通用户直接使用 VQQA 的入口。
两帧都像演出,连起来却变了人
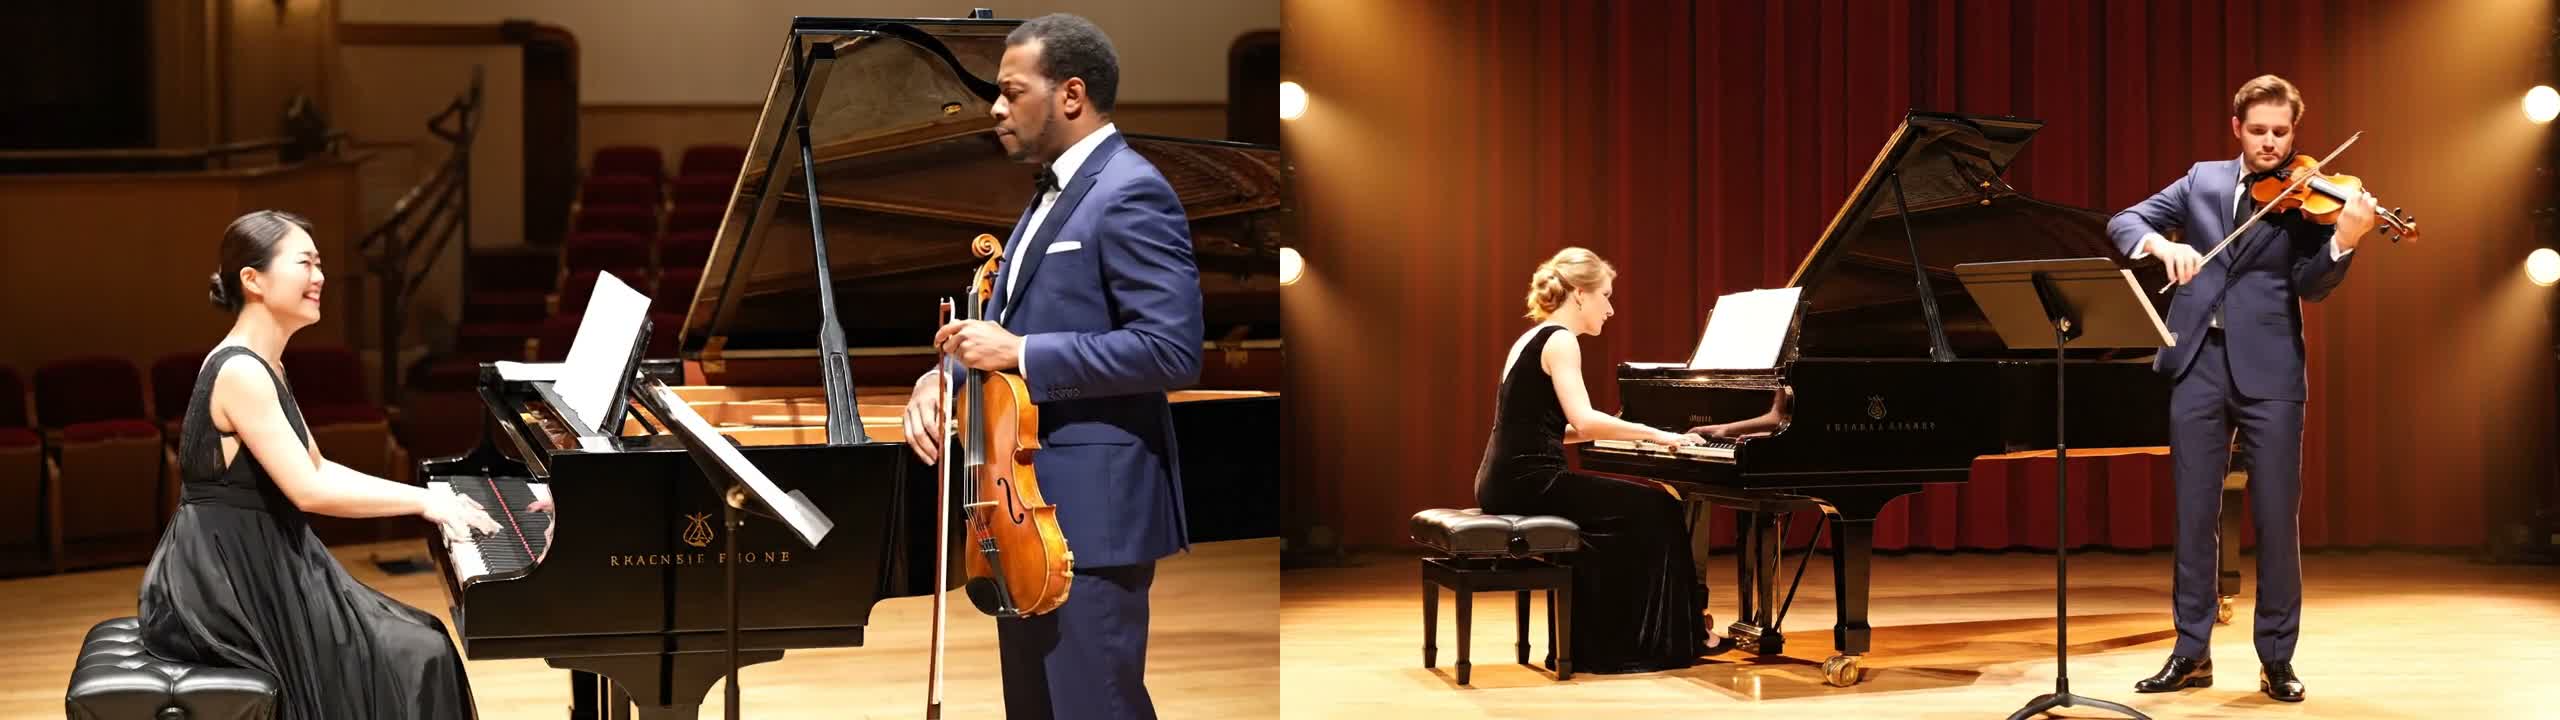
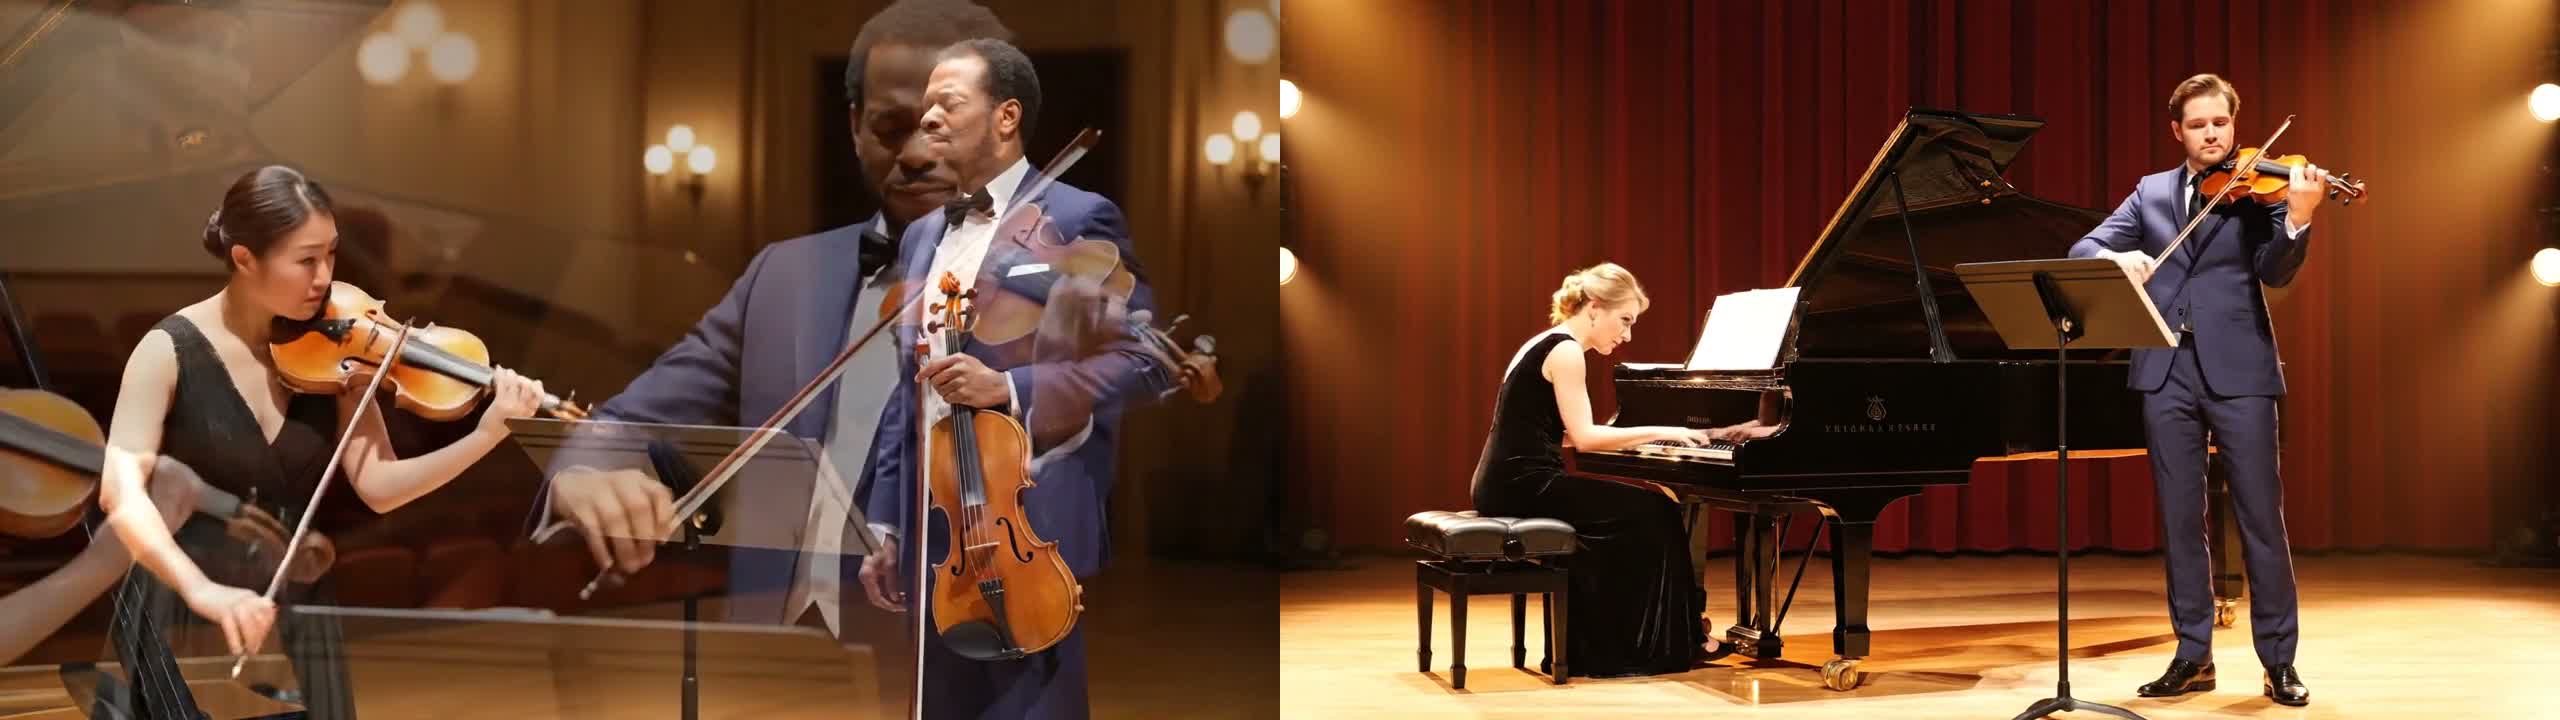
Google Research 的八秒对照视频在同一个画面里放了两种结果。起初,左右两边都是女性坐在钢琴前、男性拿着小提琴;切到后一个镜头,左侧基础生成里的女性改为拉小提琴,右侧修订版仍让她弹琴、男性拉琴。单看一帧未必会意识到问题,顺着镜头看,角色与乐器的对应关系就断了。
这是一段研究示例,展示的是一次可见的错位与修正,不代表所有乐器、人物或长片都能稳定修好。原视频可从开头看到第五秒,再暂停检查两位演奏者各自做了什么。
- 看原始八秒并排视频Google Research 原视频;左为基础生成,右为研究修订。
来源与延伸阅读
- Google Research:怎样让长视频保持连贯官方研究介绍 · 9 月 24 日并排演示、VQQA 的工作方式,以及其他多镜头研究的范围。
- 钢琴与小提琴:原始对照视频官方演示 · 8 秒左侧基础生成、右侧 VQQA 修订;前后镜头需连起来看。
它先检查哪里错了,再重新生成
研究方法叫 VQQA。它不会直接擦掉错误画面里的小提琴,而是根据最初的创作要求提出视觉核对问题,用视觉语言模型指出结果哪里没有对上,再调整提示词生成新候选。最后还会把多个候选重新对照原要求,选择较好的一段,不默认最后一次尝试就是最好。
对创作者可借鉴的是检查顺序:做多镜头短片时,先记下谁负责什么、角色穿着和道具位置,再逐镜核对这些关系有没有延续。这里是从研究得出的编辑思路;Google 的文章没有公布这段示例每次重做的耗时、费用,也没有把 VQQA 作为现成视频按钮开放。
来源与延伸阅读
- Google Research:怎样让长视频保持连贯官方研究介绍 · 9 月 24 日并排演示、VQQA 的工作方式,以及其他多镜头研究的范围。
- VQQA 原论文研究论文 · 3 月 12 日视觉问题、自然语言反馈、重新生成与从全部候选中选择的研究方法。
从一处穿帮,看到长片的下一道难题
同一篇 Google Research 文章还介绍了另外几种研究:CANVAS 用角色、地点和物件状态来维持跨镜头的视觉记忆,A²RD 按片段延伸长视频,另有从整体故事意图组织分镜的 co-director。它们分别处理规划、记忆、生成和检查,不是一款已经交给普通用户的一键长片工具。
这也帮助我们分清不同的短片做法:Opus 5.5 专题中的作品主要让模型写动画代码、组织制作工具;这里研究的是生成画面拼成故事后,人物和动作能否保持一致。接下来值得看的,是创作者在真实项目里能否减少返工,而不只是研究片段变漂亮。
来源与延伸阅读
- Google Research:怎样让长视频保持连贯官方研究介绍 · 9 月 24 日并排演示、VQQA 的工作方式,以及其他多镜头研究的范围。