AI 视频 · 案例
《欢迎回来,亲爱的!》:成片、失败镜头与一支 AI 动画 MV 的返工
先看完整 MV,再把作者公开视频中的成功与错误,接回人物设定、歌词分镜、画幅、动态生成和剪辑选择。
发布 · 材料核对
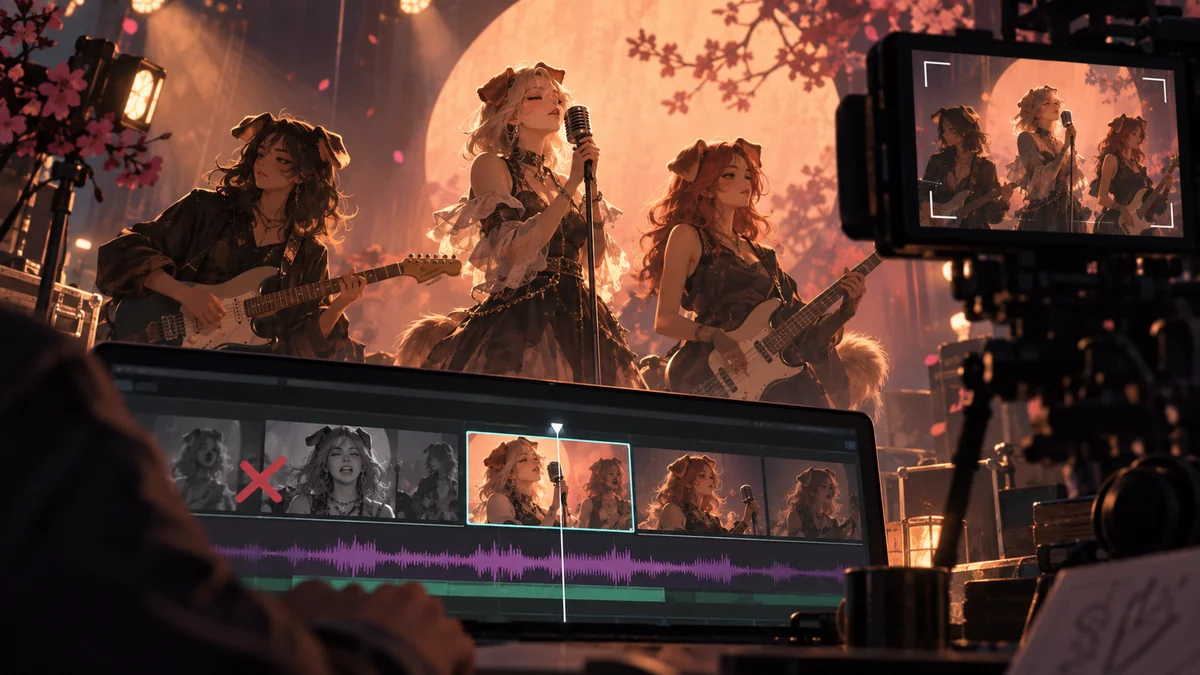 本站编辑示意 · 非原片画面
展开项目背景与编辑判断
一首由逝去爱犬启发的歌,变成三名犬耳偶像在房间、玄关与舞台之间演唱的动画 MV。Jill Mama 先有歌曲和画面构想,再用模型生成静帧与动态,最后在 CapCut 里挑选可用时刻。她把成片、衣服和发型变化的失败视频、口型失败视频,以及一个满意的镜头都嵌进制作笔记。这里能看到的不只是做成了什么,还有生成片段为什么不能直接进成片;但这些片段不是同镜头、同条件的提示词实验。
01
已核实的材料
先看成片:这次完成了什么
原作者提供完整 MV,并说明歌曲在制作视频之前已发布。
Jill Mama 的制作笔记直接嵌入完整 MV。作品名在本站译为《欢迎回来,亲爱的!》,罗马字原名为《Okaeri Darling!》。歌曲此前已通过 Spotify 等渠道发布;这次制作要把她心里的“等人回家”和犬耳偶像舞台画面拍出来。作者有多年音乐行业经历,自己构想了主要场景,没有让 AI 代写整支 MV 的故事。打开原片,先看房间、玄关与舞台如何交替,以及三个人物在歌唱段落中如何分配镜头。
成片可播放,不能因此推断它有多少观众或赚了多少钱。作者只说视频或许会帮助歌曲传播;她提到在制作 MV 前已看到歌曲被用于 TikTok,不能把该使用量记成 MV 带来的成果。
02
公开说法
五个人缩到三个,歌词写进 Excel
先控制角色与场景,再决定谁唱哪句、哪时切到舞台。
作者最初打算做五位以意大利灵缇为灵感的偶像,开始画角色设定后改成银发、黑发、棕发三位。她的理由是多角色的发色、服装、站位和脸容易在生成中混在一起;三位也更容易安排各自的独唱与出场。名字和性格帮助她管理大量素材,并决定各角色该怎样动。这是作者的创作与管理选择,不是模型自动规划出来的结构。
她先定“等待的房间、归来的玄关、情绪爆发的舞台”三处场景和舞台装、居家装两套衣服,再在 Excel 里写歌词、分配歌唱者、想姿势与运镜、生成静态画面并贴回表格。她没有在开始前做完所有镜头;清楚的部分先锁定,其余随素材结果调整。对想做音乐视频的人,先把歌词、人物、场景和镜头目标对齐,比先盲目生成长视频更容易定位返工原因。
03
公开说法
静帧好看,却因为画幅与道具重做
16:9 画幅没在静态阶段锁定,麦克风和复杂服饰又增加动态失误。
作者用 ChatGPT Images 2.0 做主要画面,却曾只看人物姿势和表情,没有先按最终 16:9 成片画幅制作。转成视频后出现黑边,单在视频生成阶段指定 16:9 也没解决,她只能重做大量静态图。笔记展示了分镜表,但没有逐一公开所有重做前后的输入和输出;这里可确认的是错误发生的环节与作者的修正方向,不能伪造一组严格对照。
舞台人物起初拿着麦克风。作者报告,转为动态时麦克风会消失、增多、飞走或变成黑棒;已有少量成功镜头让她不愿全弃,于是成片混用了有无麦克风的镜头。她还发现由图像模型加上的褶边、丝带等服装细节难以跨镜保持,只重做变化太明显的素材,放过较小的装饰差异。这不是“多写几个形容词”就能保证修复的问题,而是人物设计和可接受误差的取舍。
04
已核实的材料
把能看的成功与错误片段放在一起
衣发漂移、口型失败和成功运镜来自同一作者、同一 MV 项目,但不是同一镜头的改前改后。
原文在服装反省段落嵌入一段 Seedance 2.0 失败视频:同一角色的衣服与发型明显跑偏。另一个嵌入视频展示她尝试短语口型后出现的失败画面。它们是原作者自己选择公开的失败片段,读者可以直接播放,比只看“会翻车”的笼统提醒更具体;但笔记未给出完整逐字提示词、固定随机种子、重试数或对应的独立修复后视频。
作者也公开了一段自己满意的运镜:先做上、下方的参考画面,细写摄影机运动,却较少指定角色动作,生成出了她喜欢的舞台镜头。这是另一个镜头,不能说它修好了衣服或口型。作者自己的经验是长提示词并不必然更好,有时只写两行、留给模型动作空间反而更自然;这是一次项目中的判断,不是适用于所有模型或题材的对照实验。
公开过程
同一 MV 的三段原作者视频
按原文嵌入顺序核对衣发漂移、满意运镜和口型失败。每段可在原作者 YouTube 播放;它们承担不同镜头任务。

同一项目的造型漂移示例;不是最终成片中的同镜头前版。 · Jill Mama 原作者的 YouTube 视频与缩略图;本站不托管 · 原始材料 
作者满意的独立运镜,不是上一个失误的修复结果。 · Jill Mama 原作者的 YouTube 视频与缩略图;本站不托管 · 原始材料 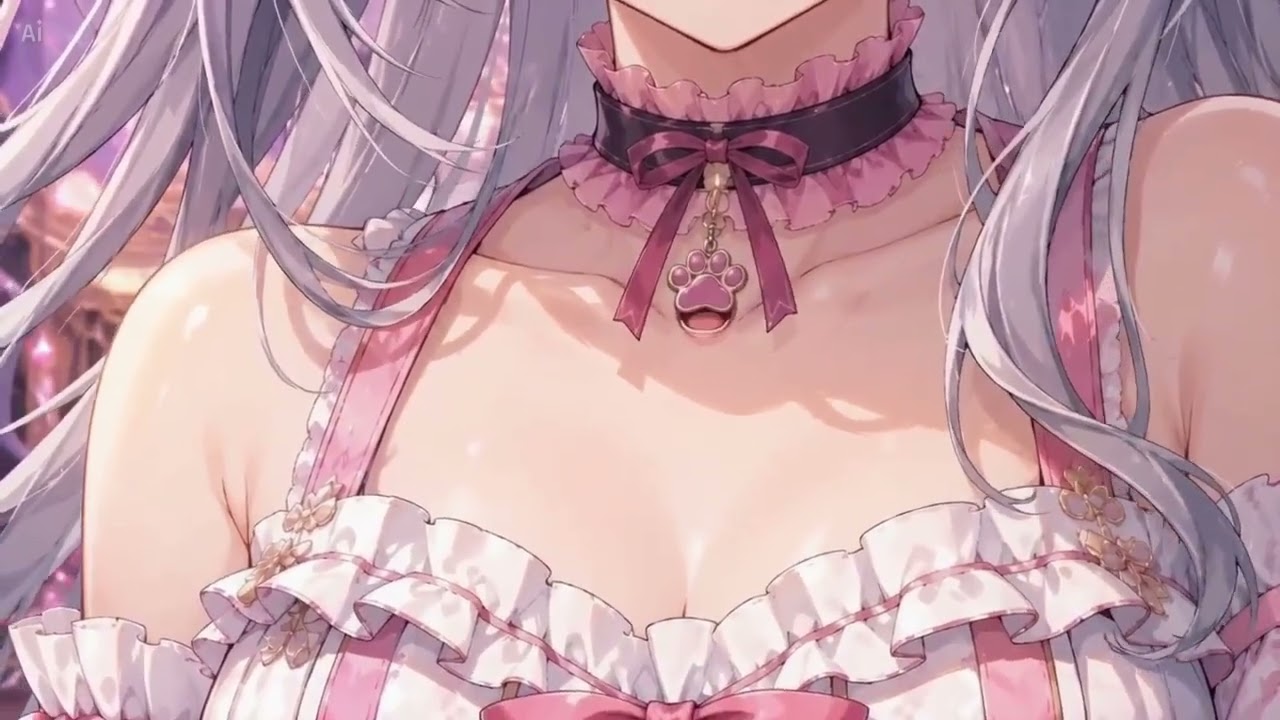
这是原作者展示的口型失误;不能当成所有 AI 视频口型能力的测试。 · Jill Mama 原作者的 YouTube 视频与缩略图;本站不托管 · 原始材料
证据边界三段视频是同一创作者、同一 MV 中的不同镜头和问题;没有完整输入、同条件 A/B、每次重试清单或失败镜头的独立修复版。本站使用 YouTube 原播放器和链接,不镜像视频或抽取静帧。
本节依据: Jill Mama:《欢迎回来,亲爱的!》动画 MV 制作笔记 · 作者公开的衣发漂移片段 · 作者满意的运镜片段 · 作者公开的口型失败片段
05
公开说法
15 秒生成素材,真正可用的可能只有 10 秒
作者在 CapCut 里挑时刻、变速、换位置,必要时回到静帧重做。
原文说,计划用满的一段 15 秒视频,有时因动作或首尾异常只留 10 秒;为了合拍,某段还会加速到约 8 秒。生成结果即使画面本身不错,也可能放不到原先设计的歌词位置。于是作者不断剪接、检查违和感、换素材和再生成,有时连静态画面都要重做。成片不是把多个完整生成片段顺次排上去,而是在歌曲的时间轴中寻找可用部分。
她想让开头与结尾的短句对口型,但说歌速和舞步拍点难以完全配准,最终只做到自己当时可接受的程度。作者把 Suno 列为音乐工具;歌曲在这次 MV 制作前已经完成和发行。视频制作另用了 ChatGPT Images 2.0 做静帧,Seedance 2.0、Veo、Kling、Sora 做动态,再由她在 CapCut 剪辑。公开材料没有逐镜工具归属表,不应替所有镜头指定同一个模型,也不能把视频生成说成音乐创作的全部过程。
本节依据: Jill Mama:《欢迎回来,亲爱的!》动画 MV 制作笔记 · 《欢迎回来,亲爱的!》完整 MV · 作者公开的口型失败片段
06
公开说法
约 1.5 万日元的自报费用,不等于盈利样板
作者给出订阅和加购的粗估,也写到一次咨询最终没有形成委托。
作者粗算 Firefly 两个月及加购约 4,500 日元、CapCut 的订阅与 Seedance 加购约 10,000 日元,总额说成“大约 15,000 日元”。分项相加约 14,500 日元;这更说明数字是取整的个人回忆,不是逐笔结算。这个合计只列了两类工具,未纳入她原本已付费的 Suno,也未计多天生图与剪辑劳动;公开页没有完整账单、发行成本或收入。不能把这个数字当成任何人都能以同样价格做出 MV 的报价。
作者说自己的歌曲已在 TikTok 被使用,也曾有人询问能否为研讨会制作 AI 动画。她向对方解释制作需要时间与预算,最终没有接到该委托。这两件事说明作品可能带来传播或服务想象,但没有证据把既有歌曲使用归因于 MV,也不能把一次咨询写成订单。公开材料没有 MV 的平台结算、客户回款或净利润。
07
本站分析
如果自己要做,先缩小到一段歌和两个镜头
保留人物与歌词计划、输入和失败输出,先检验跨镜一致性与剪辑可用率。
可以从自己有权使用的一段歌曲出发,先决定一个人物、一个场景和两种镜头任务:一段表演、一段叙事。按最终画幅做静帧,给人物与服装留简单设定,再分别试动态;记录每次参考图、提示词、输出、耗费与最终进入剪辑的秒数。若只有“漂亮的一张图”,还不能判断连续视频是否成立。这个小实验是本站从作者经历提出的起步方法,不是作者公开的保证成功配方。
原作者开放的是观看 MV 和阅读制作经历,不是把歌曲、形象、视频或笔记授权给他人重新发布。文章页尾另有付费附件,本站没有使用或转述附件内容。读者若想商用自己的 MV,要先核对歌曲、声音、形象和每个生成服务的使用条件;目前这份公开材料也不足以证明该项目具备可复制的盈利模型。
本站设计的练习 · 非原作者教程
用一段自己的歌,试做两镜头 MV
本站从 Jill Mama 的歌词分镜、画幅返工和剪辑记录设计这项小试;目标是做出能与音乐接上的片段,先不承担整支 MV 的角色与成本。
开始前准备
- 取自己创作或已获许可使用的 15–30 秒音乐;确认声音、人物形象和参考图的使用权。
- 只设一个人物、一个场景和最终画幅,先写下可投入的时间、费用和生成次数。
标出一句歌词和一个情绪转折
在音乐时间线上标注歌词、强拍和情绪变化,为一镜表演、一镜叙事各写画面目标。
- 留下什么
- 带秒数的两镜头表:谁在画面里、做什么、从哪一秒到哪一秒。
- 怎样检查
- 静音看表演镜仍知道人物是谁,听歌不看画面也能说出这两镜为何出现在对应歌词。
按最终画幅做两张角色静帧
先固定人物的发色、服装和重要道具,再为两镜做符合最终画幅的静帧,不用后期裁切挽救比例。
- 留下什么
- 两张带角色设定与画幅说明的关键帧。
- 怎样检查
- 并排时人物像同一个人,重要道具不增减,画面没有黑边;不通过就先改静帧。
短段生成并保留失败输出
分别为两镜生成短片段,保存参考图、实际输入、模型版本、每次结果与费用;先不追求全曲口型。
- 留下什么
- 每镜至少一段可回看候选,以及未采用片段的原因记录。
- 怎样检查
- 逐项看衣发、道具、脸和动作是否漂移;口型若未达到目标,要说明是哪个词、哪个时刻,而非笼统说模型不好。
剪出实际可用秒数
把候选放到音乐时间线上,只留下动作、表情和节拍都能接上的部分,必要时调整入出点或重做一张静帧。
- 留下什么
- 一段 15–30 秒的可播放粗剪,附每镜生成时长与最终保留时长。
- 怎样检查
- 听歌盲看与无声看画面各一次:转场是否踩在预期情绪上、人物是否连续、两镜是否有无法解释的服装跳变。
让目标观众指出记住了什么
让几位目标听众在不看制作说明的情况下说出记住的歌词、人物和镜头,并问哪里出戏;记录修改意见和总投入。
- 留下什么
- 反馈表、修改清单,以及时间/费用/可用秒数的实际记录。
- 怎样检查
- 区分‘做出片段’、‘听众理解’与‘MV 带来播放或收入’;最后一项需另有发布后数据和结算依据。
最后做一个取舍:若两镜的角色与情绪能接上、可用秒数和返工成本仍可接受,再扩到第三镜;若画幅或人物一致性仍失控,先缩角色与道具,不追加整首歌。
这是 BitShovel 的编辑练习,不是 Jill Mama 的原始工作表或原提示词。原作者歌曲、人物与视频只供在原址观看和学习;她公开的失败片段不是同镜头修复前后对照,MV 也没有可核实收入。
出处与边界
材料从哪里来
- Jill Mama:《欢迎回来,亲爱的!》动画 MV 制作笔记原作者第一手制作自述;免费可读部分发布 核对
人物、分镜、失败、剪辑、费用和未成交咨询均来自作者自述;页尾付费附件未使用。
- 《欢迎回来,亲爱的!》完整 MV原作者 YouTube 成片核对
核对成片画面和剪辑结果;不提供收入或后台数据。
- 作者公开的衣发漂移片段原作者 YouTube 失败片段核对
制作笔记在服装反省处嵌入;未提供同镜头独立修复版。
- 作者满意的运镜片段原作者 YouTube 成功片段核对
制作笔记在摄影机运动段落嵌入;与失败片段不是同一镜头。
- 作者公开的口型失败片段原作者 YouTube 失败片段核对
制作笔记在口型段落嵌入;没有完整提示词或独立修复版。