持续专题 · 2026年9月20日整理
Jev:从快速判断,到查航班与整理论文
浏览器里下一步点哪里,一千篇论文分到哪一类?从官方能力、独立测试到开发者作品,看 Jev 怎样与聊天模型配合。
01作品一EN
查一趟航班:选择按钮与填写文字分开做
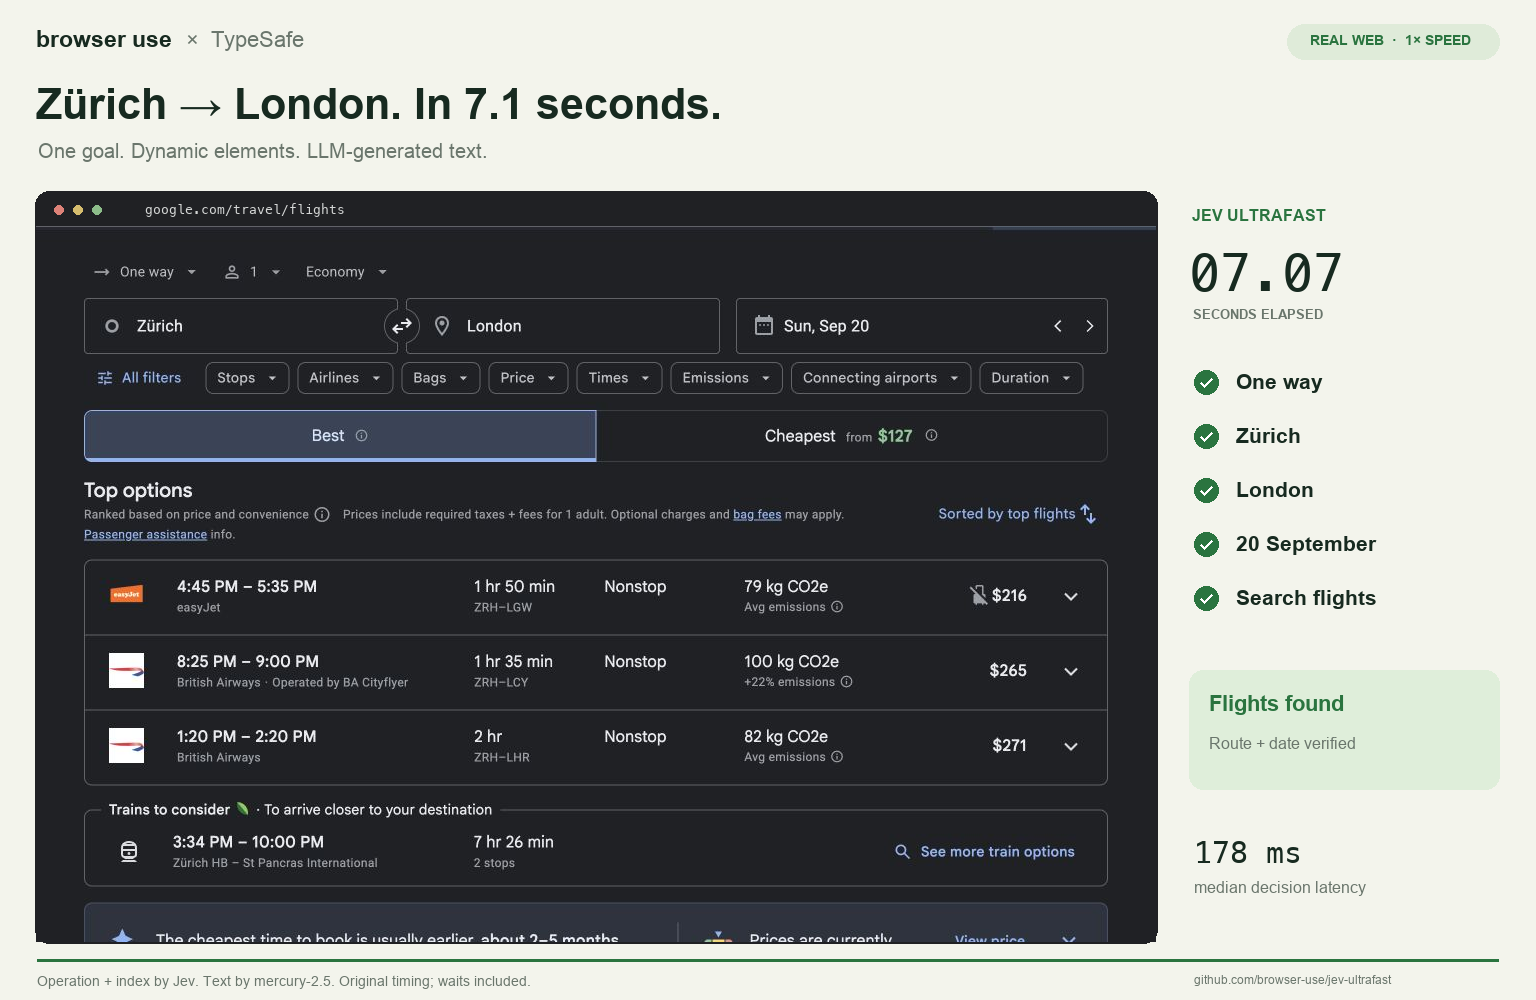
Browser Use 的公开演示从一句要求开始:查找 9 月 20 日苏黎世到伦敦、单程、1 位成人的经济舱航班。Jev 从网页控件清单中选择下一步和目标;需要输入城市时,Mercury 2.5 负责生成文字。最终画面显示匹配航班,没有选票或预订。
作者记录的任务耗时为 7.073 秒,从首次读取首页之后开始计算,包含模型调用、填字与网页加载。视频、测量记录和代码都公开,适合一起看“选哪一步”怎样变成屏幕上的操作。
- 观看作者航班搜索演示原速记录;完成到显示结果。
- 打开作品与运行说明开发者可查看模型分工、代码与复现入口。
- Browser Use 素材许可MIT · Copyright 2026 Browser Use。
来源与补充
这是作者的一次公开任务记录,本站未运行付费模型复现。Jev 收到的是网页的文本与控件信息,演示画面不代表它直接读取图片。
- Browser Use · jev-ultrafast ↗作者代码与作品完整任务、模型分工与演示。
- 航班演示的测量记录 ↗作者测试条件初始导航与独立结果复核不计入任务时钟。
02先看用途EN
一封邮件该交给谁,也能成为 AI 的工作
- 读入材料
邮件内容+分类标准
- 作出判断
从售后、账单、合作中选择
- 继续处理
软件转交;需要时再生成回复
编辑示意,说明一种分工;并非本站实测返回值。 查看依据 ↗
收到一封邮件,先判断它属于售后、账单还是合作,再交给对应的人处理。这类反复出现的小判断,是 Jev 要做的事。TypeSafe AI 在 2026 年 9 月 15 日发布它,称这类专注于快速判断的模型为 System One。
使用时先给它材料和问题,再定义可以返回哪些选项。它能选择类别、按给定刻度评分,或判断一句话成立的可能性;多个问题可以一起处理。结果直接交给软件继续执行,回复邮件的文字则可以由另一个模型生成。
来源与补充
- TypeSafe:Jev 发布说明 ↗官方发布 · 9 月 15 日首次公开发布与产品定位。
- TypeSafe 快速开始 ↗官方使用示例同一份材料同时提出分类、评分与真假问题。
03建立参照EN
固定规则、Jev 和聊天模型,分别接哪一步
同样是处理邮件,“附件大于 20 MB”可以直接用规则判断;“这封邮件在催进度吗”需要理解语气和上下文;“请写一封得体的回复”需要生成文字。把这三步拆开,就更容易理解 Jev 在整件事里的位置。下表是工作分工示例。
| 这一步要做什么 | 可以怎样处理 | 交付什么 |
|---|---|---|
| 检查附件大小 | 固定规则 | 超过或未超过上限 |
| 判断意图与归属 | Jev;语言模型也能做分类 | 预设选项与概率 |
| 起草回复 | 能生成文字的语言模型 | 可以继续修改的文字 |
来源与补充
Jev 的概率和置信度可帮助软件决定何时继续、何时交给别的处理方式。它们不是单次答案正确的保证;输出符合预设格式,也仍可能选错。
- System One 的输入与输出 ↗官方定义支持的判断类型,以及校准不保证单次正确的说明。
- 置信度怎样参与后续处理 ↗官方文档Choice、Score 的置信度及不同处理分支。
04官方与实测EN
把速度、费用和接手多少任务放在一起看
官方展示的 193.6 倍速度、444.6 倍成本优势,来自自建的工作流程评估,参照答案取 Astra 与 Fable 的平均预测。它说明特定判断流程的表现,不能直接换成所有任务的快慢排行。
Nexus 另用同一批 469 个案例比较助手的检查步骤。Jev 接手其中 58%,其余交回规则。把回退也算进去,Jev 总共错 90 次,Sonnet 5 错 92 次;这次实验更鲜明的差别在等待与费用。
| 方案 | 模型接手比例 | 总错误 | 典型耗时 / 单次费用 |
|---|---|---|---|
| 仅规则 | 规则处理全部 | 148 | 约 50 ms / $0 |
| Sonnet 5 +规则 | 67% | 92 | 6.3 秒 / $0.0178 |
| Jev +规则 | 58% | 90 | 0.66 秒 / $0.00008 |
来源与补充
作者实测,本站未复跑。该组主要由 AI 标注;模型阈值调优不对等,LLM 耗时包含启动工具。结果适用于这批检查。
- TypeSafe 工作流程评估说明 ↗厂商评估公开倍数的任务、参照与测试条件。
- Nexus:在真实助手检查中测试 Jev ↗作者实测 · 9 月 17 日比较表保留回退后的总错误、耗时与费用。
05作品二EN
一千多篇论文:先写摘要,再尝试更快分类
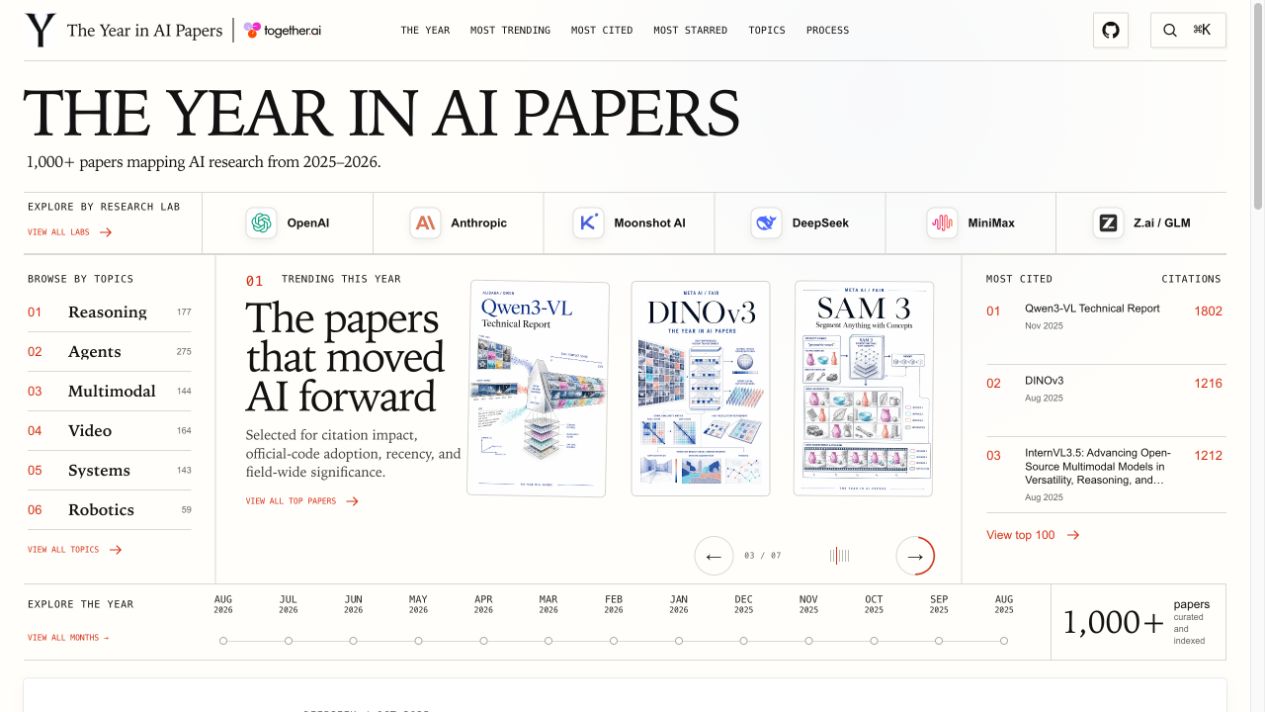
1kpapers 已经把 1,018 篇论文整理成可以按研究方向、实验室和时间浏览的目录。Hassan 在 9 月 17 日报告了一次 Jev 实验:把论文标题、DeepSeek V4 Flash 摘要和 24 个主题选项交给 Jev,分类总费用为 0.08 美元,每篇延迟中位数 256 毫秒。
摘要与分类是两笔工作:网站原有 1,000 篇摘要实验的 DeepSeek 推理费用为 3.99 美元。9 月 20 日读取的公开分类代码仍采用原有模型流程,因此这里展示的是现有论文目录与新增分类实验,不能据此认定在线标签已经全部换成 Jev。
- 打开论文目录先选一个熟悉的研究方向,看摘要怎样帮助浏览。
- 看作者的 Jev 分类实验分类费用与耗时来自作者报告。
来源与补充
- Hassan 的分类实验原帖 ↗作者报告 · 9 月 17 日论文数量、24 个主题选项与分类用量。
- 1kpapers:已有作品与摘要实验 ↗作者公开作品现有目录、摘要成本与完整方法。
- 1kpapers 公开分类代码 ↗源码 · 9 月 20 日读取当前公开流程仍使用 Together 上的 DeepSeek 与 Qwen。
06入口与费用EN
免费促销已结束:现在从哪里试、怎样计费
费用单独核对:2026 年 10 月 4 日。9 月 25 日结束的 Vercel 免费促销已经过期。当时 Vercel AI Gateway 页面列出 TypeSafe AI 与 DigitalOcean 两个入口,输入价格均为每百万 token 0.04 美元起,均不适用 Free AI Gateway Credit;输出栏未列价格,不能据此理解为免费。接入需网关 API 凭据,账户可用性与实际账单以平台为准。
TypeSafe 直接 API 是另一个入口:10 月 4 日核对时,官方文档列出 Jev 1.13,每百万输入 token 0.042 美元,输出 token 免费。控制台提供账号与试用入口;这项直接 API 单价不能替代 Vercel 的计费条件。10 月 16 日的版本与容量补充见下方新章。
Jev 当前读取文本,图片或音频需要先转成可读材料。官方还说明英文表现最好;面向中文邮件、评论或资料分类时,应先拿自己的样本看看。模型调用便宜,不等于整个应用的摘要、运行和其他模型费用都包含在内。
- 进入 TypeSafe 控制台官方账号与试用入口。
- 查看 Vercel 当前价格价格与免费额度适用性 · 10 月 4 日核对。
来源与补充
历史观察保留:9 月 20 日 TypeSafe 直接 API 为每百万输入 token 0.042 美元、输出免费;同日 Vercel Jev 页面曾标注输入与输出免费,并写明促销于 9 月 25 日结束。这是当时的入口记录,不代表今天仍免费。
- TypeSafe 模型与价格 ↗官方文档 · 10 月 4 日费用复核Jev 1.13 直接 API 单价与输出免费;9 月 20 日原观察保留在历史说明。
- Vercel AI Gateway · Jev ↗接入平台 · 10 月 4 日费用复核两个入口的输入单价、输出栏未列价及不适用免费额度;9 月 25 日已结束的促销转入历史说明。
07后续对照 · 10 月 2 日EN
另一个决策模型:先选哪一步,再让软件执行
Jev 先做判断,再由软件继续。10 月 1 日,Cloudflare 推出 Clef 与 Clef-flash,把这项分工放进另一套模型:先给材料、问题与允许的答案,再返回各选项的概率。它们是 Cloudflare 的产品;固定选项限制了输出范围,仍可能选错。
官方示例是一条“所有客户结账失败,已持续一小时”的消息。开发者同时问是否紧急、该交给账单/技术/销售哪一组,以及影响程度。软件可以据概率分派、升级或交给人复核。这不是让模型写一封回复,也不是收到一个选项就自动完成维修;后续动作还要由应用接上。
Cloudflare 还报告了内部域名分类:通过 Browser Run 抓取、渲染网页并分类,Clef 用时 2.2 秒,gpt-oss-120b 在同一流程用时 4.7 秒。这里计入了网页处理,是厂商的一次任务报告;不能拿它与前面的 Jev 航班搜索或助手检查硬比,也不能当成所有网站的固定等待。
10 月 2 日读取的 Workers AI 文档列出 Clef 27B、Clef-flash 9B;每百万输入 token 分别为 0.24 与 0.09 美元,需通过开发者账户接入。开源权重也已公布。对一件实际工作,接入后还要看选错多少、何时交给人,以及网页处理和后续模型一起产生的费用。
来源与补充
域名流程来自 Cloudflare 的内部报告,本站未复跑;它包含网页抓取、渲染与分类,和单独一次模型请求的耗时范围不同。
- Cloudflare:Clef 发布与域名流程 ↗厂商发布与内部报告 · 10 月 1 日固定选项、官方输入示例;网页抓取、渲染和分类的计时。
- Workers AI:Clef 接口 ↗官方接入文档 · 10 月 2 日读取27B、65,536 token 上下文和每百万输入 token 0.24 美元;示例没有实测返回概率。
- Workers AI:Clef-flash 接口 ↗官方接入文档 · 10 月 2 日读取9B、65,536 token 上下文和每百万输入 token 0.09 美元。
- Cloudflare:开放权重模型卡 ↗原始模型与许可Apache 2.0 权重、底座与模型使用方式;本轮未下载权重推理。
08接回已有使用EN
你常用的 AI 助手,可以多一种分工方式
如果你在用 GPT、Opus、Grok 等助手写作、编程或整理材料,理解 Jev 可以从刚才的两个作品开始:写城市名称和选择网页按钮分开,写论文摘要和判断分类分开。改变的是一项工作内部怎样分配任务,不必把新模型的出现都理解为换一个聊天订阅。
Astra 专题里的 Blender 作品展示了模型怎样把描述变成可编辑场景。接着看 Jev,可以多问一个问题:这项工作里,哪些步骤需要创造新内容,哪些只是从已有选择里作判断?这是我们从这些作品得到的使用思路,实际怎样搭配仍取决于应用接入。
- 继续看 Astra 的可编辑三维作品从生成作品这一侧,理解模型分工。
- 看官方怎样拆分智能家居指令识别设备与动作,再由程序执行。
来源与补充
- TypeSafe 智能家居示例 ↗官方工作流程展示语义判断、文字处理与执行的分工。
09作品接续 · 10 月 11 日读取EN
吃豆人走到下一个路口,AI 再选一次方向
- 看吃豆人的默认录制回放外部原作品;默认是录制。切到实时观看或 Play 模式时,另看账号与共享额度条件。
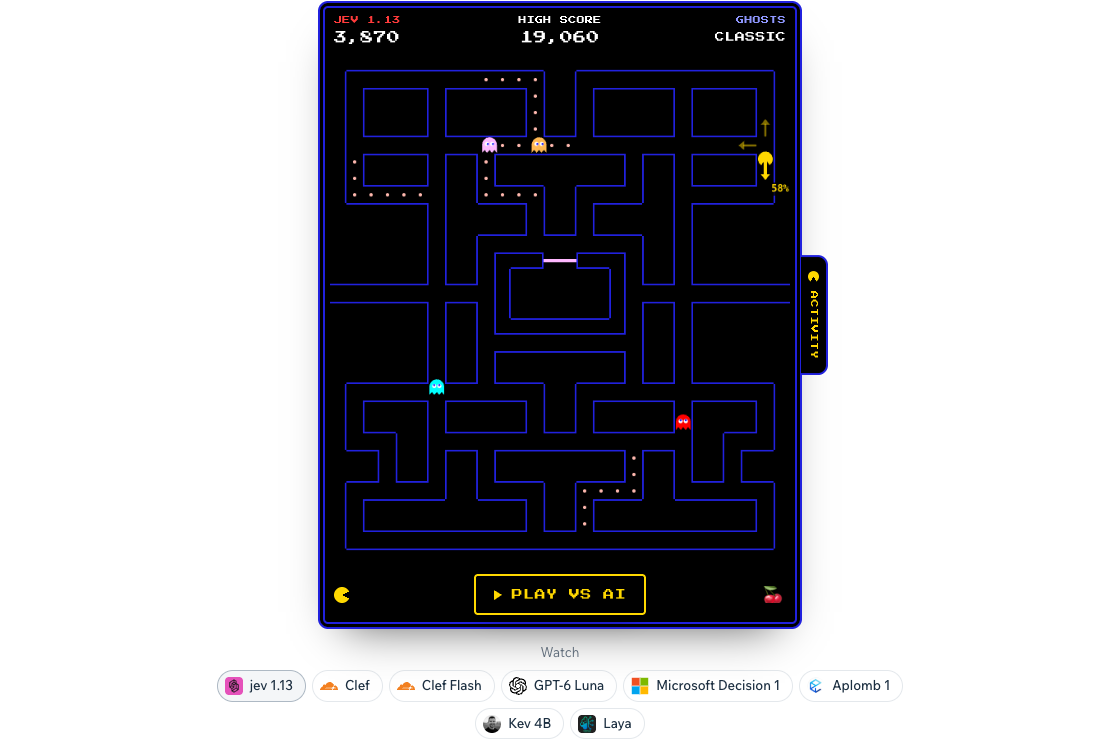
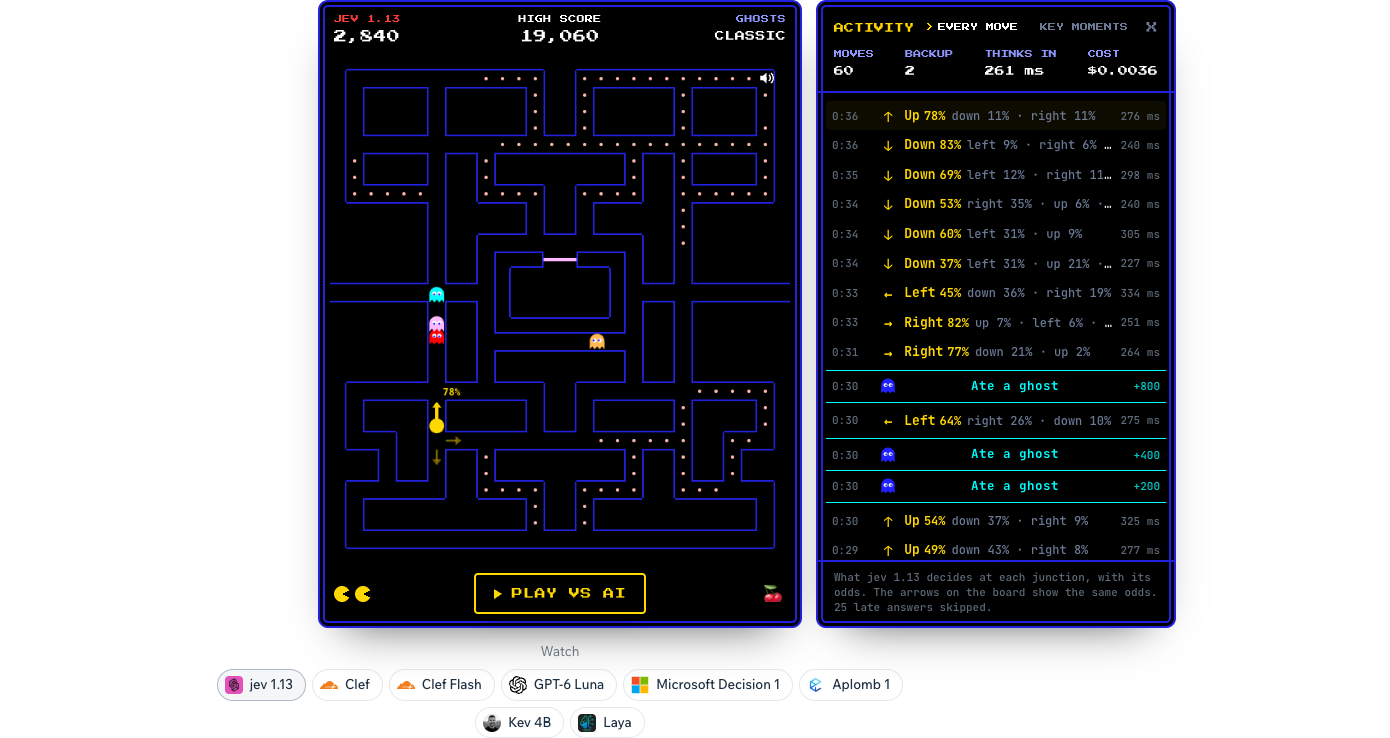
迷宫里的吃豆人走到路口,画面上显示各方向的概率,再沿选定方向继续。Opper 的 Jevman 把密集的小判断做成了一件可以观看的作品:默认打开的是 Jev 1.13 的录制回放,旁边能展开每次决定。本站本轮看到默认回放分数推进至 3870;原件标注 10 月 6 日,10 月 11 日回读文件与昨晚一致。读者先看一次走法,再看重复游戏的结果,更容易理解概率怎样接到动作。
模型收到的是软件整理的 JSON:迷宫字符格、角色位置与方向、鬼怪状态、剩余豆子和果实。程序还计算合法方向、距离和危险线索,再把它们变成允许的选项。模型选择一个方向,软件执行并更新状态,到下一个路口继续问;需要时也会在走廊中问是否折返。画面让人看见过程,判断输入则来自这份结构化材料。
这套循环也要处理等待和环境变化。基准规定,发送后超过两秒仍未得到可用答案,或调用出错、答案无效时,程序用简单规则接手;果实等状态变化,也会让旧决定失效。表中的回退比例按决定次数计算,因此最后分数来自模型选择、时延和规则共同参与的游戏。快速回答能减少等待,但具体走法仍决定能吃多少豆子、躲过多少次追赶。
作者公开的自测结果文件保留八个型号,每个玩 100 局,用相同经典迷宫、脚本鬼怪、三条命和最多五分钟的规则;社区提交另列。各模型使用同一输入格式,但走法和等待不同,后续看到的状态也不同,公开方法没有配对随机种子的记录。下表只取其中三款:±为约两倍均值标准误,按作者的合成误差规则,三者在八组自测结果中处于并列首组。2750、2568、2538不能单独用来宣布胜者。
耗时与费用也有各自范围。延迟均值取收到成功回复的调用,包含上游网络与读取回复;预热、超时和整局时长不合成这一个数字。每局费用来自游戏记录的调用花费,不是完整应用账单,也不能当作今天各平台的 token 单价。这里引用 Opper 作者的游戏测试,本站没有跑这八组 100 局;完整型号、误差和方法仍可从原榜继续核对。
这接回前面的航班搜索与固定选项:程序先把环境整理成可判断的材料,模型选下一步,再由软件执行。游戏把这项分工重复得更密集,还能看见决定之后的反馈。参照中的 Luna 走的是 Decisions 接口:OpenAI 官方目前仅支持 gpt-6-luna,Opper 把它接成 System One 形状。它在这里的走法与费用,和普通 Luna 聊天、写代码或文字智能指数分别理解。
| 测试型号 / 接口 | 平均分 ± 约 2SE | 成功调用均值 | 决定回退比例 | 记录费用 / 局 |
|---|---|---|---|---|
| Jev 1.13 · System One | 2750 ± 218 | 290 ms | 3.4% | $0.00593 |
| GPT-6 Luna · Decisions | 2568 ± 150 | 179 ms | 4.4% | $0.00968 |
| Clef-flash · 决策接口 | 2538 ± 120 | 256 ms | 2.6% | $0.00362 |
来源与补充
- Opper · Jevman 原作品 ↗作者作品 · 默认录制10 月 6 日 Jev 1.13 录制;源文件 10 月 11 日回读一致,实时模式另看接入。
- Opper · 作者榜原 JSON ↗作者 100 局测试 · 10 月 11 日读取八型号、每型 100 局、benchVersion 1;完整记录与本表三行数据。
- 游戏输入与下一步选项 ↗原作者固定源码JSON 状态、允许的方向、程序预先计算的距离与危险,以及概率返回。
- 重复游戏与统计方法 ↗原作者固定源码标准误、合成误差下的首组并列、按调用与决定分别统计。
- 测试循环、预热与回退 ↗原作者固定源码统一起局规则、发送后两秒期限、预热不计入单局统计;并非相同观察轨迹。
- 测试型号与 Opper 路由 ↗原作者固定源码typesafe/jev-1.13.0、openai/gpt-6-luna-decisions;Clef-flash 的保留标识映射到 cloudflare:global/clef-flash。
- TypeSafe · Jev 当前型号 ↗官方文档 · 10 月 11 日读取jev-1.13.0 是文字型 System One;JSON 属于文字材料,不能据演示说它读取像素。
- OpenAI · Decisions API ↗官方文档 · 10 月 11 日读取Public beta、gpt-6-luna 和专用接口;原生 predicate/choice/score 与 Opper 的统一形状区分。
- Cloudflare · Clef-flash 原说明 ↗官方文档 · 10 月 11 日读取当前托管条件单独核对;原游戏记录费用不自动替换成新的 token 单价。
10后续选择 · 10 月 9 日发布,10 月 10 日核对EN
Clef-flash 更便宜了,能读的材料也变短了
上一章用结账失败的消息,说明模型怎样选择紧急程度、归属与严重等级。10 月 2 日记录的 Clef-flash 单价是每百万输入 token $0.09。Cloudflare 在 10 月 9 日降至 $0.038,同时把托管窗口从此前宣传的 64k 缩至 24k。短消息分类多了更便宜的选择,长材料则要重新看能否完整送入。下表引用 Workers AI 的 Cloudflare 托管标价,官方文档没有另分地区列价;其他网关的账单要按各自入口核对。
这里的窗口要容纳材料、问题和媒体。10 月 10 日文档列 Flash 为 24,576 token:图片先换算为输入 token,Omni 的音频和视频也按时长换算,都按该型号输入单价计费,输出 token 不收费。如果媒体和问题本身超出窗口,请求会失败;否则文字状态可能被截短。把一大批邮件一次塞进去时,不能只比较单价,还要确认哪部分材料实际参与了判断。
这次改的是托管服务条件。Cloudflare 说明 Flash 的公开权重没有改动,并称自行部署可用 256k 窗口;这不等于托管入口仍能接收同样长度,也不保证任意设备都能承载。当前 Clef 托管窗口为 65,536,Omni 为 64,000,具体数值分别保留。选择时先看自己的材料长度,再看运行环境和费用,不能把权重能力、服务限额与实际设备表现合成一个承诺。
新增 Clef-omni 把声音也接进固定选项判断。官方文档允许文字、JSON、图片、音频或视频,仍返回每个允许选项的概率。厂商报告一次 21 秒带声音视频的打分约用 1.5 秒,这是发布中的测时示例,本文未复做,也没有验证持续视频代理。它提供的下一种分工是:让已有录音或片段回答一个范围明确的问题,再由软件决定下一步;是否判断正确、何时交给人,仍需用自己的样本看。
| 型号与阶段 | 输入单价 | 托管窗口 | 当前文档的输入范围 |
|---|---|---|---|
| Clef-flash · 原条件 | $0.09 | 64k(此前宣传) | 历史条件;当前输入另看下一行 |
| Clef-flash · 10 月 9 日调整 | $0.038 | 24,576 | 文字 / JSON、图像、视频 |
| Clef · 当前 | $0.24 | 65,536 | 文字 / JSON、图像、视频 |
| Clef-omni · 新型号 | $0.15 | 64,000 | 文字 / JSON、图像、音频、视频 |
来源与补充
托管接入需要开发者账户及相应权限。本文读取发布、模型卡和接口文档,未调用收费模型;价格与上下文是本章独立核对的条件,不改写旧章的观察日期。
- Cloudflare · 新型号与服务调整 ↗官方发布 · 10 月 9 日降价、托管窗口缩短、未改权重与厂商音视频测时分别说明。
- Workers AI · Clef-flash ↗官方接口 · 10 月 10 日读取@cf/cloudflare/clef-flash:$0.038、24,576 token,以及媒体与问题的窗口处理。
- Workers AI · Clef ↗官方接口 · 10 月 10 日读取@cf/cloudflare/clef:$0.24、65,536 token;文字、图像与视频输入。
- Workers AI · Clef-omni ↗官方接口 · 10 月 10 日读取@cf/cloudflare/clef-omni:$0.15、64,000 token;音频/视频换算计费与选项概率输出。
- Clef-omni · 固定模型卡 ↗官方权重说明30B-A3B 架构和一次前向的固定选项输出;不把语音输出权重当作本接口能力。
11版本与材料 · 10 月 16 日核对EN
Jev 1.14 已预览,为什么 latest 仍是 1.13?
TypeSafe 的当前文档把 10 月 14 日列为 Jev 1.14 的可用日期,但稳定入口 jev-latest 仍指向 1.13,jev-preview 才指向 1.14。新版本出现,不代表原有程序已经换了模型。每次响应会返回实际版本;如果已经按旧版调整过分类阈值,可以先固定版本,再用同一批材料比较是否要切换。
两版默认都要同时满足两个容量条件:一份请求中,材料加全部问题不超过 64k token;材料加任意一个问题不超过 32k。问题没有另设数量上限,但仍受这两项约束。例如给一封邮件和处理规则,再同时问“是否要求退款”“交给哪个组”,需要把材料和问题一起计算,不能把 64k 当作每道问题都能使用的额度。
确实需要更长材料时,两版都可以逐次请求打开 Long Context,把两项上限都提高到 262k,输入单价不变。官方同时提醒:超出默认范围的长上下文更慢、准确性也较低。这是在说明该模式的取舍,不能理解成 1.14 比 1.13 退步;上限本身也不是一份长文已经被正确理解的证明。
Jev 仍以文字或结构化文字为输入,返回预设选项、评分或概率;英文是主要训练语言,中文材料需要另看实际表现。直接 API 两版均为每百万输入 token 0.042 美元、输出免费。可以先选一批自己能核对的邮件或资料,用固定选项比较两版的选择与不确定性,再决定哪些结果交给程序、哪些留给人;概率校准也不保证某一次判断正确。
| 请求中的名称 | 当前实际版本 | 定位 |
|---|---|---|
| jev-latest | jev-1.13.0 | 稳定版;SDK 默认 |
| jev-preview | jev-1.14.0 | 较新的预览版 |
来源与补充
Long Context 通过 TypeSafe-Danger-Zone-Long-Context: true 请求头开启。这里保留可核对的配置名;没有代读者提交材料、填入 API key 或执行模型调用。
- TypeSafe · 当前型号与别名 ↗官方文档 · 10 月 16 日回读1.14 的 10 月 14 日可用日期、稳定与预览映射、容量与直接 API 条件。
- TypeSafe · System One ↗官方输入与输出定义文字输入、预设判断与概率;校准不保证单次答案正确。
- TypeSafe · 概率与置信度 ↗官方方法说明用不确定性决定继续、回退或人工检查,阈值仍需具体材料验证。
12接续比较 · 10月23日文档EN
Decisions正式可用:把邮件分对组,还要分清概率与评分
一封邮件说“同一笔订单扣了两次钱,请退款”。程序至少有三件事要判断:是否提出退款、交给哪个组、问题有多严重。10月23日回读的OpenAI文档已将Decisions API标为正式可用,仍使用现有gpt-6-luna。它可把文字、图片与结构化材料变成有限类型的答案;下面用这封虚构邮件说明分工,不是本站调用结果。
三种问题不能互换:predicate估计一个条件成立的概率;choice从给定类别中选择;score按有序等级的概率分布计算分数。若给“仅外观问题、尚有替代办法、完全阻塞”编号0、1、2,分数可能落在两级之间。它不是正确率,也不是付款或退款的许可。真正改变订单的动作仍要由应用执行。
实际接入还要处理没有答案的情形。正式接口允许某道问题返回refusal,其他问题仍可有答案;不能把拒答填成“否”或零分。choice与score还各有confidence及选项概率,但它们与等级分数是不同字段。对这封邮件,先分类再决定是否退款,也属于两个决策:识别“在要求退款”并没有核实重复扣款,更没有证明符合退款条件。
把阈值放回自己的材料才有意义。作为编辑建议,可以先人工标注一批中文邮件,保留转错组、漏掉紧急请求以及需要人接手的例子,再比较自动分流比例与错误数;误发退款和多请一次人工确认,代价也不同。Jev文档仍提醒英文表现最好,latest仍是1.13、preview才是1.14。和Luna比较时固定版本、问题、输入及接手规则,不能从一个概率数字推断谁普遍更可靠。
费用也须按当前入口核算:Decisions列出的未缓存输入价为每百万token 0.10美元,输出不收费;现在有提示缓存,读取有折扣、写入收费,不宜沿用公测时“没有缓存读写费用”的说法。Jev直接API仍为每百万输入0.042美元、输出免费。单价不同不等于完成同一件事的总费用不同:输入长度、重试、拒答与人工接手都应计入。
此前Jevman的100局记录仍是原作者在当时接口与适配层上的实验,不随这次GA变成新版测试。OpenAI所称约十倍速度是厂商陈述,本章没有做同题计时或付费调用。新变化值得接续的是:开发者已有另一个正式判断入口;究竟怎样分流才省事、少出错,要连同真实材料和人的接手一起比较。
| 要弄清什么 | 类型 | 结果怎样理解 |
|---|---|---|
| 是否提出退款? | predicate | 条件成立的概率,不是退款批准 |
| 交给账单、售后还是合作组? | choice | 预先定义的类别;不直接发送邮件 |
| 按约定的等级,影响有多大? | score | 等级索引的概率加权分数,不是置信度 |
来源与补充
图与表是编辑解释;分类、问题等级及接手规则由应用定义。参考文档可在独立问题中返回拒答,本站没有使用账户、API key或读者邮件。
- OpenAI:Decisions当前指南 ↗官方文档 · 10月23日读取GA状态、有限答案、阈值与当前缓存计费;没有从文档推定自己的账户已可调用。
- Decisions正式接口定义 ↗官方接口定义 · 10月23日读取逐问题的类型、confidence、概率及拒答;应用执行动作。
- TypeSafe:当前型号与计费 ↗官方文档 · 10月23日读取1.13/1.14别名、文字输入、语言条件和直接API单价;不是与Luna的同题测试。