模型与评测
Qwen4-Max 发布说明全文读取:新架构三件套,和一笔 58% 的成本账
阿里 11 月 16 日正式发布的 Qwen4-Max,官方博客正文在发布当天是脚本渲染、抓不到全文,本站当晚只能按转述口径把型号收进目录和 AA 榜;11 月 17 日晨用浏览器渲染把全文读全,转述与官方口径的出入也随之清楚:官方账目是 Work360 单任务平均费用从 26.58 元降到 11.16 元(约 58%),而流通的转述标题写的是「超 60%/62%」。架构上,Qwen4-Max 是 Qwen4 系列新结构的第一款:2.4 万亿主干参数、每 token 激活 71B、另有 328B N-gram Embedding 参数;每四层里三层是 Gated DeltaNet(把历史压成固定大小状态),一层 Qwen Sparse Attention 按块挑相关上下文;残差流扩成四条并行分支靠门控读写;第二层用局部 N-gram 查表扩容量。官方称预训练全程无 loss spike,知识/代码/问答/STEM 四类内部评测 BPB 比前代基座低约 5–13%、激活参数少约 25%。能力口径:Work360 52.69 对前代 47.74,同分下 token 消耗 Work360 档 Xhigh/High 降约 24%/35%、Terminal-Bench 4.0 降约 48%/49%,API 全面降价且缓存命中价大幅下调。16 面板官方对比图里,它对前代 16 块全部领先,但对其他模型只在 4 块居首(DeepSWE、Agents' Last Exam、HLAB-Vals、BioMysteryBench),多数知识工作面板是 Claude Opus 5.5 更高;评测说明注明多项分数引自第三方榜单。工厂、律所、ICU 与 48 小时冷却液闭环是四个官方案例演示,本站未复现;权重未开放,官方称系列小尺寸模型将陆续开源——这是值得跟踪的承诺。AA 综合榜本站 11-16 晚以 43 分入列,11-17 复读未变,与自报 Work360 数字互不替代。
本文依据三个来源写成:Qwen 官方博客《Qwen4-Max: Your New Teammate Has Arrived》全文(本站 11-16 只直读到页标题与发布事实,11-17 晨经浏览器渲染读全正文);IT之家 11-16 转述稿(已全文读取,用于核对转述口径);本站 11-16 晚与 11-17 晨两次 AA 榜直连复读。官方的架构、基准与案例数字全部为厂商自报,独立榜单分数(AA 43)单独记录、互不替代;官方案例为厂商演示,本站未运行模型、未复现任何任务;流通转述与官方口径不一致处按原文分列。
从预览到读全说明:九天里发生了什么
时间线不长,但每一步的口径都不一样。11 月 11 日,Qwen 开出 qwen4-max-preview 限时预览(当时只有预览页可读,本站记录为 working);11 月 16 日正式发布,官方博客当天上午就能读到标题——《Qwen4-Max: Your New Teammate Has Arrived》,中文页写作「新同事,已就位」——但正文是脚本渲染,抓下来只有壳。当晚本站做了两件事:按 IT之家转述口径完成目录条目、公司演进行,并把它收进 AA 综合榜(源表当晚出现 43 分行,scope 34→35);同时明确记下缺口——正文未读全,数字是转述口径。
11 月 17 日晨用浏览器渲染读全正文后,账目可以按一级来源重录了。多数数字与转述一致:Work360 52.69 对 47.74、token 消耗降幅、开源承诺都对得上;有一处对不上——流通口径说「任务成本降低超 60%」(英文聚合标题写作 62%),官方原文是 Work360 单任务平均费用从 26.58 元降到 11.16 元,降幅 58%。这不是谁的错,但它演示了为什么要回头读原文:转述链每过一手都会被磨圆一次,58% 和「超 60%」在标题里没有区别,在一笔真实的 API 账单里有。
发布当天还有一条中文聚合转述称 Qwen4-Max「登顶 Agent Arena 中国模型榜首、阿里升至总榜第 14」,出处指向 Arena 的一条社媒帖——原帖本站未读到(登出状态不可读),不作为事实记录;它属于本站已记录的同一方向信号:独立榜与官方自报开始互相指认,等可核来源出现再接。
来源与延伸阅读
- Qwen 官方博客:Qwen4-Max: Your New Teammate Has Arrived官方发布说明 · 本站 11-16 仅直读标题与发布事实,11-17 晨浏览器渲染读全正文全文读取。核对关键声明:2.4T 主干参数、每 token 激活 71B、另有 328B N-gram Embedding 参数;原生视觉;1M 上下文。架构三项:GDN+QSA(每四层三层 Gated DeltaNet 压缩历史为固定状态、一层 QSA 经轻量 Indexer 按块选上下文)、Gated Residual(残差流扩为四条并行分支加动态读写门控)、N-gram Embedding(第二层按局部上下文查表)。预训练称无 loss spike;Qwen4-Max-Base 在知识/代码/问答/STEM 四类内部评测 BPB 为五参评模型最低,较 Qwen3.8-Max-Base 各领域降约 5–13%、每 token 激活参数少约 25%。Work360 52.69 对 Qwen3.8-Max 47.74(26 个一级/182 个二级/721 个三级领域分类);token 消耗 Work360 Xhigh/High 降约 24%/35%、Terminal-Bench 4.0 降约 48%/49%;API 全面降价、缓存命中价大幅下调;Work360 单任务平均费用 26.58→11.16 元、降 58%。Live Delivery 持续交付并开源 Qwen-Live-Delivery-Plugin;云资源调度三例(标注调用费用 −10.42%、GPU 空闲容量时长 +4.62%、CPU 重调度求解提速 14.61 倍)。案例:三丰智能/统联精密加工编程约 475→24 分钟(约 −95%)、198 份底稿 IPO 尽调出 86 页报告、危重症病历 1,433 张影像、48 小时冷却液分子闭环(270 万候选、4 轮迭代)、NLRP3 分子优化(454 次工具调用、RBFE 约 3.6 倍)。安全:Last Secure Code Bench 函数级功能与安全双通过 22.0%→31.8%、三粒度同安全 8%→14.7%;CBRN 内部评测称无过度拒答、未发现显著能力抬升。评测说明注明 JobBench 为自家更新数据集,APEX-Agents 引 Mercor、AA-Briefcase/AutomationBench-AA 引 Artificial Analysis、CodeArena/AgentArena 引 Arena、HLAB-Vals 引 Vals Index、Agents' Last Exam 引原榜。入口:千问 AI 平台(Token Plan 或 API)、千问办公、Qoder CN、千问 App、Qwen Studio。系列小尺寸模型称将陆续开源。文末 BibTeX 标注 2026 年 11 月。
- IT之家转述:Qwen4-Max 正式上线转述稿 · 本站 11-16 全文读取 · 标题口径为「任务成本降低超 60%」发布当天本站仅能读到官方博客页标题,目录与榜单按此转述口径先行记录(Work360 52.69/47.74、token 降幅、开源承诺)。11-17 官方全文读全后核对:Work360 与 token 数字与官方一致;「任务成本降低超 60%」与官方的 58%(26.58→11.16 元)不一致,流通的英文聚合标题更写作 62%。本站以官方口径 58% 为准,转述差异照录。
新架构三件套:GDN+QSA、四路残差、N-gram 词表
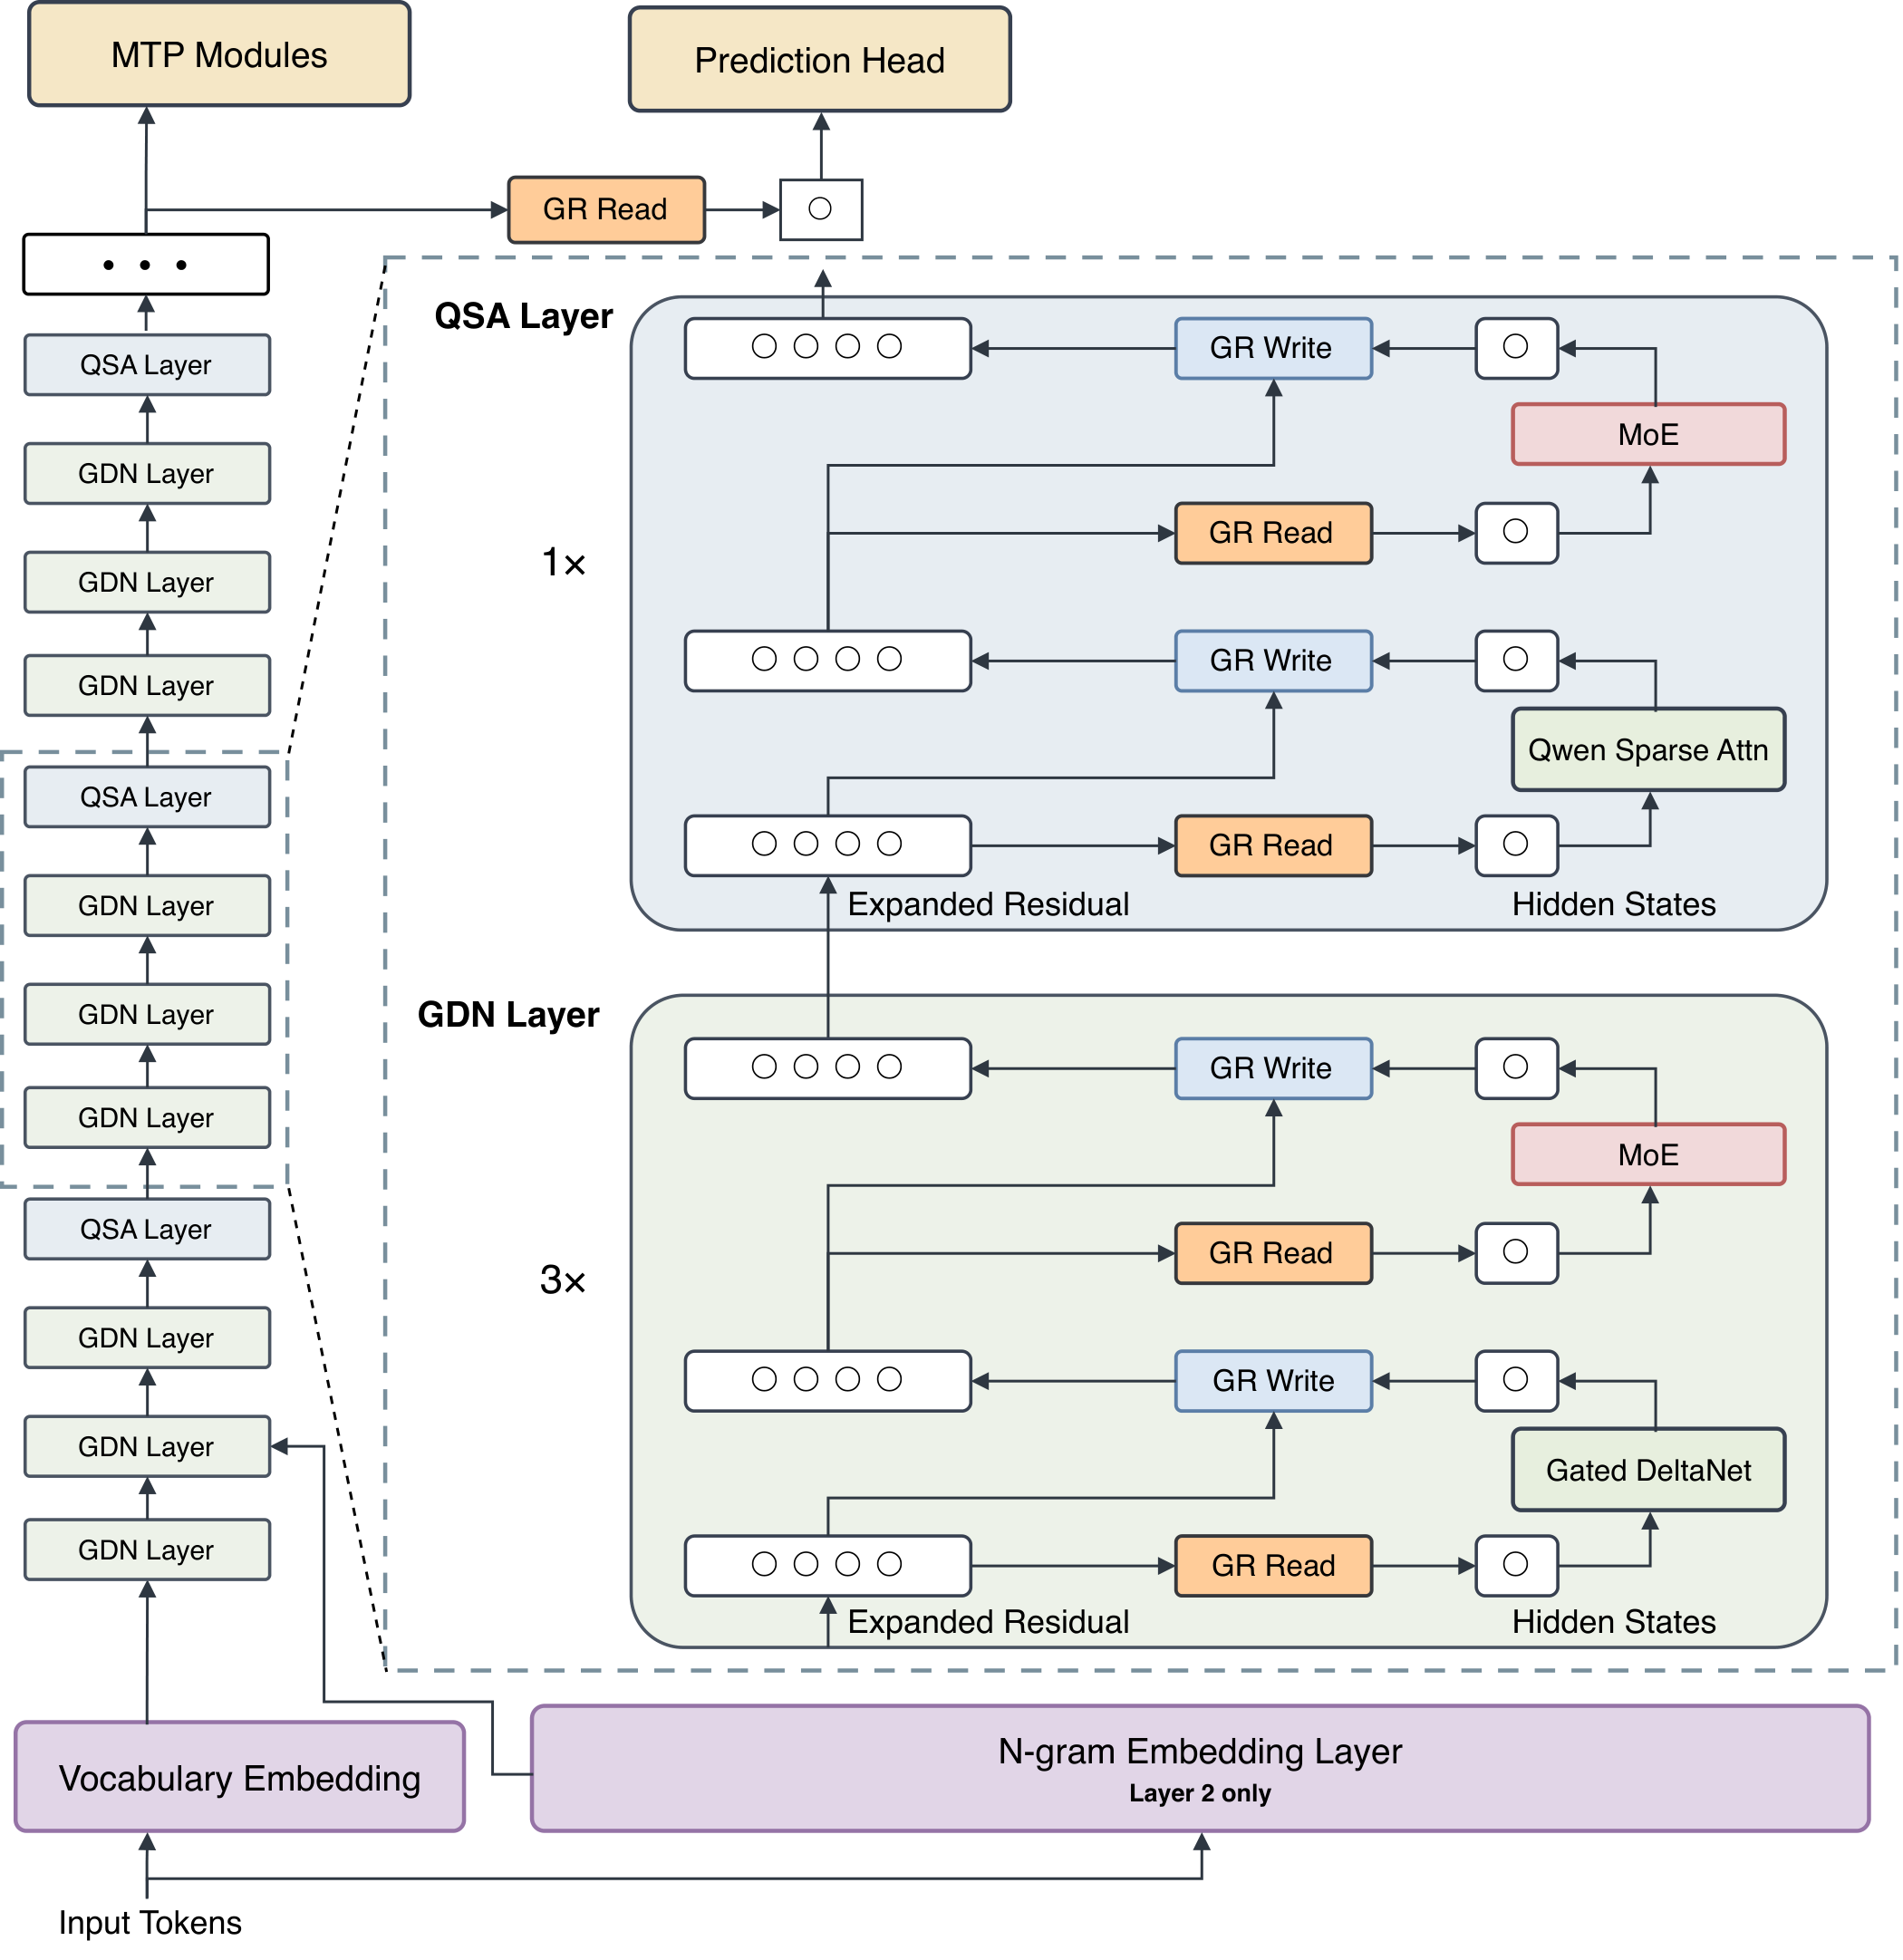
Qwen4-Max 是 Qwen4 系列新结构的第一款:2.4 万亿主干参数,每 token 激活 71B,另有 328B N-gram Embedding 参数。官方把升级归纳为围绕 Attention、Residual、Embedding 三处的系统改造。注意力侧是「GDN + Qwen Sparse Attention(QSA)」的组合:每四层中,三层 Gated DeltaNet 把历史信息压缩成固定大小的状态——长对话不再随长度线性撑大注意力计算;剩下的一层 QSA 通过轻量级 Indexer 以块为单位挑选相关上下文,降低长序列的注意力与索引开销。这是「百万 token 上下文」在结构上的来路:不是把标准注意力硬撑到百万,而是让大部分层根本不面对全序列。
残差侧的 Gated Residual 把残差流从一条扩成四条并行分支,靠动态读写门控(图里的 GR Read/GR Write)决定信息跨层怎么走,官方称这改善了训练稳定性。词表侧的 N-gram Embedding 在第二层按局部上下文查表,给模型便宜的局部模式表示,以较低开销扩容量。三条改造合起来,官方给出的训练证据是:2.4T 规模预训练全程无 loss spike;Qwen4-Max-Base 在知识、代码、问答、STEM 四类内部评测里 BPB(每字节比特数,越低越好)是五个参评模型中最低,比 Qwen3.8-Max-Base 各领域低约 5–13%,而每 token 激活参数少了约 25%。这些是基座模型的预训练口径,不是聊天模型的答题分。
对照着看,这代结构和我们最近记录过的两条稀疏路线思路相通:混合「线性压缩历史 + 少量全局注意力」的层配比,与用额外参数表换容量,都在为「更大的总参数、更少的每步计算」服务。区别在于 Qwen4-Max 是 closed-weights 的托管服务——结构细节只能从说明和图里读,权重拿不到,第三方无法按结构复算;官方同时承诺系列小尺寸模型将陆续开源,届时结构声明才有被独立复核的可能。
来源与延伸阅读
- Qwen 官方博客:Qwen4-Max: Your New Teammate Has Arrived官方发布说明 · 本站 11-16 仅直读标题与发布事实,11-17 晨浏览器渲染读全正文全文读取。核对关键声明:2.4T 主干参数、每 token 激活 71B、另有 328B N-gram Embedding 参数;原生视觉;1M 上下文。架构三项:GDN+QSA(每四层三层 Gated DeltaNet 压缩历史为固定状态、一层 QSA 经轻量 Indexer 按块选上下文)、Gated Residual(残差流扩为四条并行分支加动态读写门控)、N-gram Embedding(第二层按局部上下文查表)。预训练称无 loss spike;Qwen4-Max-Base 在知识/代码/问答/STEM 四类内部评测 BPB 为五参评模型最低,较 Qwen3.8-Max-Base 各领域降约 5–13%、每 token 激活参数少约 25%。Work360 52.69 对 Qwen3.8-Max 47.74(26 个一级/182 个二级/721 个三级领域分类);token 消耗 Work360 Xhigh/High 降约 24%/35%、Terminal-Bench 4.0 降约 48%/49%;API 全面降价、缓存命中价大幅下调;Work360 单任务平均费用 26.58→11.16 元、降 58%。Live Delivery 持续交付并开源 Qwen-Live-Delivery-Plugin;云资源调度三例(标注调用费用 −10.42%、GPU 空闲容量时长 +4.62%、CPU 重调度求解提速 14.61 倍)。案例:三丰智能/统联精密加工编程约 475→24 分钟(约 −95%)、198 份底稿 IPO 尽调出 86 页报告、危重症病历 1,433 张影像、48 小时冷却液分子闭环(270 万候选、4 轮迭代)、NLRP3 分子优化(454 次工具调用、RBFE 约 3.6 倍)。安全:Last Secure Code Bench 函数级功能与安全双通过 22.0%→31.8%、三粒度同安全 8%→14.7%;CBRN 内部评测称无过度拒答、未发现显著能力抬升。评测说明注明 JobBench 为自家更新数据集,APEX-Agents 引 Mercor、AA-Briefcase/AutomationBench-AA 引 Artificial Analysis、CodeArena/AgentArena 引 Arena、HLAB-Vals 引 Vals Index、Agents' Last Exam 引原榜。入口:千问 AI 平台(Token Plan 或 API)、千问办公、Qoder CN、千问 App、Qwen Studio。系列小尺寸模型称将陆续开源。文末 BibTeX 标注 2026 年 11 月。
成本账:token 更省、缓存更便宜,单任务 26.58→11.16 元
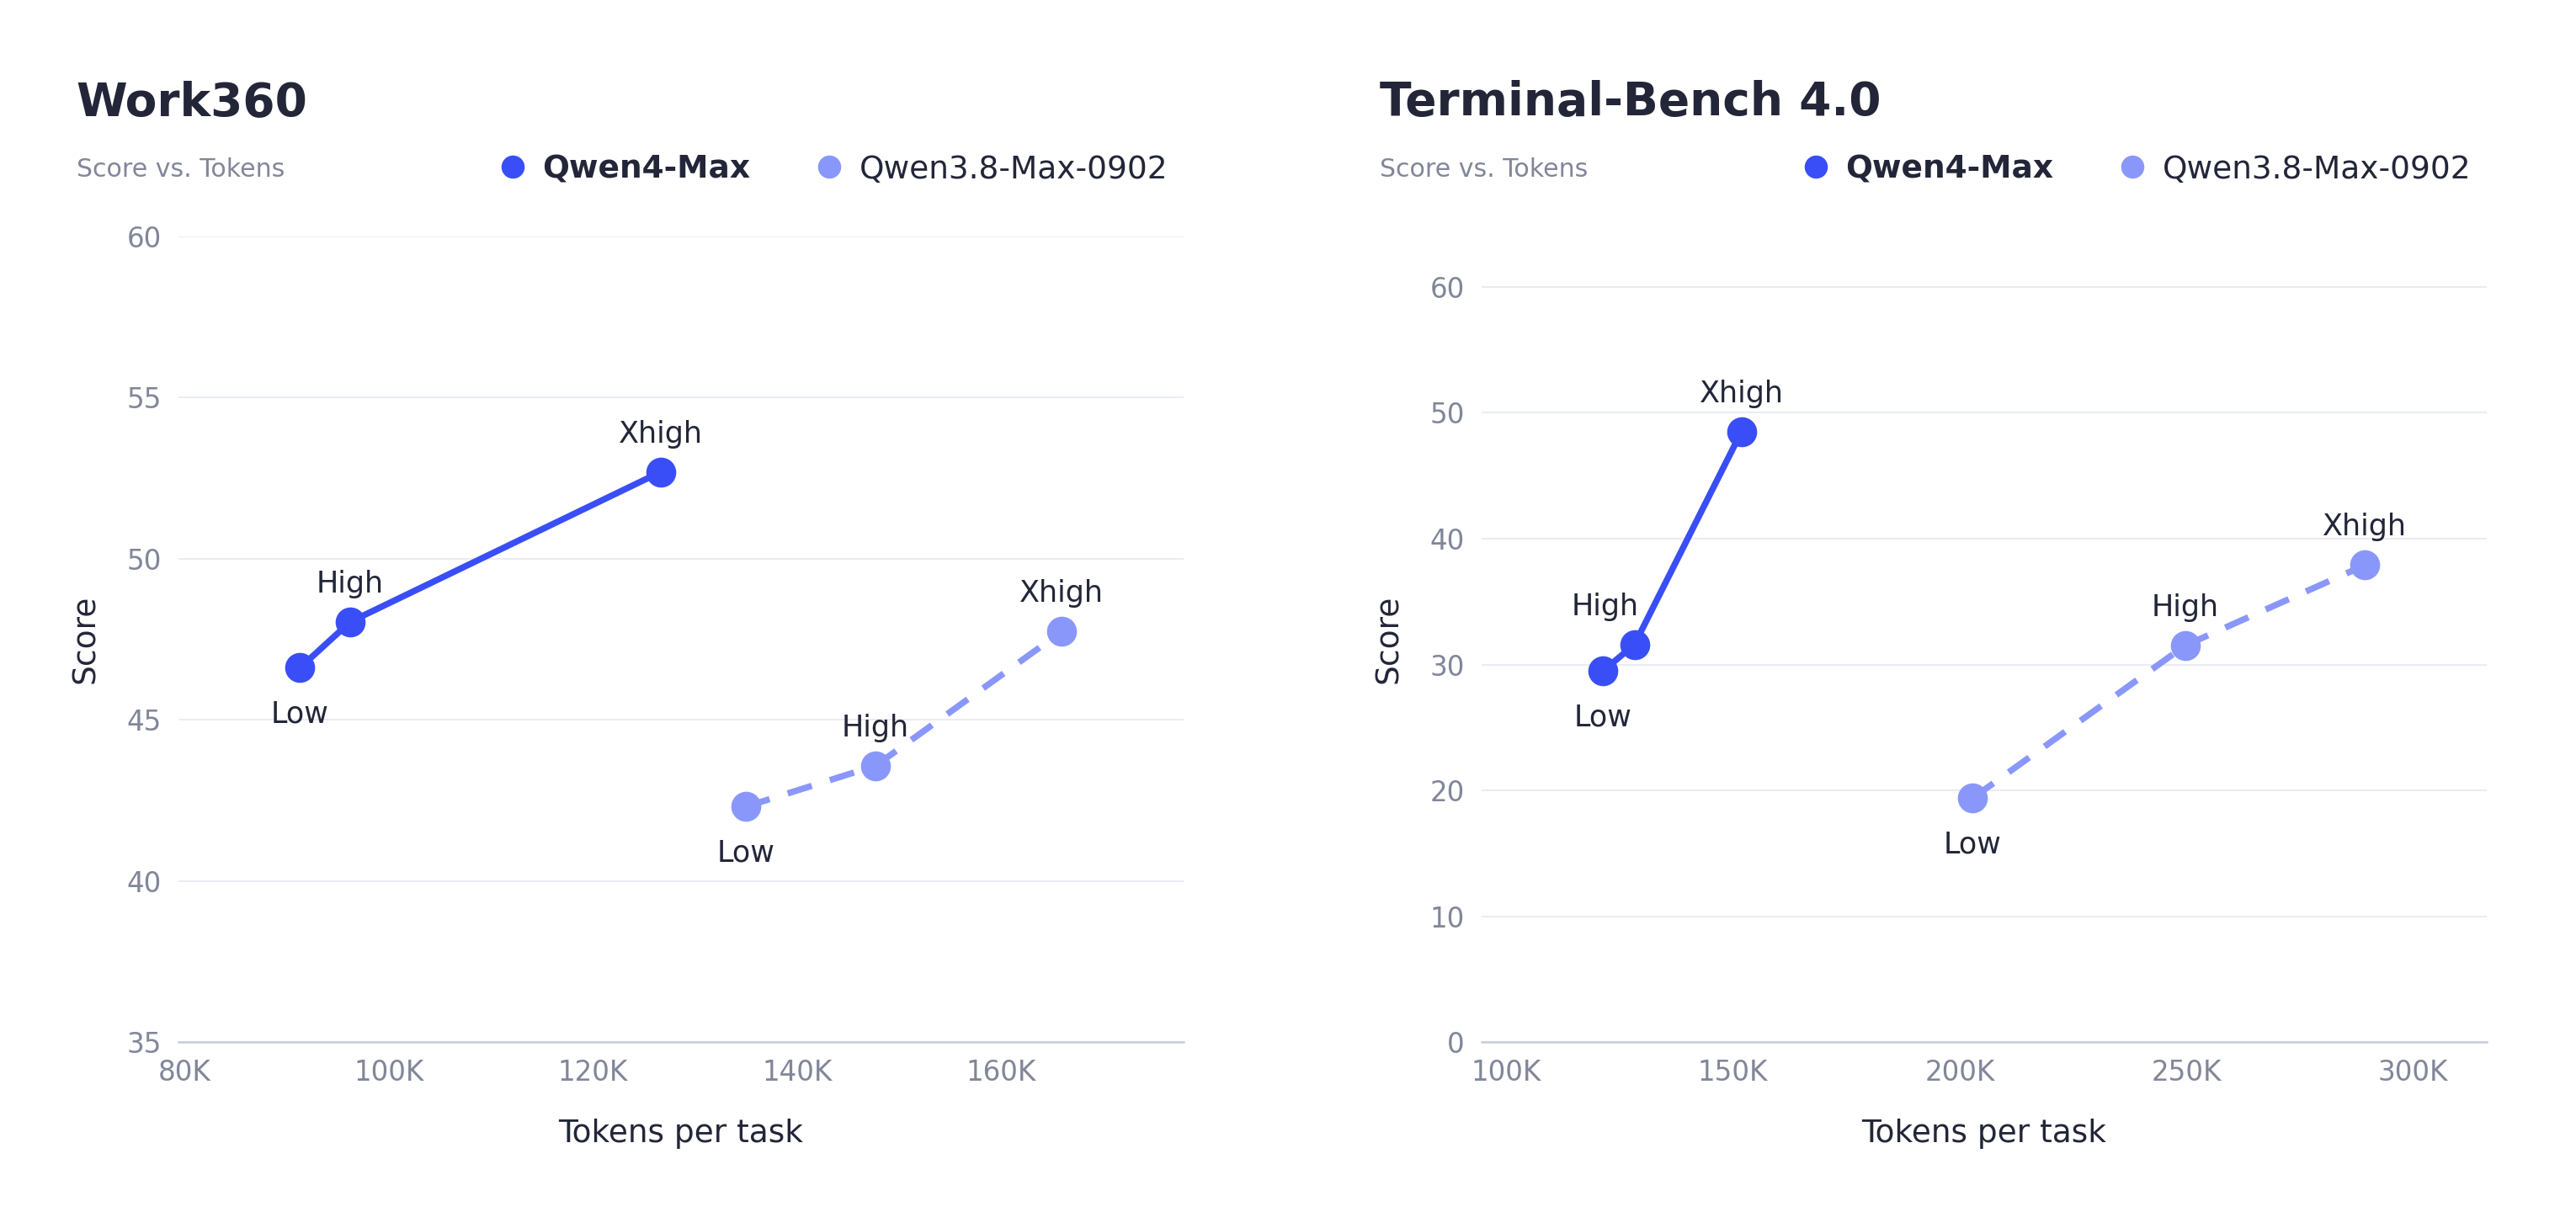
官方说明里最能落地的一段是费用。能力口径先立住:Work360(官方自建的行业场景基准,分类体系覆盖 26 个一级、182 个二级、721 个三级领域)上 Qwen4-Max 得 52.69,前代 Qwen3.8-Max 为 47.74。在此之上是效率:达到更强性能的同时,Work360 上 Xhigh 和 High 两档推理强度的 token 消耗分别减少约 24% 和 35%;Terminal-Bench 4.0 上分别减少约 48% 和 49%。官方效率图把这件事画得很直白——两个基准里,新模型的「分数-token」曲线整体落在前代左上方。
然后是价格:相比 Qwen3.8-Max,API 定价全面下调,其中缓存命中价格降幅最大——对高频重复上下文的智能体负载,缓存价常常比单价更影响账单。合起来的官方账目是:Work360 评测中单个任务的平均费用从 26.58 元降到 11.16 元,降低 58%。这就是 58% 与「超 60%」的分歧点:官方数字单任务费用与 token 双双下降,但 58% 是「同榜同任务的实际账单口径」,任何按档位或按 token 单独外推都可能得出别的数——引用时以官方这条为准,本站不替任何一方圆数。
还有一组容易被略过的自证数字:官方称 Qwen4-Max 在阿里云真实业务里给自己调度资源——数据标注的多模型调用调度费用较参考基线平均降 10.42%,GPU 在线分配的整机空闲容量时长提升 4.62%,CPU 离线重调度达到最优目标的求解速度提升超 14.61 倍。模型优化自身赖以运行的系统,这个闭环方向值得记下;同样是厂商自报,无独立核对。
来源与延伸阅读
- Qwen 官方博客:Qwen4-Max: Your New Teammate Has Arrived官方发布说明 · 本站 11-16 仅直读标题与发布事实,11-17 晨浏览器渲染读全正文全文读取。核对关键声明:2.4T 主干参数、每 token 激活 71B、另有 328B N-gram Embedding 参数;原生视觉;1M 上下文。架构三项:GDN+QSA(每四层三层 Gated DeltaNet 压缩历史为固定状态、一层 QSA 经轻量 Indexer 按块选上下文)、Gated Residual(残差流扩为四条并行分支加动态读写门控)、N-gram Embedding(第二层按局部上下文查表)。预训练称无 loss spike;Qwen4-Max-Base 在知识/代码/问答/STEM 四类内部评测 BPB 为五参评模型最低,较 Qwen3.8-Max-Base 各领域降约 5–13%、每 token 激活参数少约 25%。Work360 52.69 对 Qwen3.8-Max 47.74(26 个一级/182 个二级/721 个三级领域分类);token 消耗 Work360 Xhigh/High 降约 24%/35%、Terminal-Bench 4.0 降约 48%/49%;API 全面降价、缓存命中价大幅下调;Work360 单任务平均费用 26.58→11.16 元、降 58%。Live Delivery 持续交付并开源 Qwen-Live-Delivery-Plugin;云资源调度三例(标注调用费用 −10.42%、GPU 空闲容量时长 +4.62%、CPU 重调度求解提速 14.61 倍)。案例:三丰智能/统联精密加工编程约 475→24 分钟(约 −95%)、198 份底稿 IPO 尽调出 86 页报告、危重症病历 1,433 张影像、48 小时冷却液分子闭环(270 万候选、4 轮迭代)、NLRP3 分子优化(454 次工具调用、RBFE 约 3.6 倍)。安全:Last Secure Code Bench 函数级功能与安全双通过 22.0%→31.8%、三粒度同安全 8%→14.7%;CBRN 内部评测称无过度拒答、未发现显著能力抬升。评测说明注明 JobBench 为自家更新数据集,APEX-Agents 引 Mercor、AA-Briefcase/AutomationBench-AA 引 Artificial Analysis、CodeArena/AgentArena 引 Arena、HLAB-Vals 引 Vals Index、Agents' Last Exam 引原榜。入口:千问 AI 平台(Token Plan 或 API)、千问办公、Qoder CN、千问 App、Qwen Studio。系列小尺寸模型称将陆续开源。文末 BibTeX 标注 2026 年 11 月。
- IT之家转述:Qwen4-Max 正式上线转述稿 · 本站 11-16 全文读取 · 标题口径为「任务成本降低超 60%」发布当天本站仅能读到官方博客页标题,目录与榜单按此转述口径先行记录(Work360 52.69/47.74、token 降幅、开源承诺)。11-17 官方全文读全后核对:Work360 与 token 数字与官方一致;「任务成本降低超 60%」与官方的 58%(26.58→11.16 元)不一致,流通的英文聚合标题更写作 62%。本站以官方口径 58% 为准,转述差异照录。
官方 16 面板图:对前代全胜,对 Opus 5.5 只赢四块
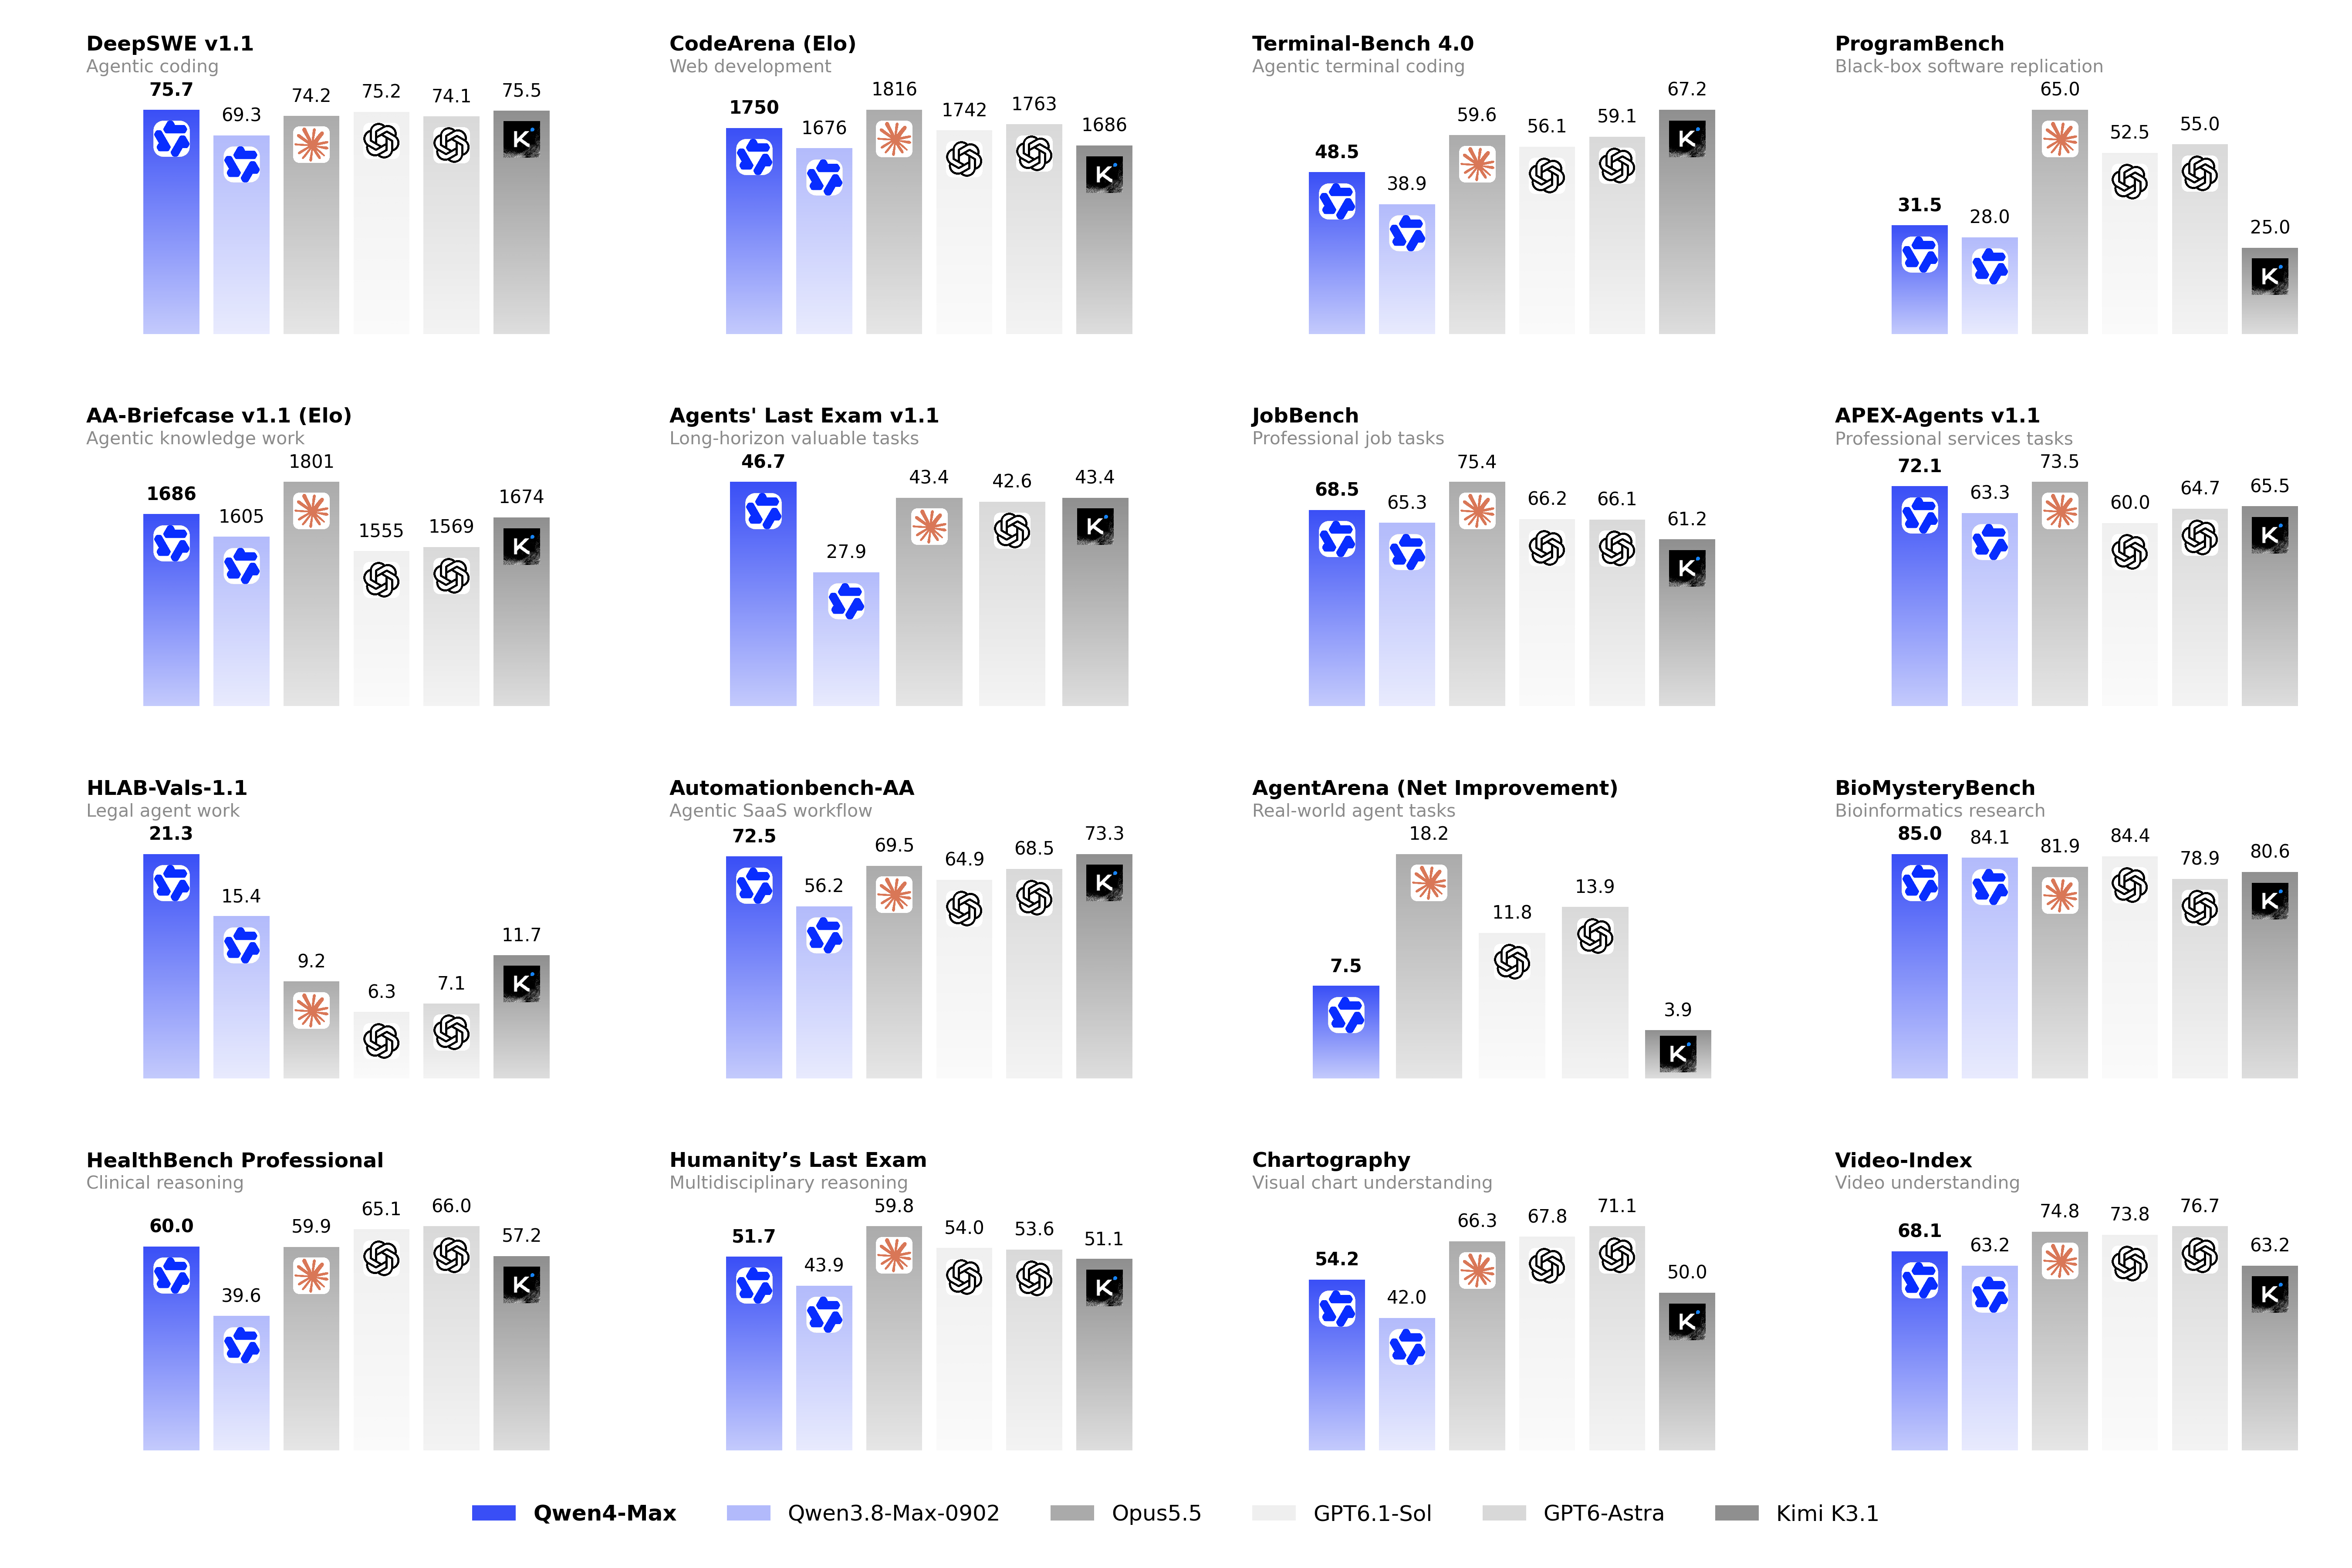
官方 16 面板对比图把 Qwen4-Max 与前代 Qwen3.8-Max-0902、Claude Opus 5.5(星形标志列)、GPT-6.1-Sol、GPT-6-Astra 和 Kimi K3.1 并排放在编程、办公与长程任务上。逐块读数:对前代,十六块面板全部更高——从 DeepSWE 75.7 对 69.3,到 HealthBench Professional 60.0 对 39.6,代际提升在厂商自己的图里没有例外。对其他家的模型则完全是另一幅图:Qwen4-Max 只在四块面板居首——DeepSWE 75.7、Agents' Last Exam 46.7、HLAB-Vals 21.3、BioMysteryBench 85.0;其余十二块里都有更高的对照,多数是 Claude Opus 5.5(CodeArena 1816 对 1750、AA-Briefcase 1801 对 1686、JobBench 75.4 对 68.5、APEX-Agents 73.5 对 72.1、Humanity's Last Exam 59.8 对 51.7、AgentArena 18.2 对 7.5),编程终端面板则是 Kimi K3.1 的 67.2 对 48.5。
这是一张把「代际进步」和「与前沿的差距」同时画出来的厂商图:新同事对自家的上一个模型全面领先,同时对 Opus 5.5 在十二块面板上仍然落后。两件事都值得原样转达——只引前半句会夸大发布,只引后半句会淹没代际提升。需要注意图例与说明未标注各面板的对比配置(各模型用哪个推理档位),这也是官方图与独立榜的常见差别。
引用这张图还必须同时引用它的脚注。官方「评测说明」写明:JobBench 分数基于自家更新的数据集与评测代码;APEX-Agents v1.1 引自 Mercor 排行榜;AA-Briefcase v1.1 与 AutomationBench-AA 引自 Artificial Analysis;CodeArena 与 AgentArena 引自 Arena;HLAB-Vals-1.1 引自 Vals Index;Agents' Last Exam v1.1 引自原榜。也就是说,图里既有厂商自跑,也有转引第三方——两类数字的可复核性不同,混读会把「官方整理」误读成「官方实测」。
接回独立榜:AA v5.0.1 综合指数给 Qwen4 Max 的行是 43(本站 11-16 晚入列,11-17 晨复读未变;源表未单列推理档位),位置在 Muse Wonder(44)之下、Claude Haiku 5.5 与 Muse Ember(均 36)之上,距榜首 Claude Fable 5.2 的 65 还有一段。独立综合榜与官方 16 面板回答的不是同一个问题——前者是跨榜合成的整数位展示,后者是任务级并排——两个口径互不替代,也互相约束:43 分说明「各项都强」还没发生,16 面板说明「哪里强、哪里不强」有明细。
来源与延伸阅读
- Qwen 官方博客:Qwen4-Max: Your New Teammate Has Arrived官方发布说明 · 本站 11-16 仅直读标题与发布事实,11-17 晨浏览器渲染读全正文全文读取。核对关键声明:2.4T 主干参数、每 token 激活 71B、另有 328B N-gram Embedding 参数;原生视觉;1M 上下文。架构三项:GDN+QSA(每四层三层 Gated DeltaNet 压缩历史为固定状态、一层 QSA 经轻量 Indexer 按块选上下文)、Gated Residual(残差流扩为四条并行分支加动态读写门控)、N-gram Embedding(第二层按局部上下文查表)。预训练称无 loss spike;Qwen4-Max-Base 在知识/代码/问答/STEM 四类内部评测 BPB 为五参评模型最低,较 Qwen3.8-Max-Base 各领域降约 5–13%、每 token 激活参数少约 25%。Work360 52.69 对 Qwen3.8-Max 47.74(26 个一级/182 个二级/721 个三级领域分类);token 消耗 Work360 Xhigh/High 降约 24%/35%、Terminal-Bench 4.0 降约 48%/49%;API 全面降价、缓存命中价大幅下调;Work360 单任务平均费用 26.58→11.16 元、降 58%。Live Delivery 持续交付并开源 Qwen-Live-Delivery-Plugin;云资源调度三例(标注调用费用 −10.42%、GPU 空闲容量时长 +4.62%、CPU 重调度求解提速 14.61 倍)。案例:三丰智能/统联精密加工编程约 475→24 分钟(约 −95%)、198 份底稿 IPO 尽调出 86 页报告、危重症病历 1,433 张影像、48 小时冷却液分子闭环(270 万候选、4 轮迭代)、NLRP3 分子优化(454 次工具调用、RBFE 约 3.6 倍)。安全:Last Secure Code Bench 函数级功能与安全双通过 22.0%→31.8%、三粒度同安全 8%→14.7%;CBRN 内部评测称无过度拒答、未发现显著能力抬升。评测说明注明 JobBench 为自家更新数据集,APEX-Agents 引 Mercor、AA-Briefcase/AutomationBench-AA 引 Artificial Analysis、CodeArena/AgentArena 引 Arena、HLAB-Vals 引 Vals Index、Agents' Last Exam 引原榜。入口:千问 AI 平台(Token Plan 或 API)、千问办公、Qoder CN、千问 App、Qwen Studio。系列小尺寸模型称将陆续开源。文末 BibTeX 标注 2026 年 11 月。
- Artificial Analysis 综合能力榜(v5.0.1)独立榜单 · 本站 11-16 晚直读源表见 Qwen4 Max 43 分并入列,11-17 晨复读 43 未变11-17 复读(直连 HTML):已收录 35 行最高已测档位分数与配置全部未变,Qwen4 Max 仍 43(源表未单列推理档位);同日源表撤下 Qwen3.8 Max (0902)(34)与 Gemini 3.8 Flash(high 31)两行,站内行按既有先例保留。43 为独立综合指数,与官方自报 Work360 及 16 面板图互不替代。
四个官方案例,与一条开源承诺
说明的后半段是案例集,四个方向各挑一个可核的数字:制造业——在三丰智能装备与统联精密的实际生产场景,加工编程的单工件人工投入从约 475 分钟降到 24 分钟(约 −95%),模型做的是图纸理解、参数化建模、刀路生成与仿真核验,上机前发现过切少切;法律——198 份格式混乱的 IPO 底稿重命名归类为 14 个目录,交叉核验后交付 86 页、6 万余字的尽调报告,结论附底稿引用;医疗——危重症病历单次对话通读几十份检验单与 1,433 张原始影像,CT 读出的「双肺背侧实变」与主管医生诊断一致,四条处置建议与当日医嘱逐条对应;科学——连续 48 小时自主运行,在 270 万候选分子空间里经 4 轮「设计-合成-测试」闭环拿到经实验验证的新型冷却液分子,另一例 NLRP3 靶点分子优化调用 454 次工具、完成 3,239 项计算评估,RBFE 估计结合亲和力约为专利起点的 3.6 倍。
这些案例的边界要说清楚:全部是厂商在合作方场景里演示的成果,本站未运行模型、未复现任何一项任务;「诊断一致」「与医嘱对应」是说明文字的口径,不是独立医疗评审。真正进入工作流的证据要等使用方自己的记录。与案例配套的机制倒是可以立刻核实的:Live Delivery(先交可用首版、逐版持续交付,用户可随时校准方向)配有已开源的 Qwen-Live-Delivery-Plugin,插件代码就在那里,这是本篇里少数可以直接下载验证的交付物。安全数字同样照录:Last Secure Code Bench 函数级「功能与安全双通过」从前代 22.0% 提到 31.8%,函数/文件/仓库三粒度同安全从 8% 到 14.7%;CBRN 内部评测称无过度拒答、未发现显著能力抬升。
对本站读者,真正值得立为跟踪项的是那句话:「Max 只是 Qwen4 的第一款模型,系列中的小尺寸模型也将陆续开源」。Qwen4-Max 本体权重未开放——所有能力体验都走千问平台、Token Plan/API 或千问办公、Qoder CN 等入口;而小尺寸开源一旦兑现,本篇的结构声明(GDN+QSA 的层配比、N-gram 词表的真实开销)就第一次可以被第三方按权重复核,成本账也才有社区参照。本站目录已把 Qwen4 Max 收入模型页并接好 AA 榜行;开源兑现时,这里的结构描述应当按权重重新过一遍。
- 读 Qwen4-Max 官方发布说明全文本文架构、成本、案例与安全数字的出处;文末附评测说明(哪些分数引自第三方)与 BibTeX。
- 看本站模型页与榜单位置目录条目、AA 43 分行的配置注记与后续独立评测入口。
- 对照本站 AA 榜整体格局35 个收录型号与各榜口径;Qwen4 Max(43)在 Muse Wonder(44)与 Haiku 5.5/Muse Ember(36)之间。
来源与延伸阅读
- Qwen 官方博客:Qwen4-Max: Your New Teammate Has Arrived官方发布说明 · 本站 11-16 仅直读标题与发布事实,11-17 晨浏览器渲染读全正文全文读取。核对关键声明:2.4T 主干参数、每 token 激活 71B、另有 328B N-gram Embedding 参数;原生视觉;1M 上下文。架构三项:GDN+QSA(每四层三层 Gated DeltaNet 压缩历史为固定状态、一层 QSA 经轻量 Indexer 按块选上下文)、Gated Residual(残差流扩为四条并行分支加动态读写门控)、N-gram Embedding(第二层按局部上下文查表)。预训练称无 loss spike;Qwen4-Max-Base 在知识/代码/问答/STEM 四类内部评测 BPB 为五参评模型最低,较 Qwen3.8-Max-Base 各领域降约 5–13%、每 token 激活参数少约 25%。Work360 52.69 对 Qwen3.8-Max 47.74(26 个一级/182 个二级/721 个三级领域分类);token 消耗 Work360 Xhigh/High 降约 24%/35%、Terminal-Bench 4.0 降约 48%/49%;API 全面降价、缓存命中价大幅下调;Work360 单任务平均费用 26.58→11.16 元、降 58%。Live Delivery 持续交付并开源 Qwen-Live-Delivery-Plugin;云资源调度三例(标注调用费用 −10.42%、GPU 空闲容量时长 +4.62%、CPU 重调度求解提速 14.61 倍)。案例:三丰智能/统联精密加工编程约 475→24 分钟(约 −95%)、198 份底稿 IPO 尽调出 86 页报告、危重症病历 1,433 张影像、48 小时冷却液分子闭环(270 万候选、4 轮迭代)、NLRP3 分子优化(454 次工具调用、RBFE 约 3.6 倍)。安全:Last Secure Code Bench 函数级功能与安全双通过 22.0%→31.8%、三粒度同安全 8%→14.7%;CBRN 内部评测称无过度拒答、未发现显著能力抬升。评测说明注明 JobBench 为自家更新数据集,APEX-Agents 引 Mercor、AA-Briefcase/AutomationBench-AA 引 Artificial Analysis、CodeArena/AgentArena 引 Arena、HLAB-Vals 引 Vals Index、Agents' Last Exam 引原榜。入口:千问 AI 平台(Token Plan 或 API)、千问办公、Qoder CN、千问 App、Qwen Studio。系列小尺寸模型称将陆续开源。文末 BibTeX 标注 2026 年 11 月。
- Artificial Analysis 综合能力榜(v5.0.1)独立榜单 · 本站 11-16 晚直读源表见 Qwen4 Max 43 分并入列,11-17 晨复读 43 未变11-17 复读(直连 HTML):已收录 35 行最高已测档位分数与配置全部未变,Qwen4 Max 仍 43(源表未单列推理档位);同日源表撤下 Qwen3.8 Max (0902)(34)与 Gemini 3.8 Flash(high 31)两行,站内行按既有先例保留。43 为独立综合指数,与官方自报 Work360 及 16 面板图互不替代。