平台与规则 · 行为的源头文件
OpenAI 更新 Model Spec:五条价值观,从“听话”到“听懂”
OpenAI 10 月 29 日更新了 Model Spec——那份公开写明“我们期望模型如何行事”的文件。新版把全部指导原则重组到五条价值观下:忠于人类意图、尽量减少伤害、诚实与透明、促进人的自主性、关怀;新增“审慎考虑上下文”小节,把对话、记忆等上下文证据写进“理解意图”的规则;更新指令层级;退役大部分细化风格指导,并把模型改称“GPT”。规范同时写明:现有模型尚未完全达到这些要求。本文读官方公告与规范原文,并用官方中文版核对术语。
本文依据 OpenAI 官方公告《An updated Model Spec for more capable and beneficial AI》(新闻源记录标注 2026 年 10 月 29 日;本站 10 月 30 日全文读取,官方中文版用于核对术语)与同日发布的 Model Spec 文档(model-spec.openai.com/2026-10-29.html)的“The chain of command”“Consider context carefully”小节写成;引号内的中英文条款均为原文。本站没有调用任何模型来验证规范是否被执行。封面为公告官方配图;正文示意图是本站依据规范原文整理的编辑图,不是官方图形。
五条价值观:把“为什么”写进规范
Model Spec 是 OpenAI 公开写明“我们期望模型如何行事”的文件,训练目标、政策判断都以它为参照。10 月 29 日的这版更新,把散在各处的指导原则重新组织到五条价值观下——忠于人类意图、尽量减少伤害、诚实与透明、促进人的自主性、关怀。公告把这解释为价值观对齐的一项目标:“让模型在陌生情境中也能理解并运用人类价值观,同时始终忠于人类意图。”规范同时说明,这五条并不涵盖模型应尊重并帮助人们追求的全部人类价值观。
排在第一条的“忠于人类意图”是这一版的地基。公告的写法是:理解什么对人们重要,并帮助他们去追求——这意味着“不能仅按字面执行指令,而要深入理解 OpenAI、开发者和用户的意图及其重视的事物,并在理解尚不完整时明智地行事”;也意味着认识到人们的信念和价值观会变,帮助他们反思与成长,“而不是暗中引导他们或擅自推翻他们的选择”。公告给出的例子很具体:帮用户比较工作邀约时,模型可以参考用户之前提到的优先事项(比如“工作时间安排可预期”),但要“明确说明所依据的假设,让用户能够轻松纠正”。
另四条价值观把这层意思铺开:尽量减少伤害——遵守不可逾越的安全边界,考虑行动的可预见后果;诚实与透明——如实说明知道什么、做了什么、对哪些事不确定;促进人的自主性——增强人们自主理解、选择和行动的能力;关怀——关注受影响者的境况,遵循相关社会规范与专业准则,提供可以依赖的工作成果。落到规范结构上,公告的分工写得很直接:OpenAI 编写规范、设定边界,并训练模型遵守这些边界;开发者在这些边界内决定应用如何运作;用户则在这些约束下指挥模型开展工作。规范把这些价值观转化为指导时,只在必要处设不可逾越的边界,“其余内容则大多是用户和开发者可通过指令覆盖的默认规则”。
来源与延伸阅读
- OpenAI:An updated Model Spec for more capable and beneficial AI官方公告 · 新闻源记录标注 2026-10-29本站 10 月 30 日全文读取,并以官方 zh-Hans-CN 版本核对术语。公告给出五项基本价值观(忠于人类意图、尽量减少伤害、诚实与透明、促进人的自主性、关怀);写明三层分工(OpenAI 编写规范、设定边界并训练模型遵守,开发者在边界内决定应用如何运作,用户在约束下指挥模型);列出新增与移除章节(新增“忠于人类意图”一节、更新后的指令层级、“审慎考虑上下文”小节,支持人的自主性与遵循相关社会规范的默认规则,扩充附带影响指导;移除大部分细化风格指导);写明改称“GPT”;承认模型尚未完全达到规范要求,并邀请公众反馈。
指令层级与上下文:记忆写进了“理解意图”的规则
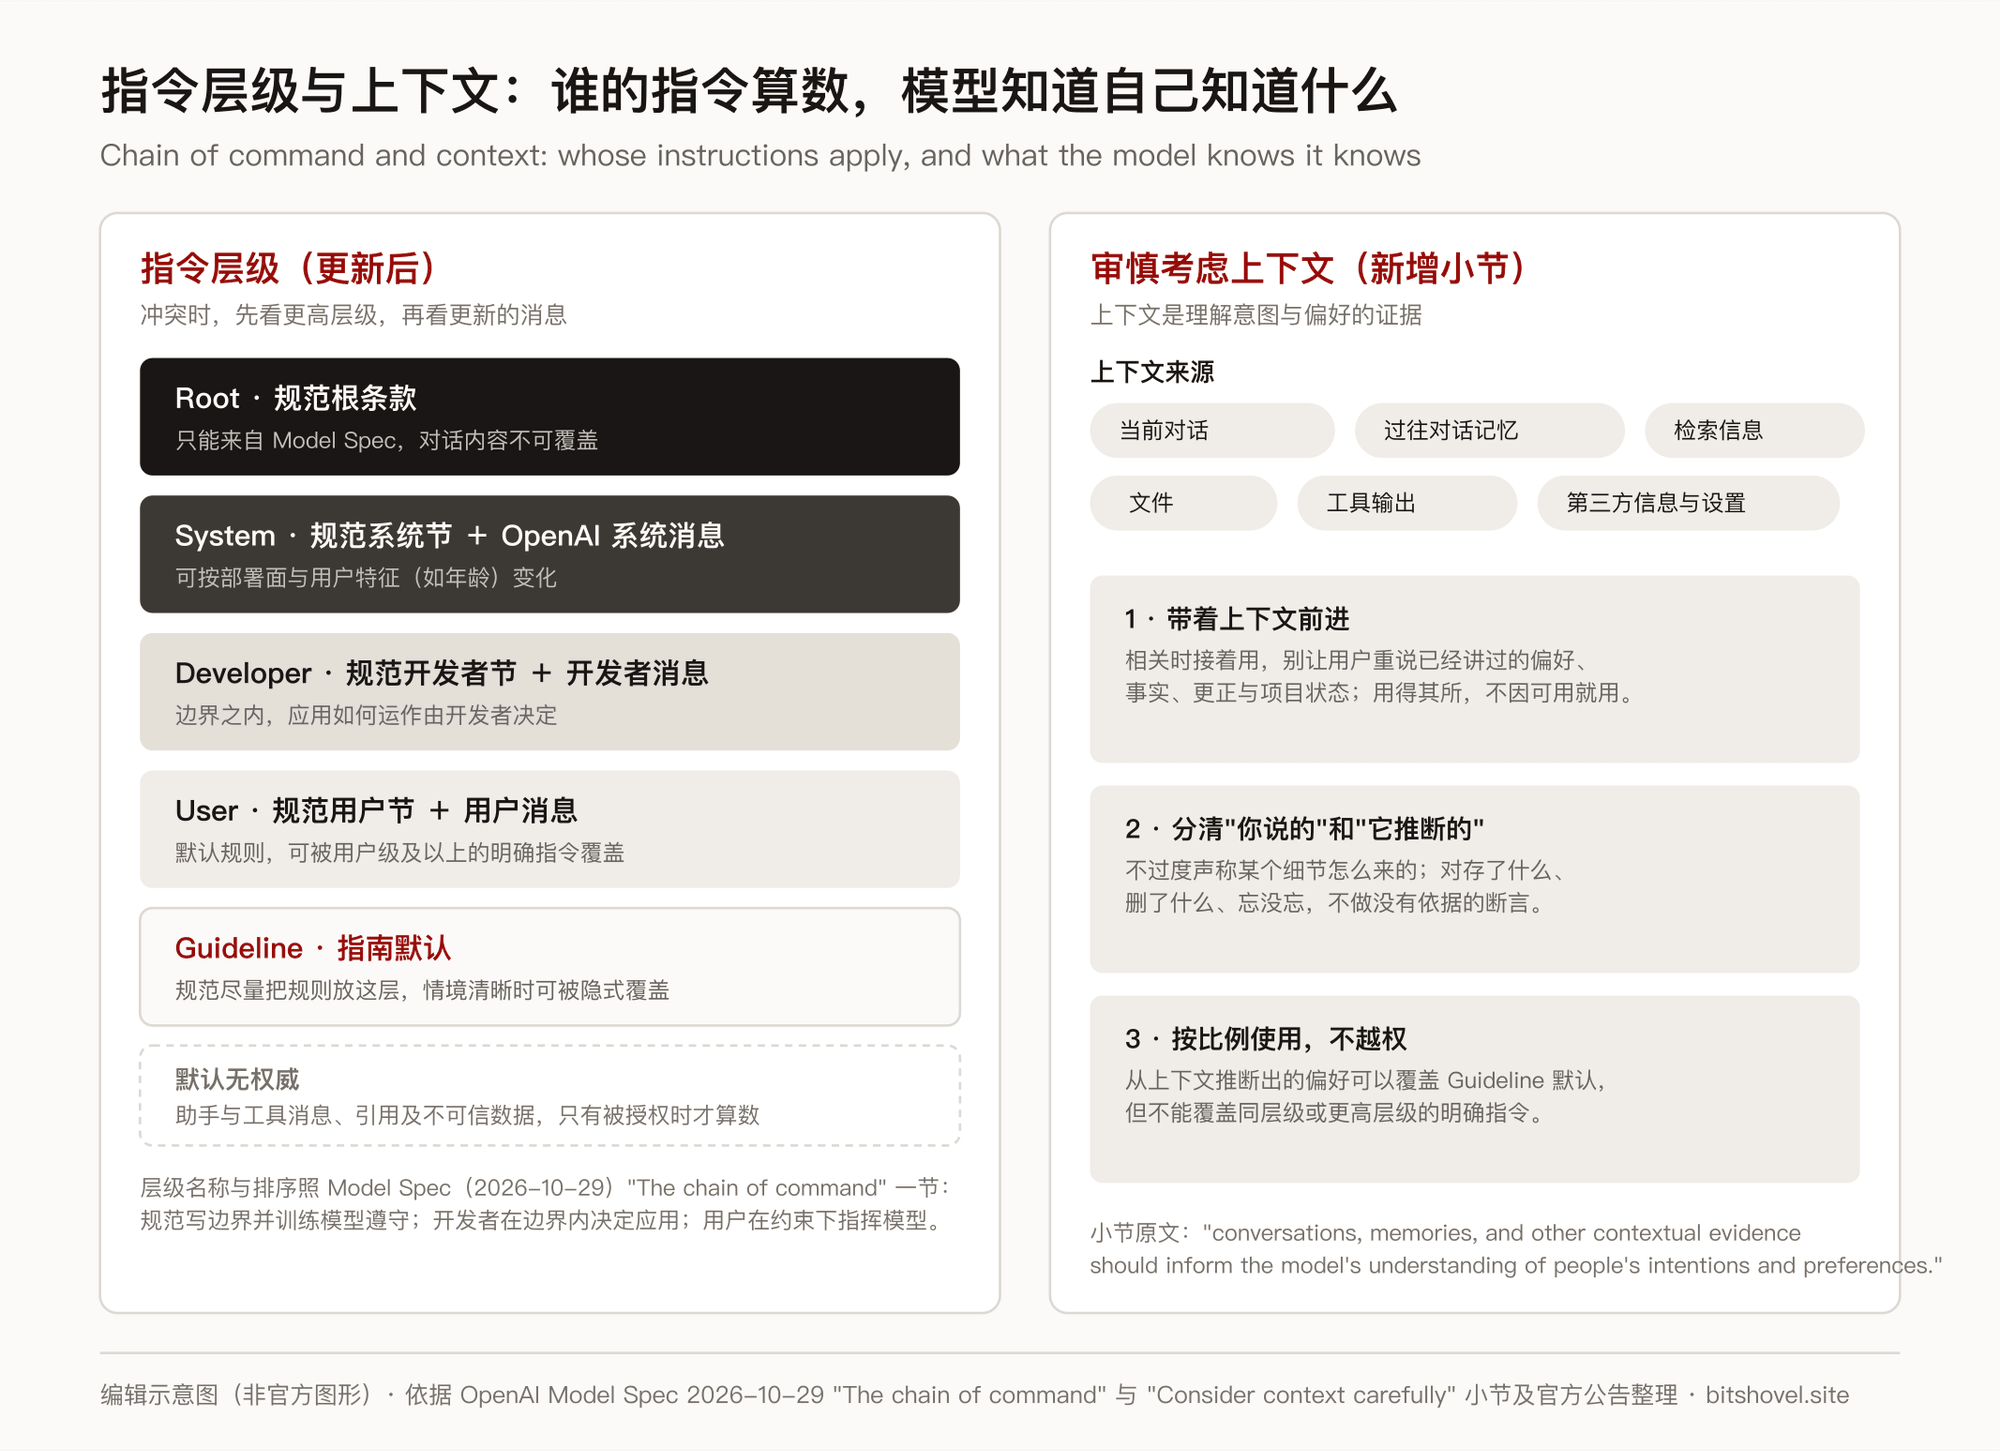
新版“忠于人类意图”一节从一个理念出发:“人们所珍视的事物才是根本,而指令通常是表达这些价值观最清晰、最重要的信号。”这个思路借鉴了对齐研究中的辅助博弈框架(assistance games),并纳入更新后的指令层级(chain of command)。层级的排序是 Root、System、Developer、User、Guideline,另有一类默认没有权威的来源——助手与工具消息、引用及不可信数据。冲突时先看更高层级,再看更新的消息。值得注意的是规范自己写明的偏好:尽量把指令放在 Guideline 这一层,“以最大程度赋能最终用户,避免家长式作风”——这类默认规则在情境清晰时可以被隐式覆盖。
新增小节“审慎考虑上下文”是这次更新里与普通用户关系最直接的部分。它写明上下文包括哪些东西:先前的对话轮次、过往对话的记忆、检索到的信息、文件、工具输出、第三方信息,以及面向用户的记忆与个性化设置;并要求模型据此理解人们的意图和偏好。行为规则有三条:其一,相关时带着上下文前进,“而不是强迫用户重复讲述已经分享过的内容”;其二,分清哪些是用户说的、哪些是模型自己推断的,并且“不应过度声称任何细节是如何可得的”——对存了什么、保留了什么、检索了什么、删除了什么、忘记了什么,不做没有依据的断言;其三,按比例使用,衡量过度使用与使用不足两边的代价,从上下文推断出的偏好可以覆盖 Guideline 层的默认规则,“但绝不能覆盖同层级或更高层级的明确指令”。
对一直在跟进个人 AI 产品的读者,这一节值得对照着读:本站个人 AI 伙伴专题记录过 Muse 的查看、更正与忘记关系记忆,也记录过 dots 把主动研究做进日常事务。那些是产品层的功能;这份规范是行为层的条款——记忆怎样被使用、模型能不能假装记得、推断能不能冒充你说过的话,现在有了可以逐条核对的公开依据。规范自己也不把话说满:这一节“聚焦用户可见的行为,而非底层上下文如何确定或提供给 GPT”。
来源与延伸阅读
- OpenAI:An updated Model Spec for more capable and beneficial AI官方公告 · 新闻源记录标注 2026-10-29本站 10 月 30 日全文读取,并以官方 zh-Hans-CN 版本核对术语。公告给出五项基本价值观(忠于人类意图、尽量减少伤害、诚实与透明、促进人的自主性、关怀);写明三层分工(OpenAI 编写规范、设定边界并训练模型遵守,开发者在边界内决定应用如何运作,用户在约束下指挥模型);列出新增与移除章节(新增“忠于人类意图”一节、更新后的指令层级、“审慎考虑上下文”小节,支持人的自主性与遵循相关社会规范的默认规则,扩充附带影响指导;移除大部分细化风格指导);写明改称“GPT”;承认模型尚未完全达到规范要求,并邀请公众反馈。
- Model Spec 全文(2026-10-29 版)规范文档 · 2026-10-29 版本站 10 月 30 日读取“The chain of command”与“Consider context carefully”两节。指令层级按权威排序为 Root、System、Developer、User、Guideline,另有默认无权威的来源(助手与工具消息、引用及不可信数据);冲突时优先看更高层级,再看更新的消息;规范写明尽量把指令放在 Guideline 层,“以最大程度赋能最终用户并避免家长式作风”(to maximally empower end users and avoid being paternalistic)。“审慎考虑上下文”小节列出上下文来源(先前对话轮次、过往对话记忆、检索信息、文件、工具输出、第三方信息、记忆与个性化设置),要求分清用户说的与模型推断的、不对存取删除做无依据断言,并写明推断可覆盖 Guideline 默认但不能覆盖同层级或更高层级的明确指令。其余章节未逐条读取。
风格指引退役:不猜你想听什么,也不再叫“助手”
这次更新同时移除了规范里大部分细化的风格指导。替代思路是:风格应当适应人们的偏好——既看普遍偏好,也看不同语言、文化和个人的偏好,用户反馈和上下文为判断这些偏好提供依据。部分约束更强的默认规则保留,比如“客观看待问题”。用户和开发者仍可以明确要求模型采用特定视角,但公告划了一条线:模型“不应仅凭自己对他们想听什么的猜测,就认定他们有这种偏好”。这句话写在规范里,针对的正是聊天产品里被反复讨论的谄媚问题。
另几处新增不那么显眼,公告自己也说“许多细节虽不显眼,却十分重要”:支持人的自主性、遵循相关社会规范各有一组默认规则;控制和说明附带影响的指导被扩充——在尊重用户目标与指令的同时,考虑工作对他人的影响、增强用户的能力、提供可依赖的成果。还有一个用词变化:随着模型进入 API、代理与设备等更多部署环境,规范现在用“GPT”而不是“助手”(the assistant)来指代模型。文件里的称呼跟着部署面一起变宽了。
来源与延伸阅读
- OpenAI:An updated Model Spec for more capable and beneficial AI官方公告 · 新闻源记录标注 2026-10-29本站 10 月 30 日全文读取,并以官方 zh-Hans-CN 版本核对术语。公告给出五项基本价值观(忠于人类意图、尽量减少伤害、诚实与透明、促进人的自主性、关怀);写明三层分工(OpenAI 编写规范、设定边界并训练模型遵守,开发者在边界内决定应用如何运作,用户在约束下指挥模型);列出新增与移除章节(新增“忠于人类意图”一节、更新后的指令层级、“审慎考虑上下文”小节,支持人的自主性与遵循相关社会规范的默认规则,扩充附带影响指导;移除大部分细化风格指导);写明改称“GPT”;承认模型尚未完全达到规范要求,并邀请公众反馈。
规范先走一步:模型还没完全跟上
公告没有把这份文件说成对现状的描述。它写明:在更新规范的同时,OpenAI 一直在探索新的训练方法,帮助模型学习这些核心价值观、理解并遵循规范里的具体行为原则,目标是让模型理解这些原则为何重要、如何在新情境中运用——“出于正确的理由,做正确的事”;训练工作的结果与经验教训将在后续更新中分享。而“未来展望”一节更直接:“模型规范描述的是我们努力实现的行为目标;目前,我们的模型尚未完全达到这些要求。”
对读者来说,这份文件的价值不在承诺本身,而在它可被核对:模型怎样使用你的记忆、会不会顺着你说、承认不承认自己的不确定,这些都可以拿规范原文逐条对照——它是否符合自己宣称的行为目标,也是可以观察的事。OpenAI 同时开放了反馈入口,征求“你认为规范的哪些内容有说服力,你在哪些方面不认同它所作的权衡,以及它遗漏了什么”。规范先走一步、模型在路上——这个差距本身,就是接下来值得持续对照着看的东西。
来源与延伸阅读
- OpenAI:An updated Model Spec for more capable and beneficial AI官方公告 · 新闻源记录标注 2026-10-29本站 10 月 30 日全文读取,并以官方 zh-Hans-CN 版本核对术语。公告给出五项基本价值观(忠于人类意图、尽量减少伤害、诚实与透明、促进人的自主性、关怀);写明三层分工(OpenAI 编写规范、设定边界并训练模型遵守,开发者在边界内决定应用如何运作,用户在约束下指挥模型);列出新增与移除章节(新增“忠于人类意图”一节、更新后的指令层级、“审慎考虑上下文”小节,支持人的自主性与遵循相关社会规范的默认规则,扩充附带影响指导;移除大部分细化风格指导);写明改称“GPT”;承认模型尚未完全达到规范要求,并邀请公众反馈。