能力到创作 · 角色配音
给角色一个声音,再导演每句台词:Gemini 3.8 TTS
同一个骑士,可以换一种声音;同一段独白,可以逐句安排停顿与情绪。从官方演示看,短片配音多了哪些可控制的部分。
9 月 23 日发布,9 月 24 日整理。下文使用 Google 官方演示;本站核对了画面与播放入口,尚未自行生成配音或测量中文效果。
同一个角色,声音也能单独设计
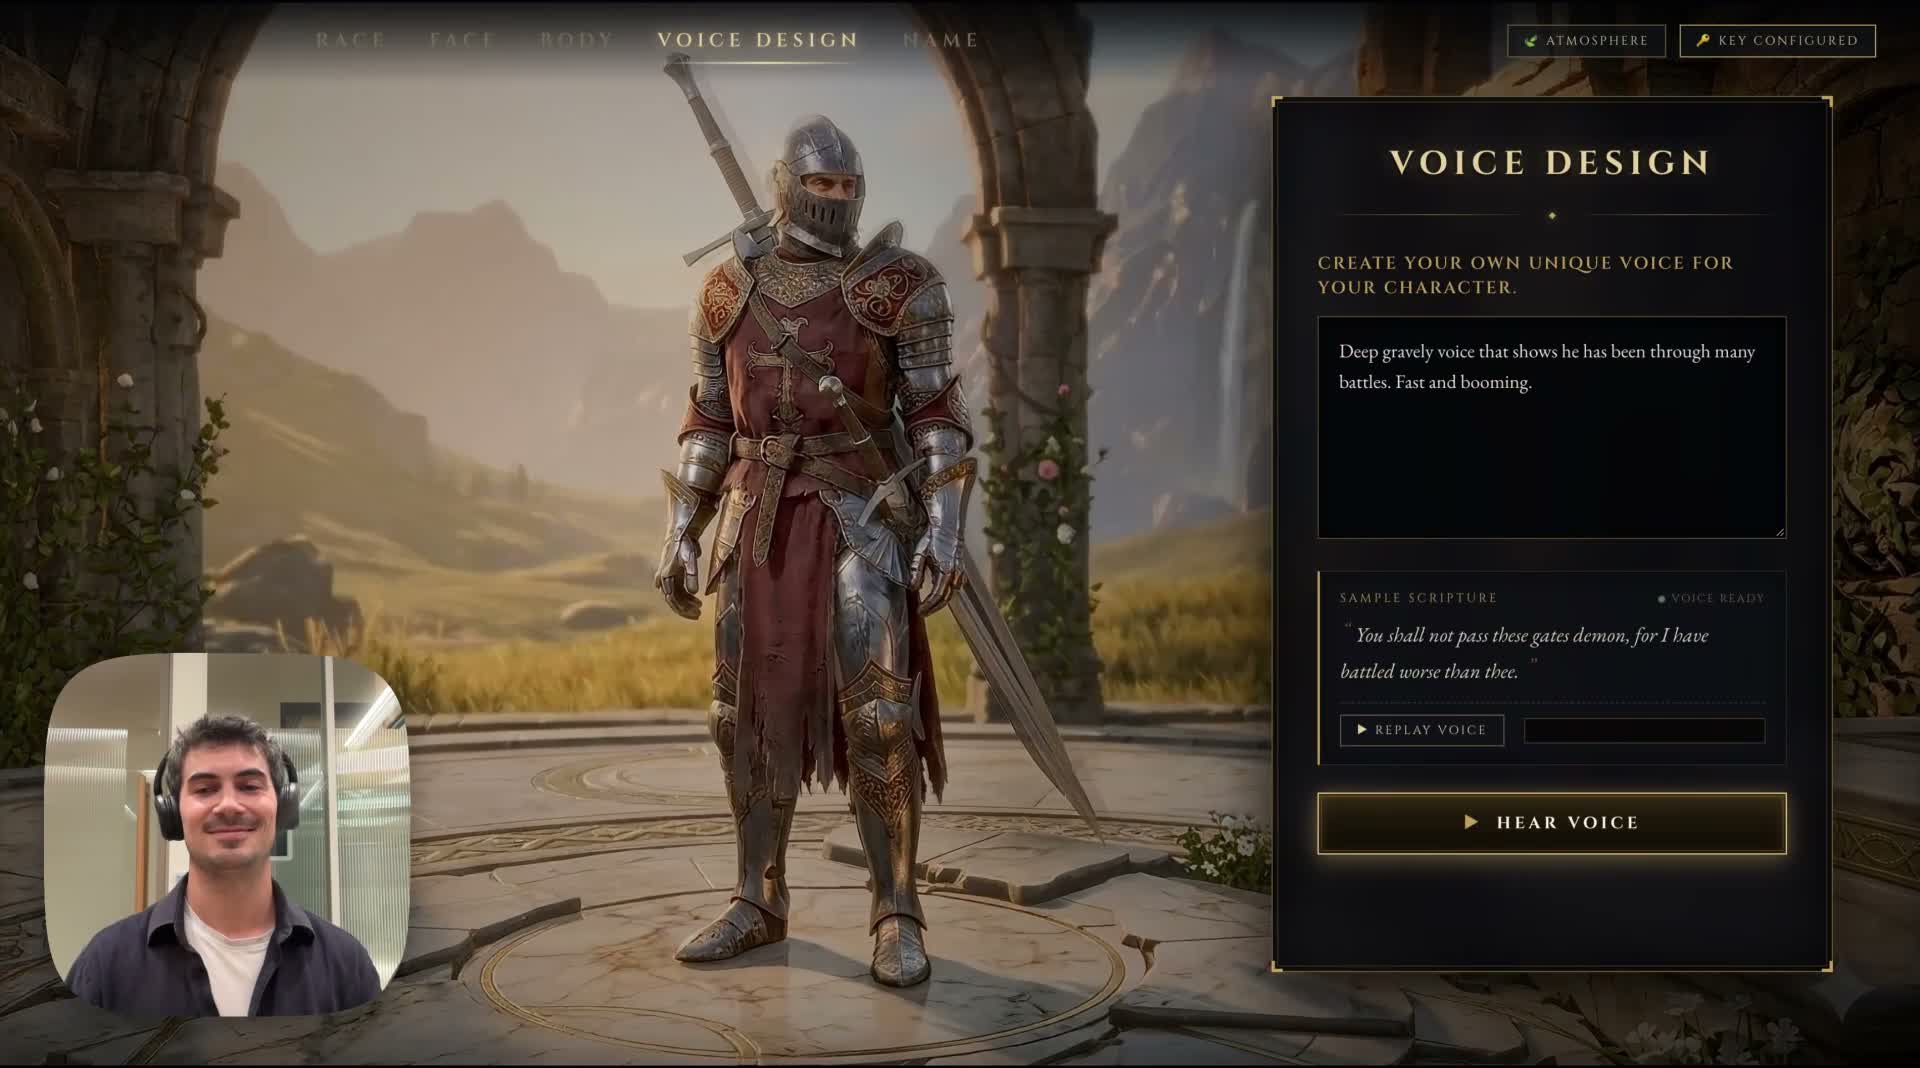
在这段游戏演示里,穿盔甲的骑士站在画面中央,右侧是声音描述和试听按钮。到第 48 秒,描述强调低沉、沙哑的战士声音;到第 73 秒,文字改成高音调、带庄重感的公主声音,骑士形象仍然保留。可以打开原视频,听这两个位置的差别。
这里值得看的是创作顺序:角色长什么样、听起来是什么样,可以分别调整。已经做出人物或动画镜头的人,可以继续研究声音如何塑造性格,而不是把选一个固定音色当作配音的全部。
- 看并听:同一个骑士,两种声音描述约 84 秒;对照第 48 秒和第 73 秒。
来源与延伸阅读
- 官方游戏角色声音演示官方示例 · 约 84 秒角色不变,改写右侧声音描述;本文使用第 48 秒原始画面。
音色确定之后,台词还需要表演
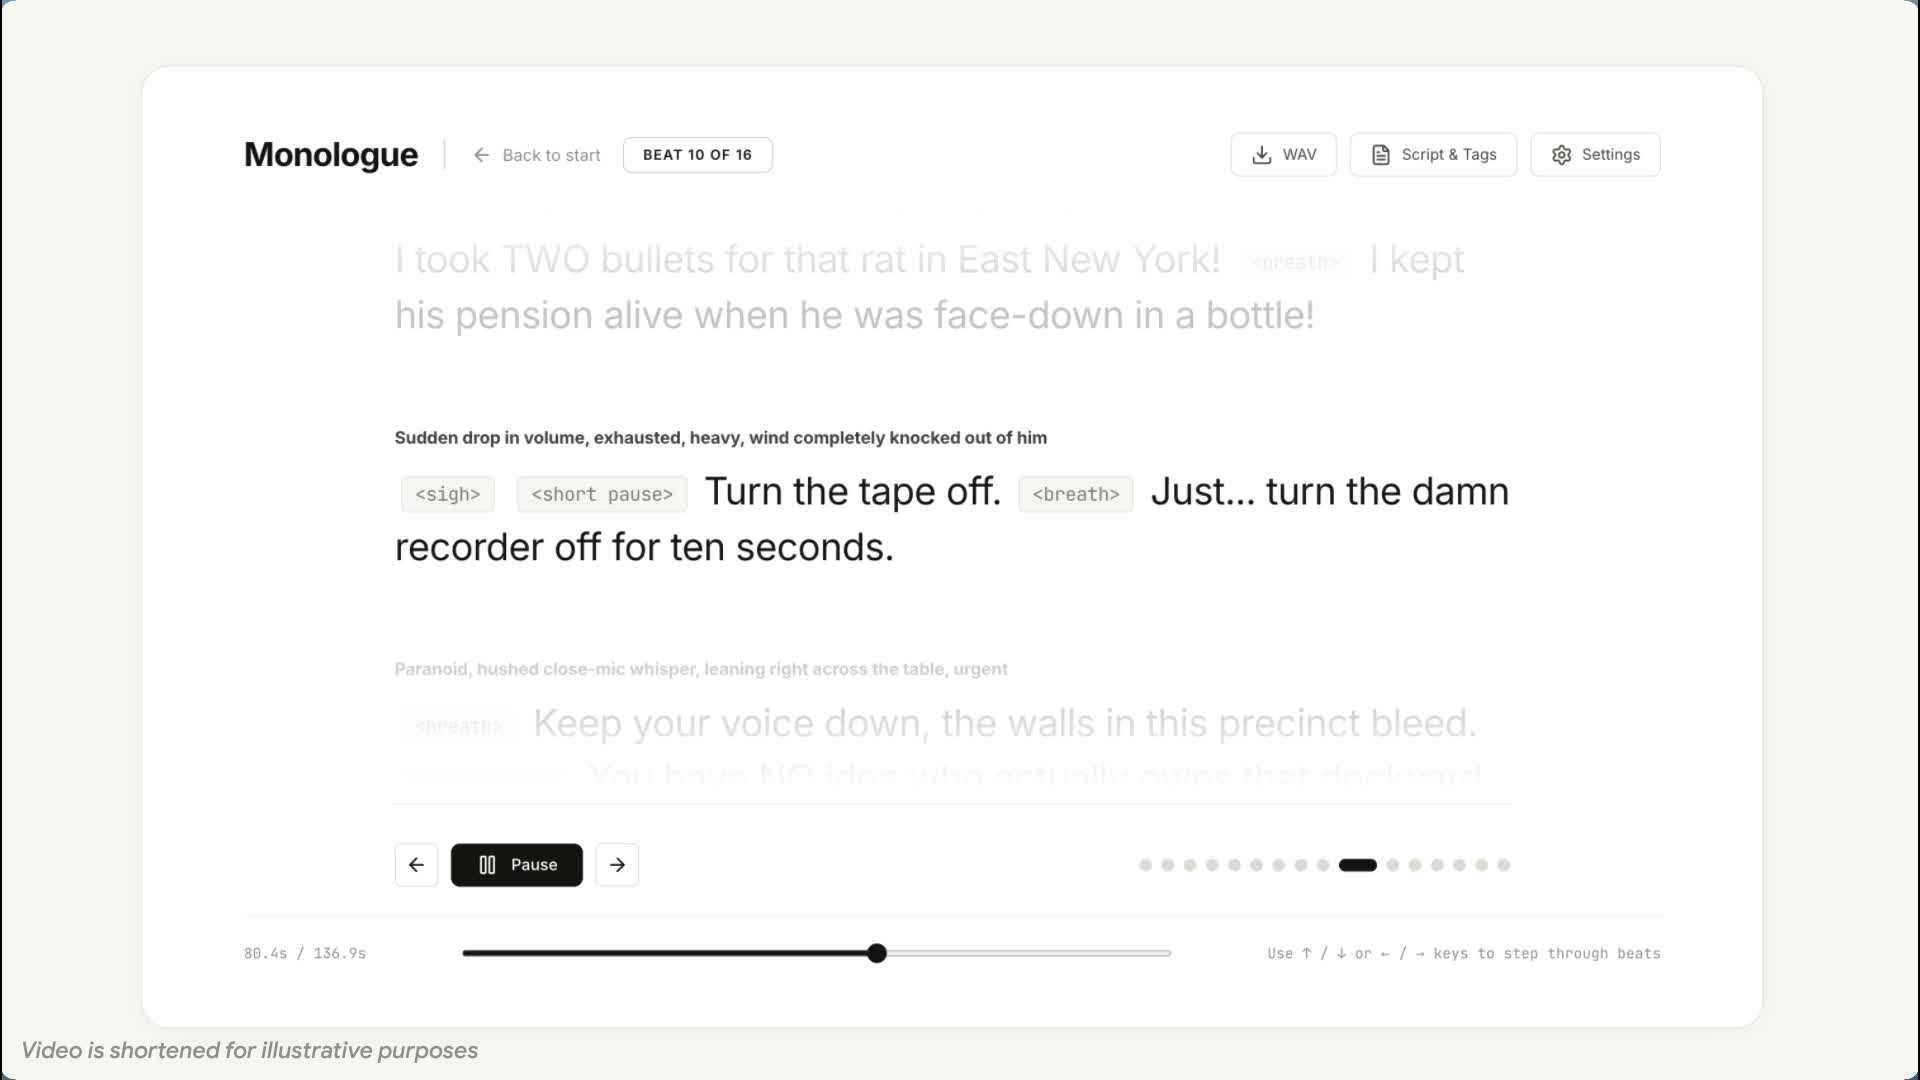
另一段官方演示把侦探独白拆成多个表演段落。画面中,台词旁有情绪和音量说明,句中插入叹气、短暂停顿和呼吸。它展示了两层控制:先确定谁在说话,再安排这一句如何说。
Google 在 9 月 23 日推出 Flash TTS 与 Flash-Lite TTS,前者着重角色声音设计,后者面向大量语音生成;两者都提供逐句表演控制。官方示例说明了操作思路,中文情绪是否自然、同一角色多次生成能否稳定,仍需实际作品和同题试听来补全。
- 看并听:台词里的表演说明约 63 秒,官方缩短版演示。
来源与延伸阅读
- Google:Gemini 3.8 TTS 发布官方发布 · 9 月 23 日核对声音设计、逐句控制与逐步开放的入口。
- 官方侦探独白演示官方示例 · 约 63 秒分段台词、表演说明与停顿标签;视频已为展示缩短。
先找到入口,再带一小段自己的故事
发布时,AI Studio 与 Gemini API 开始逐步开放两款模型;面向现成产品,Flash 对应 Gemini Notebook,Lite 对应 Google Vids。这不等于普通 Gemini 聊天窗口已经拥有演示里的全部控件,具体仍以所用产品与账号可见入口为准。
可以先拿自己写的两三句对白,保持台词和角色设定不变,只调整一次停顿或情绪,听它是否更贴近故事。回看网站的 AI 影像案例时,也可以多留意:画面之外,声音怎样让人物成立。这是可尝试的创作方向,不是这些旧案例已经采用了新模型。
- 进入 AI Studio 语音生成需要登录;实际开放情况以账号为准。
- 回到 AI 影像,看看完整作品
来源与延伸阅读
- Google:Gemini 3.8 TTS 发布官方发布 · 9 月 23 日核对声音设计、逐句控制与逐步开放的入口。
- Gemini 3.8 Audio 模型说明官方模型卡 · 9 月版区分 TTS 与实时对话模型,并核对产品接入范围。