模型到应用 · 找回已有素材
不记得文件名,也能找回一段画面:EmbeddingGemma 2
输入“海龟吃东西”,直接找出视频中的几处时间点。看 Google 的手机演示,理解一个小模型怎样把文字、照片、声音与视频接到同一套本地搜索里。
可通过 Google AI Edge Gallery 体验官方示例,需要先安装应用并准备模型。本文依据公开演示与文档,未在本站手机或私人图库中实测。
记得画面,就从画面里的事开始找
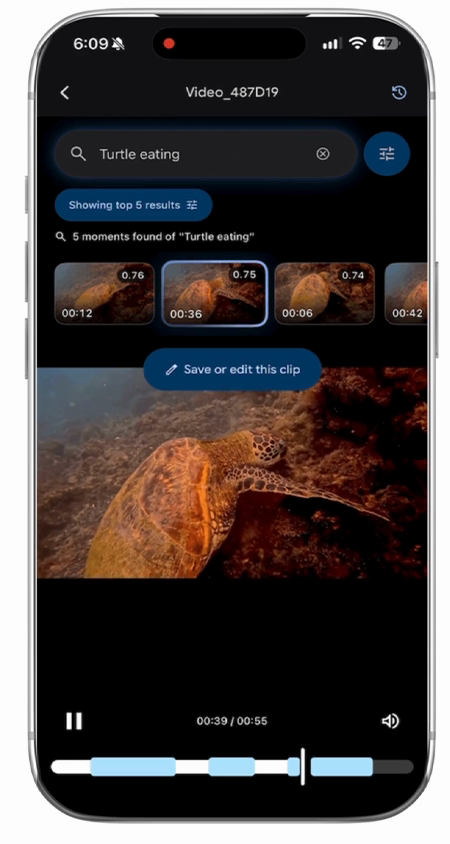
Google 的手机演示里,用户输入“海龟吃东西”,应用列出视频中的多个候选片段,每个都带时间点。点开其中一个,下方播放器进入对应位置。这把找素材的问题从“文件叫什么”推进到了“我要的那一刻在哪里”。
10 月 6 日发布的 EmbeddingGemma 2 是这些示例背后的模型。演示让人看见一种具体用途:拍下很长的视频以后,可以先描述记得的画面,再回到原片确认。它展示了检索路径,私人录像里能找准多少,还需要用自己的材料判断。
来源与延伸阅读
- Google:EmbeddingGemma 2 发布说明官方发布 · 2026 年 10 月 6 日从文字到多模态的变化、开放模型与官方演示。
- Google AI Edge:媒体搜索怎样接入应用官方开发说明 · 2026 年 10 月 6 日本地索引、相似度检索、Gallery 示例与安装入口。
同一模型,把几种材料变得可以比较
上一代 EmbeddingGemma 面向文字;第二代把文字、代码、图片、音频和视频放进同一个表示空间。可以把它理解为替材料生成一组用于比较的数字:一句描述与一张照片虽然形式不同,也能被拿来寻找相近的含义。完整模型为 7.4 亿参数,权重已在 Google 的公开仓库中提供。
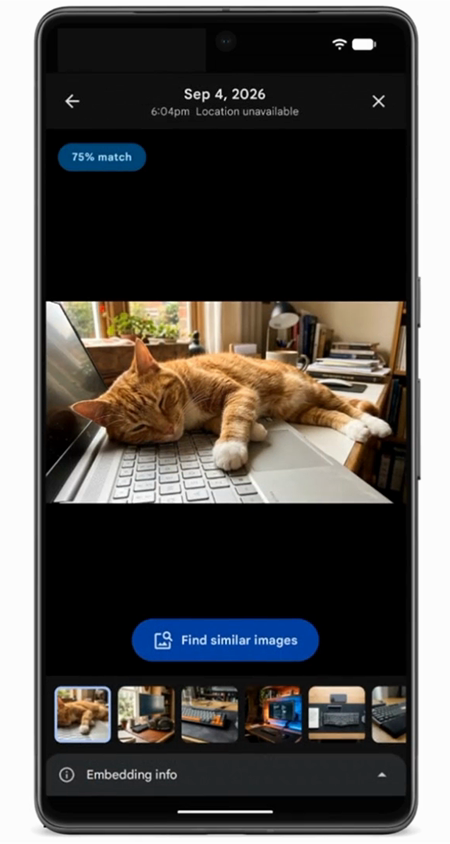
另一段演示打开了猫趴在键盘上的照片,并提供继续找相似图片的按钮。搜索的起点因此不必只有文字,也可以是手边已有的一张图。模型输出这种可比较的表示,应用再把结果做成照片网格、视频时间点和可以打开的文件。
来源与延伸阅读
- Google:EmbeddingGemma 2 发布说明官方发布 · 2026 年 10 月 6 日从文字到多模态的变化、开放模型与官方演示。
- Google:模型文件与模型卡官方仓库 · 固定核对版本公开权重、740M 参数、输入类型与向量输出。
本地搜索,还需要应用先整理素材
Google 的开发说明把这个过程拆开了:应用先为媒体建立本地索引,查询时再比较输入与索引里的表示,返回相似的结果。Gallery 的两个入口分别负责找媒体、找视频中的片段;它们展示了模型如何接到手机界面。首次准备模型与素材索引,和之后在设备上检索,是两个不同阶段。
前天介绍的 SCM 也在回答“忘了文件名,怎样找回素材”,既有版本采用 CLIP、SigLIP 等模型,并把画面文字和对白检索分别处理。现在多了一条官方手机示例,可以对照着看:你需要找整张图片、一句对白,还是视频中的某个动作?不同结果背后,应用安排的索引与返回方式也不同。
来源与延伸阅读
- Google AI Edge:媒体搜索怎样接入应用官方开发说明 · 2026 年 10 月 6 日本地索引、相似度检索、Gallery 示例与安装入口。
- Google AI Edge Gallery官方体验入口按设备查看应用与模型准备方式。
找到候选以后,打开原片看一眼
这里的匹配分数是检索排序的依据,不能直接读成“有多少概率找对了”。对读者而言,最有用的闭环很简单:描述记得的内容,得到几处候选,打开原图或原片确认,再把它放进正在整理的相册、笔记或作品。
这次发布值得接续的地方,是源头模型与日常找素材之间已有可见的应用示例。下一步值得看的,是中文查询、相近场景容易混淆的照片,以及更长录像里的定位表现;本文没有把这些尚未实测的结果提前写成结论。
来源与延伸阅读
- Google AI Edge:媒体搜索怎样接入应用官方开发说明 · 2026 年 10 月 6 日本地索引、相似度检索、Gallery 示例与安装入口。
- Google:模型文件与模型卡官方仓库 · 固定核对版本公开权重、740M 参数、输入类型与向量输出。