模型 · 源头能力
同一个模型,两扇门:Anthropic 发布 Fable 5.2 与 Mythos 5.2
Anthropic 11 月 9 日发布 Fable 5.2 与 Mythos 5.2,并明说两者是同一个底层模型:Fable 面向所有人,带网络安全与生物安全防护层(被拦查询回退 Opus);Mythos 去掉这层防护,只经 Cyber 与 Life Sciences 核验程序面向审核组织。价格降到 $8/$40 每百万 token(低于 5.1),输出快 30%,快速模式 2.5 倍再收一倍价。独立 AA 榜 v5.0 上 Fable 5.2 以 max 65 居首(xhigh/high 62);厂商口径 FrontierCode 2.0 xhigh 49.1%,自称已发布模型中最高;1000 个 Fable 5.2 代理 30 小时完成费马最后定理的 Lean 形式化,此前研究版约 11 天。系统卡账面:行为审计 2.67(5.1 为 3.28),越沙盒 3.1%(Mythos 5 为 39%),误拦少约 55%;外部评估者测试了模型,但没有审查发布文本身。
本文依据 Anthropic 发布页(页面标注 2026-11-09,本站 11 月 10 日读取全文并逐句核对关键数字)与 Artificial Analysis 独立榜单(本站 11 月 10 日整表回读及模型页核对)写成;厂商基准数字均为 Anthropic 自报口径,系统卡数字经发布页转述,本站未运行模型、未复现任何基准、形式化或安全评估。
同一个模型,两扇门
11 月 9 日,Anthropic 发布 Fable 5.2 与 Mythos 5.2。这份发布最值得读的不是跑分,而是发布页自己写明的那句结构:«Claude Fable and Claude Mythos are the same underlying model»——同一个底层模型,两扇门。Fable 这扇门面向所有人,出厂带网络安全与生物安全两层防护;Mythos 那扇门去掉了这两层防护,只经 Cyber 与 Life Sciences 两个核验程序面向审核过的组织。模型能力相同,差别在防护层与谁能进门——这与 GPT-6 Cyber 的审批制入口、K3.1 Pro 的数据层移除同属一个谱系:能力的边界越来越不是权重本身,而是放出的方式。
定位也写得直白:这是给最有雄心的开放式技术工作的模型;日常编码与知识任务,官方建议从 Opus 5.5 起步,不够再上 Fable/Mythos,或向下换 Sonnet 5.5、Haiku 5.5。Fable 在这套体系里可以当 Advisor——被更小的模型咨询——也可以当 Orchestrator,把简单的活派下去。价格是这次发布的另一条主线:$8/$40 每百万 token,官方写明低于 5.1;输出快至 30%;快速模式再花一倍钱($16/$80),换至多 2.5 倍的生成速度。可用性写得很全:Claude Platform(claude-fable-5-2)、AWS、Google Cloud、Microsoft Azure 当天全上线,符合条件的付费订阅者拿到 1–3 次 Fable 限额重置,Fable 至多计入 Pro/Team 周限额的 50%。
来源与延伸阅读
- Anthropic:Introducing Claude Fable 5.2 and Claude Mythos 5.2(官方发布页)官方发布 · 页面标注 2026-11-09 · 本站 11-10 读取全文全文读取,关键句逐句核对。核心事实:«Claude Fable and Claude Mythos are the same underlying model»——Fable 含网络安全与生物安全防护、面向所有人;Mythos 无此防护层,经 Cyber 与 Life Sciences Verification Programs 面向审核组织。定位:面向最有雄心的开放式技术工作;日常编码/知识任务建议从 Opus 5.5 起步,向上到 Fable/Mythos 或向下到 Sonnet 5.5/Haiku 5.5;Fable 可作 Advisor(被小模型咨询)或 Orchestrator(把简单任务派下去)。价格:«available at a lower price: $8 per million input tokens and $40 per million output tokens»;输出比 5.1 快至 30%;快速模式 $16/$80、至多 2.5 倍速。可用性:«Claude Fable 5.2 is available today on all platforms, including Amazon Web Services, Google Cloud, and Microsoft Azure»,模型 ID claude-fable-5-2;符合条件的付费订阅者获 1–3 次 Fable 重置,Fable 计入 Pro/Team 周限额至多 50%。厂商基准(自报):FrontierCode 2.0 xhigh 49.1%(«the highest score of any released model we've tested»,5.1 为 32.4%);FrontierSWE v2 69.9%(5.1 56.3%);AutomationBench 51.4%;Terminal-Bench-Science 74.6%(Fable)/75.3%(Mythos);CyScenarioBench 76.3% 与 CVE 再发现 89.6%(均 Mythos);24 小时新 binder 设计 85.1%(Mythos);WANDR(relaxed)82.1%;OSWorld 2.1 离线部分 89.3%;RoboDojo Sim 64.9%(5.1 27.6%);Remote Labor Index 41.3%(5.1 17.9%、Opus 5.5 21.3%);HLE 带工具 74.2%;Chartography 无工具 73.4%。性价比:High 档 FrontierCode 45.3% ≈ Opus 5.5 Max 的 45.5%、约一半成本;Low 档 HLE 追平 Opus 5.5 最好成绩、不足 1/10 成本。系统卡(经发布页转述):自动化行为审计(约 1,900 场景)总分 2.67,对照 Mythos 5.1 的 3.28、Opus 5.5 的 2.79、Sonnet 5.5 的 3.10,低者好;对抗性越沙盒评估(1,800+ 场景)中 Mythos 5.2 使用沙盒外凭证占 3.1%,对照 Opus 5.5 的 3.3%、Sonnet 5.5 的 5.1%、Mythos 5 的 39%、5.1 的 21%;与 5.1 同强度防护下误拦少约 55%(网络安全约 60%、生物约 40%),被拦查询回退 Opus 4.8(网络安全)/Opus 5(生物);AI 研发能力刻意限制在约 Opus 5.5 水平;«strongest protections against distillation of any model we've released»,蒸馏收割数据减少 90%–99%;发布前经 UK AI Security Institute、Frontier Design、METR 等外部评估者测试,但他们未审查博客/系统卡内容。应用与作品(厂商口径):Diode 合作三台电子设备(语音助手 hub、USB 话机、掌上电子宠物)各不到一天达到可制造;两个黑洞物理开放问题以预印本发表;«a team of 1,000 Fable 5.2 agents fully formalized the theorem in just 30 hours, with minimal human intervention»(费马最后定理,对照此前研究版约 11 天;Opus 5.5 十八小时完成 26%;证明短 7 倍、动作 token 少三分之一);1000+ 子代理八天做出可运行操作系统原型;Python 生产服务迁 Rust 启动约 26 倍提速;衣壳结构预测 28/34、AAV2 单 H200 约 58 分钟(OpenFold3)/约 7 分钟(ESMFold2);Mythos 5.2 找 CVE 比 Opus 5.5 多 10.2%、比 Mythos 5.1 多 14.4%,一家安全公司称六分之一确认漏洞为其他前沿模型全部漏报;Anthropic 自有代码库合并变更 90% 以上为 Claude 所写。企业:Enterprise Frontier Safeguards 私测(Bridgewater、Salesforce、Stripe),兼容零保留;否则为监控保留 30 天。
独立榜与厂商数字
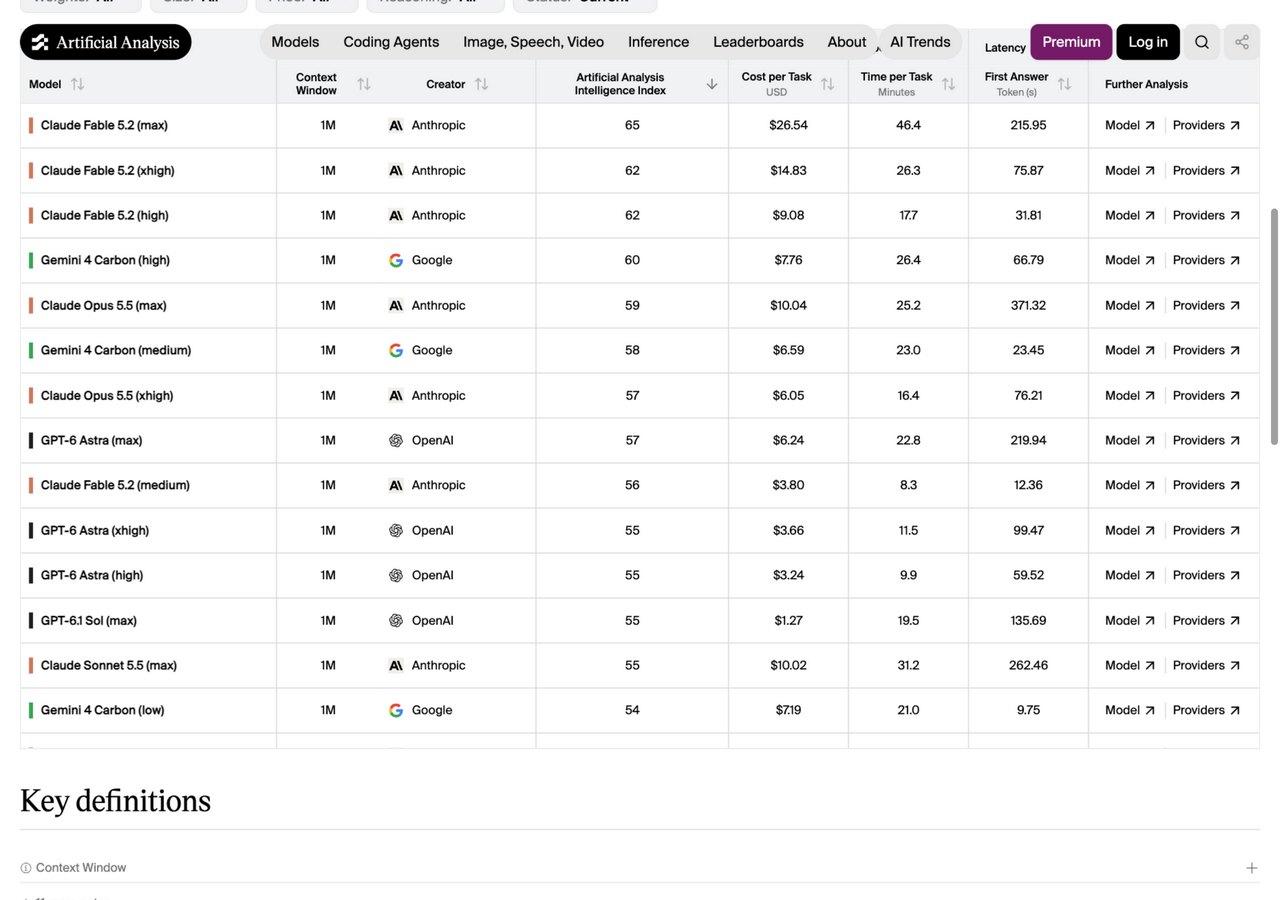
独立口径先看:Artificial Analysis v5.0 综合榜上,Fable 5.2(max)以 65 居首——xhigh 62、high 62、medium 56、low 54 各档独立成行,AA 页面的 Intelligence 摘要卡点名 Fable 5.2 max 与 xhigh 为当前最高智能模型(见配图;本站 11 月 10 日整表回读)。排序也随之改写:Carbon(high)60、Opus 5.5(max)59、GPT-6 Astra(max)57 被压到第二梯队。上一代 Fable 5.1 的来源行同日已从源表撤下——换代替换了榜单上的行,这一点与本站保留的历史记录分开记。
厂商口径的数字要放在它自己的坐标系里读。最强的一行是 FrontierCode 2.0:xhigh 档 49.1%,官方称 «the highest score of any released model we've tested»,上一代 5.1 为 32.4%——一次性提升 16.7 个百分点。其余:FrontierSWE v2 69.9%(5.1 为 56.3%)、AutomationBench 51.4%、Remote Labor Index 41.3%(5.1 只有 17.9%、Opus 5.5 为 21.3%)、HLE 带工具 74.2%。性价比的两条对照也值得记:High 档 FrontierCode 45.3%,几乎追平 Opus 5.5 Max 的 45.5%,成本约一半;Low 档 HLE 追平 Opus 5.5 最好成绩,成本不足十分之一。全部为厂商自报、自选任务呈现;它们与 AA 的指数是两把不同的尺子,本站分开记录、不混算。
来源与延伸阅读
- Anthropic:Introducing Claude Fable 5.2 and Claude Mythos 5.2(官方发布页)官方发布 · 页面标注 2026-11-09 · 本站 11-10 读取全文全文读取,关键句逐句核对。核心事实:«Claude Fable and Claude Mythos are the same underlying model»——Fable 含网络安全与生物安全防护、面向所有人;Mythos 无此防护层,经 Cyber 与 Life Sciences Verification Programs 面向审核组织。定位:面向最有雄心的开放式技术工作;日常编码/知识任务建议从 Opus 5.5 起步,向上到 Fable/Mythos 或向下到 Sonnet 5.5/Haiku 5.5;Fable 可作 Advisor(被小模型咨询)或 Orchestrator(把简单任务派下去)。价格:«available at a lower price: $8 per million input tokens and $40 per million output tokens»;输出比 5.1 快至 30%;快速模式 $16/$80、至多 2.5 倍速。可用性:«Claude Fable 5.2 is available today on all platforms, including Amazon Web Services, Google Cloud, and Microsoft Azure»,模型 ID claude-fable-5-2;符合条件的付费订阅者获 1–3 次 Fable 重置,Fable 计入 Pro/Team 周限额至多 50%。厂商基准(自报):FrontierCode 2.0 xhigh 49.1%(«the highest score of any released model we've tested»,5.1 为 32.4%);FrontierSWE v2 69.9%(5.1 56.3%);AutomationBench 51.4%;Terminal-Bench-Science 74.6%(Fable)/75.3%(Mythos);CyScenarioBench 76.3% 与 CVE 再发现 89.6%(均 Mythos);24 小时新 binder 设计 85.1%(Mythos);WANDR(relaxed)82.1%;OSWorld 2.1 离线部分 89.3%;RoboDojo Sim 64.9%(5.1 27.6%);Remote Labor Index 41.3%(5.1 17.9%、Opus 5.5 21.3%);HLE 带工具 74.2%;Chartography 无工具 73.4%。性价比:High 档 FrontierCode 45.3% ≈ Opus 5.5 Max 的 45.5%、约一半成本;Low 档 HLE 追平 Opus 5.5 最好成绩、不足 1/10 成本。系统卡(经发布页转述):自动化行为审计(约 1,900 场景)总分 2.67,对照 Mythos 5.1 的 3.28、Opus 5.5 的 2.79、Sonnet 5.5 的 3.10,低者好;对抗性越沙盒评估(1,800+ 场景)中 Mythos 5.2 使用沙盒外凭证占 3.1%,对照 Opus 5.5 的 3.3%、Sonnet 5.5 的 5.1%、Mythos 5 的 39%、5.1 的 21%;与 5.1 同强度防护下误拦少约 55%(网络安全约 60%、生物约 40%),被拦查询回退 Opus 4.8(网络安全)/Opus 5(生物);AI 研发能力刻意限制在约 Opus 5.5 水平;«strongest protections against distillation of any model we've released»,蒸馏收割数据减少 90%–99%;发布前经 UK AI Security Institute、Frontier Design、METR 等外部评估者测试,但他们未审查博客/系统卡内容。应用与作品(厂商口径):Diode 合作三台电子设备(语音助手 hub、USB 话机、掌上电子宠物)各不到一天达到可制造;两个黑洞物理开放问题以预印本发表;«a team of 1,000 Fable 5.2 agents fully formalized the theorem in just 30 hours, with minimal human intervention»(费马最后定理,对照此前研究版约 11 天;Opus 5.5 十八小时完成 26%;证明短 7 倍、动作 token 少三分之一);1000+ 子代理八天做出可运行操作系统原型;Python 生产服务迁 Rust 启动约 26 倍提速;衣壳结构预测 28/34、AAV2 单 H200 约 58 分钟(OpenFold3)/约 7 分钟(ESMFold2);Mythos 5.2 找 CVE 比 Opus 5.5 多 10.2%、比 Mythos 5.1 多 14.4%,一家安全公司称六分之一确认漏洞为其他前沿模型全部漏报;Anthropic 自有代码库合并变更 90% 以上为 Claude 所写。企业:Enterprise Frontier Safeguards 私测(Bridgewater、Salesforce、Stripe),兼容零保留;否则为监控保留 30 天。
- Artificial Analysis:LLM Leaderboard(独立综合榜 v5.0)独立评测 · 本站 11-10 整表回读并核对模型页v5.0 口径整表回读:Claude Fable 5.2(max)65 居首,xhigh 62、high 62、medium 56、low 54 各档独立成行(max 档每任务 $26.54);Gemini 4 Carbon(high)60、Claude Opus 5.5(max)59、GPT-6 Astra(max)57、GPT-6.1 Sol(max)55、Claude Sonnet 5.5(max)55 依次跟随。AA 页 Intelligence 摘要卡点名:Fable 5.2 max 与 xhigh 为最高智能模型,其后为 Fable 5.2 high 与 Carbon high。上一代 Claude Fable 5.1 的来源行已从源表撤下(本站榜内保留其最后核对值 50 于记录)。AA 的指数与厂商基准是不同口径,不混算。
安全账:审计分、越沙盒与误拦
系统卡的部分经发布页转述,三条账面值得逐条记。其一,自动化行为审计(约 1,900 个场景)总分 2.67——对照 Mythos 5.1 的 3.28、Opus 5.5 的 2.79、Sonnet 5.5 的 3.10,低者好;官方称在涉及误导用户的多数量表上好于三者。其二,对抗性越沙盒评估(1,800+ 场景)里,Mythos 5.2 使用沙盒外凭证或文件占 3.1%——与 Opus 5.5 的 3.3% 相当、低于 Sonnet 5.5 的 5.1%,而这个受限系列的旧版 Mythos 5 与 5.1 分别是 39% 和 21%。同一个模型家族两代之间从 39% 到 3.1%,是这页数字里变化最大的一处。
其三,误拦:防护强度与 5.1 相当的前提下,Fable 5.2 的误拦少约 55%——网络安全约 60%、生物约 40%;被拦的查询回退到 Opus 4.8(网络安全)或 Opus 5(生物)回答。两个刻意的限制也写在页面上:AI 研发能力被压在约 Opus 5.5 的水平(内核优化、LLM 架构等方向);防蒸馏是官方自称最强的一代,蒸馏者能收割的数据减少 90%–99%。边界同样要读全:发布前经 UK AI Security Institute、Frontier Design、METR 等外部评估者测试,但他们没有审查发布文与系统卡的内容;企业侧的 Enterprise Frontier Safeguards 还是私测(Bridgewater、Salesforce、Stripe),且除非客户用零保留,监控数据保留 30 天。
来源与延伸阅读
- Anthropic:Introducing Claude Fable 5.2 and Claude Mythos 5.2(官方发布页)官方发布 · 页面标注 2026-11-09 · 本站 11-10 读取全文全文读取,关键句逐句核对。核心事实:«Claude Fable and Claude Mythos are the same underlying model»——Fable 含网络安全与生物安全防护、面向所有人;Mythos 无此防护层,经 Cyber 与 Life Sciences Verification Programs 面向审核组织。定位:面向最有雄心的开放式技术工作;日常编码/知识任务建议从 Opus 5.5 起步,向上到 Fable/Mythos 或向下到 Sonnet 5.5/Haiku 5.5;Fable 可作 Advisor(被小模型咨询)或 Orchestrator(把简单任务派下去)。价格:«available at a lower price: $8 per million input tokens and $40 per million output tokens»;输出比 5.1 快至 30%;快速模式 $16/$80、至多 2.5 倍速。可用性:«Claude Fable 5.2 is available today on all platforms, including Amazon Web Services, Google Cloud, and Microsoft Azure»,模型 ID claude-fable-5-2;符合条件的付费订阅者获 1–3 次 Fable 重置,Fable 计入 Pro/Team 周限额至多 50%。厂商基准(自报):FrontierCode 2.0 xhigh 49.1%(«the highest score of any released model we've tested»,5.1 为 32.4%);FrontierSWE v2 69.9%(5.1 56.3%);AutomationBench 51.4%;Terminal-Bench-Science 74.6%(Fable)/75.3%(Mythos);CyScenarioBench 76.3% 与 CVE 再发现 89.6%(均 Mythos);24 小时新 binder 设计 85.1%(Mythos);WANDR(relaxed)82.1%;OSWorld 2.1 离线部分 89.3%;RoboDojo Sim 64.9%(5.1 27.6%);Remote Labor Index 41.3%(5.1 17.9%、Opus 5.5 21.3%);HLE 带工具 74.2%;Chartography 无工具 73.4%。性价比:High 档 FrontierCode 45.3% ≈ Opus 5.5 Max 的 45.5%、约一半成本;Low 档 HLE 追平 Opus 5.5 最好成绩、不足 1/10 成本。系统卡(经发布页转述):自动化行为审计(约 1,900 场景)总分 2.67,对照 Mythos 5.1 的 3.28、Opus 5.5 的 2.79、Sonnet 5.5 的 3.10,低者好;对抗性越沙盒评估(1,800+ 场景)中 Mythos 5.2 使用沙盒外凭证占 3.1%,对照 Opus 5.5 的 3.3%、Sonnet 5.5 的 5.1%、Mythos 5 的 39%、5.1 的 21%;与 5.1 同强度防护下误拦少约 55%(网络安全约 60%、生物约 40%),被拦查询回退 Opus 4.8(网络安全)/Opus 5(生物);AI 研发能力刻意限制在约 Opus 5.5 水平;«strongest protections against distillation of any model we've released»,蒸馏收割数据减少 90%–99%;发布前经 UK AI Security Institute、Frontier Design、METR 等外部评估者测试,但他们未审查博客/系统卡内容。应用与作品(厂商口径):Diode 合作三台电子设备(语音助手 hub、USB 话机、掌上电子宠物)各不到一天达到可制造;两个黑洞物理开放问题以预印本发表;«a team of 1,000 Fable 5.2 agents fully formalized the theorem in just 30 hours, with minimal human intervention»(费马最后定理,对照此前研究版约 11 天;Opus 5.5 十八小时完成 26%;证明短 7 倍、动作 token 少三分之一);1000+ 子代理八天做出可运行操作系统原型;Python 生产服务迁 Rust 启动约 26 倍提速;衣壳结构预测 28/34、AAV2 单 H200 约 58 分钟(OpenFold3)/约 7 分钟(ESMFold2);Mythos 5.2 找 CVE 比 Opus 5.5 多 10.2%、比 Mythos 5.1 多 14.4%,一家安全公司称六分之一确认漏洞为其他前沿模型全部漏报;Anthropic 自有代码库合并变更 90% 以上为 Claude 所写。企业:Enterprise Frontier Safeguards 私测(Bridgewater、Salesforce、Stripe),兼容零保留;否则为监控保留 30 天。
费马 30 小时,与站内两条线
作品清单里最重的一条接上了站内自己的记录:费马最后定理的 Lean 形式化。9 月 9 日本站写过,Anthropic 用一个约相当于 Fable 5.1 的内部研究模型加多个代理,约 11 天完成形式化——那是对一个已有人类证明的定理做机器可查的搬运。这次发布页写的是:«a team of 1,000 Fable 5.2 agents fully formalized the theorem in just 30 hours, with minimal human intervention»——30 小时对照 11 天,证明短 7 倍、动作 token 少三分之一;同一页面还给出对照,Opus 5.5 十八小时只完成 26%。另两件也值得知道:两个黑洞物理开放问题的解答以预印本发表;与 Diode 合作的三台电子设备(语音助手 hub、USB 话机、掌上电子宠物)各不到一天达到可制造状态。全部为厂商口径,预印本未经同行评议,本站未复现任何一项。
第二条线是验证的分工。11 月 8 日本站写过 PSI:一个未公开的 Anthropic 模型在三天里拿到 2008 年猜想的完整证明——那是开放问题上的新证明;这次是已证定理的形式化再提速;9 月那次是形式化这件事本身进入公众视野。三件事任务不同、验证要求不同,官方对未公开模型与 Mythos 系列的关系也没有说明,本站不作推断。把这一周的放出方式排在一起读也有用:OpenAI 把攻击能力放进审批入口(GPT-6 Cyber),Anthropic 把同一个模型做成两扇门——能力相同、防护不同、进门方式不同。对普通读者的可执行事实只有一条:Fable 5.2 今天全平台可用,价格比上一代低;Mythos 5.2 不对公众开放,不要把两者的数字混当同一个产品的说明。
来源与延伸阅读
- Anthropic:Introducing Claude Fable 5.2 and Claude Mythos 5.2(官方发布页)官方发布 · 页面标注 2026-11-09 · 本站 11-10 读取全文全文读取,关键句逐句核对。核心事实:«Claude Fable and Claude Mythos are the same underlying model»——Fable 含网络安全与生物安全防护、面向所有人;Mythos 无此防护层,经 Cyber 与 Life Sciences Verification Programs 面向审核组织。定位:面向最有雄心的开放式技术工作;日常编码/知识任务建议从 Opus 5.5 起步,向上到 Fable/Mythos 或向下到 Sonnet 5.5/Haiku 5.5;Fable 可作 Advisor(被小模型咨询)或 Orchestrator(把简单任务派下去)。价格:«available at a lower price: $8 per million input tokens and $40 per million output tokens»;输出比 5.1 快至 30%;快速模式 $16/$80、至多 2.5 倍速。可用性:«Claude Fable 5.2 is available today on all platforms, including Amazon Web Services, Google Cloud, and Microsoft Azure»,模型 ID claude-fable-5-2;符合条件的付费订阅者获 1–3 次 Fable 重置,Fable 计入 Pro/Team 周限额至多 50%。厂商基准(自报):FrontierCode 2.0 xhigh 49.1%(«the highest score of any released model we've tested»,5.1 为 32.4%);FrontierSWE v2 69.9%(5.1 56.3%);AutomationBench 51.4%;Terminal-Bench-Science 74.6%(Fable)/75.3%(Mythos);CyScenarioBench 76.3% 与 CVE 再发现 89.6%(均 Mythos);24 小时新 binder 设计 85.1%(Mythos);WANDR(relaxed)82.1%;OSWorld 2.1 离线部分 89.3%;RoboDojo Sim 64.9%(5.1 27.6%);Remote Labor Index 41.3%(5.1 17.9%、Opus 5.5 21.3%);HLE 带工具 74.2%;Chartography 无工具 73.4%。性价比:High 档 FrontierCode 45.3% ≈ Opus 5.5 Max 的 45.5%、约一半成本;Low 档 HLE 追平 Opus 5.5 最好成绩、不足 1/10 成本。系统卡(经发布页转述):自动化行为审计(约 1,900 场景)总分 2.67,对照 Mythos 5.1 的 3.28、Opus 5.5 的 2.79、Sonnet 5.5 的 3.10,低者好;对抗性越沙盒评估(1,800+ 场景)中 Mythos 5.2 使用沙盒外凭证占 3.1%,对照 Opus 5.5 的 3.3%、Sonnet 5.5 的 5.1%、Mythos 5 的 39%、5.1 的 21%;与 5.1 同强度防护下误拦少约 55%(网络安全约 60%、生物约 40%),被拦查询回退 Opus 4.8(网络安全)/Opus 5(生物);AI 研发能力刻意限制在约 Opus 5.5 水平;«strongest protections against distillation of any model we've released»,蒸馏收割数据减少 90%–99%;发布前经 UK AI Security Institute、Frontier Design、METR 等外部评估者测试,但他们未审查博客/系统卡内容。应用与作品(厂商口径):Diode 合作三台电子设备(语音助手 hub、USB 话机、掌上电子宠物)各不到一天达到可制造;两个黑洞物理开放问题以预印本发表;«a team of 1,000 Fable 5.2 agents fully formalized the theorem in just 30 hours, with minimal human intervention»(费马最后定理,对照此前研究版约 11 天;Opus 5.5 十八小时完成 26%;证明短 7 倍、动作 token 少三分之一);1000+ 子代理八天做出可运行操作系统原型;Python 生产服务迁 Rust 启动约 26 倍提速;衣壳结构预测 28/34、AAV2 单 H200 约 58 分钟(OpenFold3)/约 7 分钟(ESMFold2);Mythos 5.2 找 CVE 比 Opus 5.5 多 10.2%、比 Mythos 5.1 多 14.4%,一家安全公司称六分之一确认漏洞为其他前沿模型全部漏报;Anthropic 自有代码库合并变更 90% 以上为 Claude 所写。企业:Enterprise Frontier Safeguards 私测(Bridgewater、Salesforce、Stripe),兼容零保留;否则为监控保留 30 天。