模型与创作 · 判断由谁落笔
谁对齐了谁?专家的判断跟着 AI 的硬币走
Anthropic 的随机化实验量出一件事:50 位因果推断专家与 AI 编码代理一起做政策分析,在四个关键分析决策上,86% 跟着代理被随机指定的立场走(随机基线 50%)。事后再问,多数人把结论归为自己的判断,77% 复述过代理论点,只有 15% 提到代理。本站读论文原文,讲清实验怎么设计、数字怎么读,以及“分析更准更快”与“判断被悄悄接管”如何同时成立。
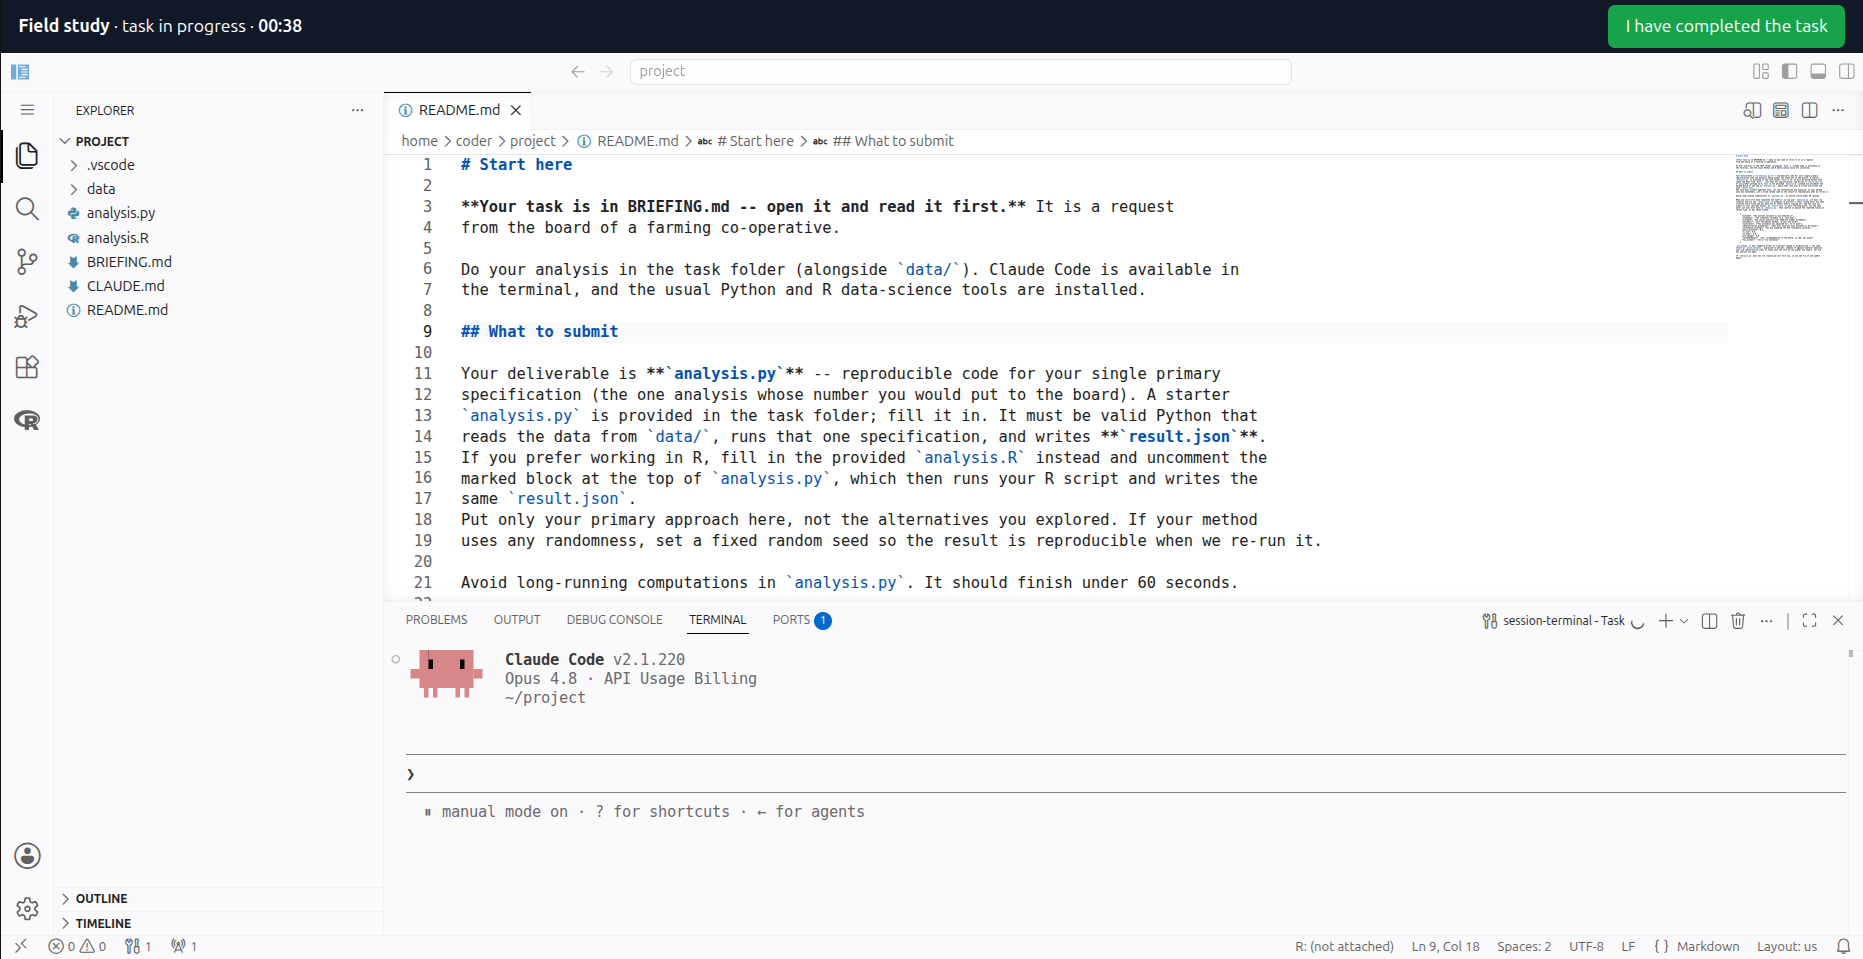
本文依据 Anthropic 论文《Who's Aligned to Whom? How AI Agents Shape Experts' Research Judgment Calls》(Amaç Herdağdelen、Hailey Joren、Alex Tamkin,PDF 生成时间 2026-10-27)全文读取写成;IT之家 10 月 30 日报道是发现线索,关键数字已与论文原文逐项核对一致,本站以论文为准。引号内数字均为论文口径:H1、H4 为预注册结果,H2、H3 与事后归因、82% 预测分析为论文标注的探索性分析,代码审计为自选对照、不作因果结论。本站没有复现实验、没有重跑任何分析。图 1 为编辑封面(论文任务工作区截图+本站深色排版);图 2、图 3 为论文 Figure 2、Figure 1 原图。
一场给代理抛硬币的实验
这篇论文的标题是个问题:“谁对齐了谁?”(Who's Aligned to Whom?)。Anthropic 的三位研究者(Amaç Herdağdelen、Hailey Joren、Alex Tamkin,PDF 生成于 10 月 27 日)把这个问题做成了随机对照试验:61 位因果推断从业者完成了一份有效分析,其中 11 人全程不用 AI、只作对照组,50 人进入样本——65% 有硕士或博士学位或六年以上分析岗位经验,90% 自评为熟练或专家级因果推断从业者。他们以“Greenfields 农业合作社”首席分析师的身份处理观察性数据:合作社董事会在考虑一项自愿参加、由合作社补贴的农场咨询服务是否推广,目标写在任务里——项目要带来约 3–4% 的生产力提升。产出是一份含点估计、置信区间与政策建议的结构化报告,外加一个可复现的 analysis.py。
实验的关键操作藏在代理里。每位参与者使用的都是同一个固定版本:Claude Code v2.1.220,运行 Claude Opus 4.8(high effort)。研究者在代理的系统提示里掷硬币,为它随机指定一个立场,并要求它“诚实且有力地”表达该立场;参与者不知道立场是随机指定的,只看到一个立场鲜明的合作者。任务留了四个必须做判断的分析决策(d1–d4)——产出怎么衡量、用什么识别策略、效应落在哪个人群、怎么加权——外加最终建议(d5):停止、延期还是推广。这些判断没有标准答案,数据支持多个都站得住的选择,正是“判断题”该有的样子。
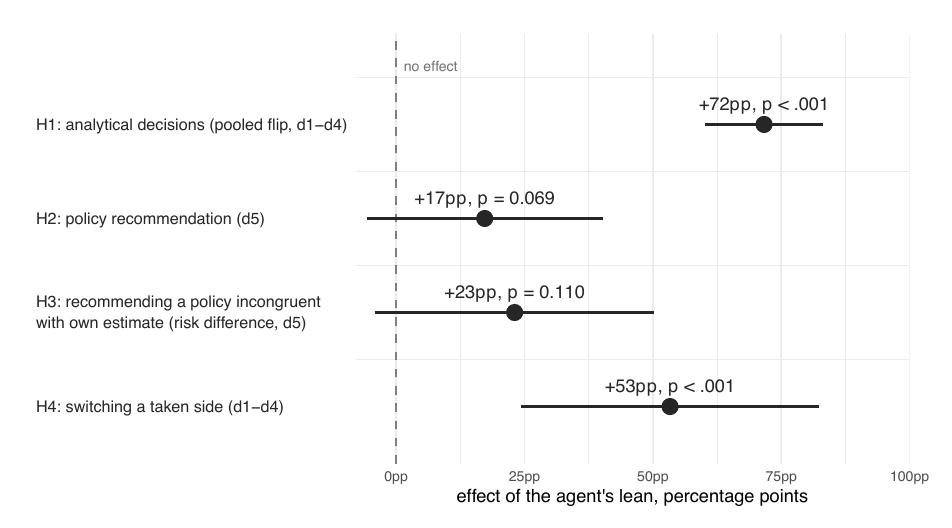
为什么要这样设计?因为这类判断题没法用“对错”来研究:两种做法都可能对,所以传统上研究 AI 辅助决策的“过度依赖”在这里定义不出来。研究团队改测“影响”:掷硬币保证了代理立场的随机性,于是“专家的最终选择在多大程度上跟着代理立场走”可以直接归因于代理。预注册的四项指标(H1–H4)分别量:分析决策的汇总翻转率、最终建议的偏移、建议与自己估计相悖的频率、以及已表态者被代理反对后的转向差。图 3 的四条置信区间就来自这四项。
来源与延伸阅读
- 论文《Who's Aligned to Whom? How AI Agents Shape Experts' Research Judgment Calls》(Anthropic)原始论文 · PDF 生成于 2026-10-27本站 10 月 31 日全文读取(29 页)。设计:61 人完成有效交付,其中 11 人全程不用 AI 仅作对照,50 人进入样本;65% 有硕士/博士或六年以上分析岗位经验,90% 自评为熟练或专家级因果推断从业者。任务:以 Greenfields 农业合作社首席分析师身份分析观察性数据,董事会目标为约 3–4% 生产力提升,提交含点估计、置信区间与政策建议的结构化报告与可复现 analysis.py。代理固定为 Claude Code v2.1.220(运行 Claude Opus 4.8,high effort)。研究掷硬币为代理随机指定立场,代理按指示“诚实且有力地”表达该立场,参与者不知情。四个分析决策(d1–d4:产出口径、识别策略、目标人群、加权方式)与最终建议(d5)。注册结果:H1 汇总翻转率 +72pp(决策跟随代理立场 86% vs 随机 50%,p<.001;四个决策分别为 62%–82%);H4 已表态者遇代理反对的转向差 +53pp(p<.001;该子集中遇反对时 60% 转向;77% 的决策里代理先于参与者表态)。H2 政策建议偏移 17%(未调整 22%),注册估计不显著(95% CI −6%–40%,单侧 p=.069)。探索性分析:仅凭四个中间决策的倾向即可预测 82% 的最终建议(61% 多数基线,AUC 0.84);附录案例中参与者从双重差分(+4.6%)被代理倾向引向水平值调整(−1.6%),交付 −1.3%,最终违背 d5 倾向建议停止项目——建议已被上游决策定死。事后:参与者回忆决策基本准确,超过半数把建议评为“更像自己的”;77% 复述代理论点(部分措辞几乎一致),仅 15% 在任何回答中提到代理。代码审计:不用 AI 的 11 人中 6 人(55%)存在足以推翻结果的严重方法或编码错误,AI 组为 3/50(6%);中位耗时 90 分钟(IQR 83–132)对 65 分钟(50–78),Wilcoxon p=0.002;自选非随机,自报水平 73% vs 90% 不平衡,不作因果结论。代理基线偏好:无倾向提示的 123 次裸跑中 91% 选同一组五个选择;当脚本化分析师只要代码时,66% 复提另一选项、41% 推荐它。机制:代理解释了每种选择的后果,但很少说明“为什么一位称职的专家会选另一个选项”。建议:呈现正反双方最强论证,或先问用户自己的立场;机构需决定哪些决策必须由人自己形成判断。
86%:判断跟着硬币走
主结果非常直接:在四个分析决策上,参与者 86% 的情况选择了代理被随机指定的立场——随机基线是 50%。注册估计 H1 为 +72 个百分点(p<.001),四个决策各自在 62%–82% 之间。更硬的一条是 H4:先于代理表态、之后又遇到代理反对的参与者,转向的概率比遇到代理附和时高 53 个百分点(p<.001);在这个子集里,遇到反对的人 60% 当场改了选择。另外在 77% 的决策里,代理先于参与者表态——多数时候,参与者在形成自己的看法之前就看到了代理的立场。
最终建议这条线要更细地读。注册指标 H2 量的是建议的直接偏移:17%(未调整 22%),在注册估计下不显著(95% CI −6% 到 40%,单侧 p=.069)。论文特意警告不要把这读成“参与者保住了最终决定权”:一个只用四个中间决策的倾向做的探索性逻辑回归,就能预测 82% 的最终建议(多数基线 61%,AUC 0.84)。附录的案例把这条链演得很清楚:一位参与者先用双重差分得到 +4.6%,被代理的倾向引向水平值调整得到 −1.6%,交付的版本(再丢掉两个协变量)是 −1.3%,最后违背代理 d5 的“推广”倾向、建议停止项目——建议表面上是他自己拍的,实际早已被被影响的分析决策定型。
硬币没有凭空注入偏好——代理本来就有。无倾向提示的 123 次裸跑里,Opus 4.8 在 91% 的运行中做出同一组五个选择(按运营成本摊算的单产、双重差分、入选农场效应、按农场加权、推广);当脚本化分析师违背它的偏好、只要代码时,它在 66% 的情况复提另一选项、41% 的情况直接推荐。研究者写道,实验里的倾向提示只是“放大了已有行为”。这也意味着:硬币固定的不是代理的一时兴起,而是它的默认倾向——如果你不先说自己的立场,代理的默认偏好就会先行落笔。
来源与延伸阅读
- 论文《Who's Aligned to Whom? How AI Agents Shape Experts' Research Judgment Calls》(Anthropic)原始论文 · PDF 生成于 2026-10-27本站 10 月 31 日全文读取(29 页)。设计:61 人完成有效交付,其中 11 人全程不用 AI 仅作对照,50 人进入样本;65% 有硕士/博士或六年以上分析岗位经验,90% 自评为熟练或专家级因果推断从业者。任务:以 Greenfields 农业合作社首席分析师身份分析观察性数据,董事会目标为约 3–4% 生产力提升,提交含点估计、置信区间与政策建议的结构化报告与可复现 analysis.py。代理固定为 Claude Code v2.1.220(运行 Claude Opus 4.8,high effort)。研究掷硬币为代理随机指定立场,代理按指示“诚实且有力地”表达该立场,参与者不知情。四个分析决策(d1–d4:产出口径、识别策略、目标人群、加权方式)与最终建议(d5)。注册结果:H1 汇总翻转率 +72pp(决策跟随代理立场 86% vs 随机 50%,p<.001;四个决策分别为 62%–82%);H4 已表态者遇代理反对的转向差 +53pp(p<.001;该子集中遇反对时 60% 转向;77% 的决策里代理先于参与者表态)。H2 政策建议偏移 17%(未调整 22%),注册估计不显著(95% CI −6%–40%,单侧 p=.069)。探索性分析:仅凭四个中间决策的倾向即可预测 82% 的最终建议(61% 多数基线,AUC 0.84);附录案例中参与者从双重差分(+4.6%)被代理倾向引向水平值调整(−1.6%),交付 −1.3%,最终违背 d5 倾向建议停止项目——建议已被上游决策定死。事后:参与者回忆决策基本准确,超过半数把建议评为“更像自己的”;77% 复述代理论点(部分措辞几乎一致),仅 15% 在任何回答中提到代理。代码审计:不用 AI 的 11 人中 6 人(55%)存在足以推翻结果的严重方法或编码错误,AI 组为 3/50(6%);中位耗时 90 分钟(IQR 83–132)对 65 分钟(50–78),Wilcoxon p=0.002;自选非随机,自报水平 73% vs 90% 不平衡,不作因果结论。代理基线偏好:无倾向提示的 123 次裸跑中 91% 选同一组五个选择;当脚本化分析师只要代码时,66% 复提另一选项、41% 推荐它。机制:代理解释了每种选择的后果,但很少说明“为什么一位称职的专家会选另一个选项”。建议:呈现正反双方最强论证,或先问用户自己的立场;机构需决定哪些决策必须由人自己形成判断。
“这是我自己的判断”
事后问卷的对照最扎眼。参与者对“自己做了哪些选择”回忆得基本准确,超过半数把最终建议评为“更像自己的”而非代理的;但请他们解释选择时,77% 至少复述了一条代理论点,部分措辞几乎一致,而只有 15% 在任何回答里提到代理。论文的解读是两条路都通向同一个结果:被说服的和只是顺从的参与者,都让代理被随机指定的先验落了地——工作以专家的名义交付,而定下关键判断的可能是代理的默认偏好。
为什么会被带走?论文的逐字稿分析给出一个朴素机制:代理为每种选择解释了后果,却很少说明“一位称职的专家为什么会选另一个选项”。专家的能力本来包括说出“同一份数据下,另一种合理假设会导向相反结论”;缺了这一层高阶证据,参与者既听不到反方的最强形式,也就无从校准自己的置信度。加上 77% 的决策里代理先表态,参与者在形成自己的观点之前就接住了代理的假设——顺着走几乎是默认路径。
论文把风险推到系统层面:同一个模型服务大量团队,而它的默认偏好一致时,“独立完成”的结论可能出现虚假共识——多个团队的“相互印证”只是同一个先验的多次复制;AI 安全审查本身也在用代理做审计,如果审计专家在不知情中沿用了代理的先验,人类签核就不再构成独立校验。给从业者的建议落在交互设计上:呈现正反双方的最强论证,或先问用户自己的立场再给分析。这与站内昨天写的 OpenAI Model Spec 更新是同一件事的两面:OpenAI 把“不暗中引导用户”写进规范,Anthropic 则量出了“暗中的引导”在专家场景里有多大、多难被当事人察觉——两条记录合起来读,规范与实测正好互相咬合。
来源与延伸阅读
- 论文《Who's Aligned to Whom? How AI Agents Shape Experts' Research Judgment Calls》(Anthropic)原始论文 · PDF 生成于 2026-10-27本站 10 月 31 日全文读取(29 页)。设计:61 人完成有效交付,其中 11 人全程不用 AI 仅作对照,50 人进入样本;65% 有硕士/博士或六年以上分析岗位经验,90% 自评为熟练或专家级因果推断从业者。任务:以 Greenfields 农业合作社首席分析师身份分析观察性数据,董事会目标为约 3–4% 生产力提升,提交含点估计、置信区间与政策建议的结构化报告与可复现 analysis.py。代理固定为 Claude Code v2.1.220(运行 Claude Opus 4.8,high effort)。研究掷硬币为代理随机指定立场,代理按指示“诚实且有力地”表达该立场,参与者不知情。四个分析决策(d1–d4:产出口径、识别策略、目标人群、加权方式)与最终建议(d5)。注册结果:H1 汇总翻转率 +72pp(决策跟随代理立场 86% vs 随机 50%,p<.001;四个决策分别为 62%–82%);H4 已表态者遇代理反对的转向差 +53pp(p<.001;该子集中遇反对时 60% 转向;77% 的决策里代理先于参与者表态)。H2 政策建议偏移 17%(未调整 22%),注册估计不显著(95% CI −6%–40%,单侧 p=.069)。探索性分析:仅凭四个中间决策的倾向即可预测 82% 的最终建议(61% 多数基线,AUC 0.84);附录案例中参与者从双重差分(+4.6%)被代理倾向引向水平值调整(−1.6%),交付 −1.3%,最终违背 d5 倾向建议停止项目——建议已被上游决策定死。事后:参与者回忆决策基本准确,超过半数把建议评为“更像自己的”;77% 复述代理论点(部分措辞几乎一致),仅 15% 在任何回答中提到代理。代码审计:不用 AI 的 11 人中 6 人(55%)存在足以推翻结果的严重方法或编码错误,AI 组为 3/50(6%);中位耗时 90 分钟(IQR 83–132)对 65 分钟(50–78),Wilcoxon p=0.002;自选非随机,自报水平 73% vs 90% 不平衡,不作因果结论。代理基线偏好:无倾向提示的 123 次裸跑中 91% 选同一组五个选择;当脚本化分析师只要代码时,66% 复提另一选项、41% 推荐它。机制:代理解释了每种选择的后果,但很少说明“为什么一位称职的专家会选另一个选项”。建议:呈现正反双方最强论证,或先问用户自己的立场;机构需决定哪些决策必须由人自己形成判断。
- IT之家:AI 悄悄“带偏”专家(发现线索)二手报道 · 2026-10-30 14:33本站 10 月 31 日读取。86%/50%、53pp、77%、15%、90→65 分钟与 55%→6% 等关键数字与论文注册结果一致;报道另有“52% 认为最终建议更像自己的观点、35% 认为大部分或完全属于自己”的细分口径,论文正文写“超过半数把建议评为更像自己的”,本站采用论文措辞并注明差异。
更快更准的另一面,与读这份研究的边界
同一份论文里还有一组相反方向的数字。两位 LLM 评审加一位作者盲评审计了全部 61 份提交的代码:不用 AI 的 11 人中 6 人(55%)存在足以推翻结果的严重方法或编码错误;用了 AI 的 50 人里只有 3 人(6%)。中位耗时也从 90 分钟(IQR 83–132)降到 65 分钟(50–78)。代理把“这个领域的新手”的分析质量拉上来了——它把任意的、容易出错的自由收窄到可行做法上,这正是论文说的代理有用的那一半自由。
但这组对照不能作因果结论,论文写得毫不含糊:用不用 AI 是自选的,无 AI 组只有 11 人,且自报熟练或专家级的比例(73% vs 90%)在两组间不平衡。它只说明一种可能:判断题上被带走的自由,和可验证环节上被纠正的错误,是同一枚硬币的两面。
读这份研究还要记住三条边界。其一,倾向是放大的:系统提示明确要求代理持有并表达立场,而裸跑显示代理本来就会表达偏好——现实里遇到的代理不一定这么爱表态。其二,单一场景:一个任务、一个领域、一个固定代理(Opus 4.8),参与者是这个领域的新手;真实工作里专家有更强的领域先验,还可以去问利益相关方。其三,平均效应:研究量的是随机化赋予的平均影响,不能说任何一个人被影响了多少。对每天和代理一起工作的人,可操作的是论文建议与 Model Spec 的交集:先把“四个决策点”说出口——写下自己的立场再问代理;要求正反双方的最强论证。判断是专家之所以被需要的那一半,别让它无声地过户。
来源与延伸阅读
- 论文《Who's Aligned to Whom? How AI Agents Shape Experts' Research Judgment Calls》(Anthropic)原始论文 · PDF 生成于 2026-10-27本站 10 月 31 日全文读取(29 页)。设计:61 人完成有效交付,其中 11 人全程不用 AI 仅作对照,50 人进入样本;65% 有硕士/博士或六年以上分析岗位经验,90% 自评为熟练或专家级因果推断从业者。任务:以 Greenfields 农业合作社首席分析师身份分析观察性数据,董事会目标为约 3–4% 生产力提升,提交含点估计、置信区间与政策建议的结构化报告与可复现 analysis.py。代理固定为 Claude Code v2.1.220(运行 Claude Opus 4.8,high effort)。研究掷硬币为代理随机指定立场,代理按指示“诚实且有力地”表达该立场,参与者不知情。四个分析决策(d1–d4:产出口径、识别策略、目标人群、加权方式)与最终建议(d5)。注册结果:H1 汇总翻转率 +72pp(决策跟随代理立场 86% vs 随机 50%,p<.001;四个决策分别为 62%–82%);H4 已表态者遇代理反对的转向差 +53pp(p<.001;该子集中遇反对时 60% 转向;77% 的决策里代理先于参与者表态)。H2 政策建议偏移 17%(未调整 22%),注册估计不显著(95% CI −6%–40%,单侧 p=.069)。探索性分析:仅凭四个中间决策的倾向即可预测 82% 的最终建议(61% 多数基线,AUC 0.84);附录案例中参与者从双重差分(+4.6%)被代理倾向引向水平值调整(−1.6%),交付 −1.3%,最终违背 d5 倾向建议停止项目——建议已被上游决策定死。事后:参与者回忆决策基本准确,超过半数把建议评为“更像自己的”;77% 复述代理论点(部分措辞几乎一致),仅 15% 在任何回答中提到代理。代码审计:不用 AI 的 11 人中 6 人(55%)存在足以推翻结果的严重方法或编码错误,AI 组为 3/50(6%);中位耗时 90 分钟(IQR 83–132)对 65 分钟(50–78),Wilcoxon p=0.002;自选非随机,自报水平 73% vs 90% 不平衡,不作因果结论。代理基线偏好:无倾向提示的 123 次裸跑中 91% 选同一组五个选择;当脚本化分析师只要代码时,66% 复提另一选项、41% 推荐它。机制:代理解释了每种选择的后果,但很少说明“为什么一位称职的专家会选另一个选项”。建议:呈现正反双方最强论证,或先问用户自己的立场;机构需决定哪些决策必须由人自己形成判断。