模型与创作 · 持续学习
模型也要睡觉:谷歌把巩固与做梦接进部署后的持续学习
部署后的模型有两个老问题:知识停在训练截止日,学了新任务又容易忘掉旧任务。谷歌研究团队 10 月 27 日的“睡眠框架”给出一条处理路径:模型在清醒/睡眠两阶段间循环,清醒时把经历存进短期记忆,睡眠时先“巩固”——新知识写进新增的低秩专家并向上蒸馏——再“做梦”,自造合成课程自我改进。在 Qwen3-8B 上,睡眠阶段把 AIME-24 从 73.8 提到 79.2;在未见语言的持续翻译上近乎零退化。但这不是已发布的产品模型:骨架是研究架构 Hope,对照实验用了 Qwen3 与 Llama 底座,数字为厂商口径,本站未复现。
本文依据谷歌研究博客《The sleep framework》(2026-10-27,署名 Ali Behrouz 与 Vahab Mirrokni,本站 11 月 1 日读取全文)与论文《Language Models Need Sleep: Learning to Self-Modify and Consolidate Memories》(arXiv 2606.03979,v1 2026-06-02、v2 2026-07-10;OpenReview 自 2025 年 9 月起有公开版本,作者来自 Google、Cornell 与 USC)写成;正文引用的表格数字逐一取自论文 HTML 的原始表格。博客与论文均为厂商口径,本站未运行任何实验;论文正文与表格未给出完整训练成本口径(数学实验使用 LoRA rank 64 的参数高效训练),附录另有效率小节,本站未逐项核对。封面与两张正文图为官方博客原图(英文原图未译,符合本站中英双语约定)。
部署后的模型还能继续学吗
部署后的模型有两个长期问题:知识停在训练截止日,训练之后世界发生的事进不了参数;而为了让模型学会新东西再做微调,又容易把旧能力磨掉——灾难性遗忘。放进上下文里的知识不写进参数,会话结束就清空;今天的上下文窗口再大,也大不过“一直在用、一直在学”的参数记忆。10 月 27 日,谷歌研究团队的博客《The sleep framework》给出一条处理路径,配套论文《Language Models Need Sleep: Learning to Self-Modify and Consolidate Memories》(arXiv 2606.03979,2025 年 9 月起在 OpenReview 有公开版本)——一个让部署后的模型继续学习的框架,取名自生物睡眠:模型在清醒与睡眠两阶段间循环。清醒阶段照常处理输入,把经历存进短期记忆;睡眠阶段暂停新输入,离线完成两件事:巩固与做梦。整套机制在固定架构与人工定义的训练规则内运行,不改变模型的基本结构。
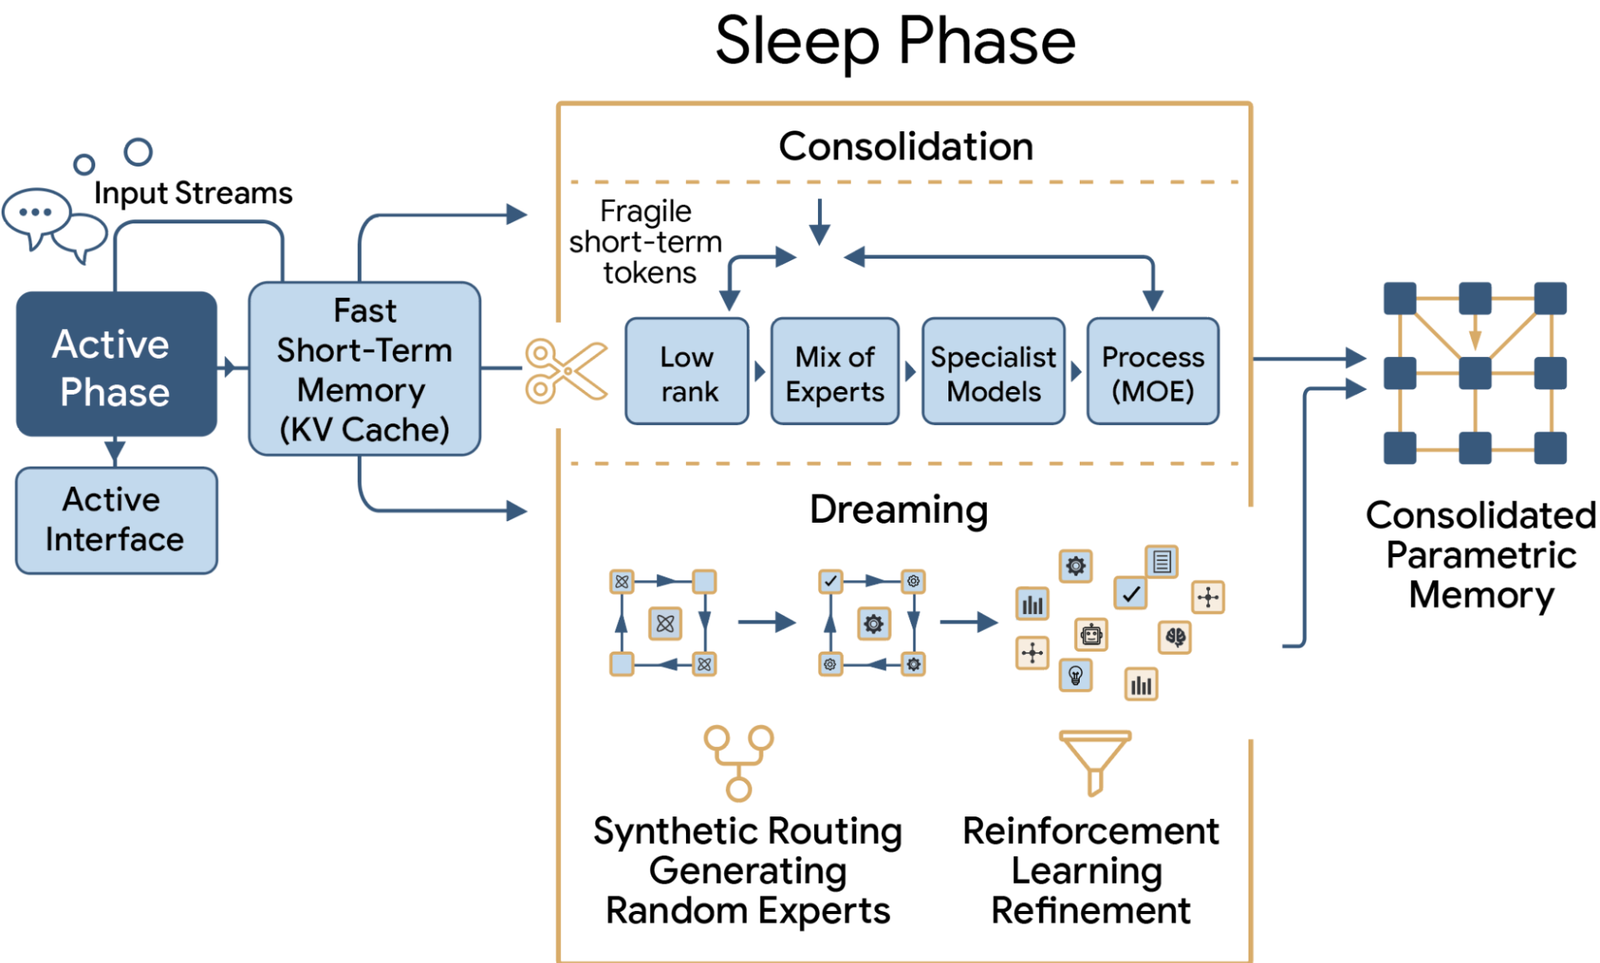
框架图(官方原图)把这轮循环画得很直白:清醒阶段,输入流经主动界面写进“快速短期记忆”(KV 缓存);进入睡眠,短期记忆里的脆弱标记先经巩固——低秩、专家混合、专家模型到 MoE 处理——写进“巩固后的参数记忆”;做梦在巩固之后,用合成路由与强化学习再改进一轮;一轮结束,短期记忆被修剪清空,等下一轮清醒。这回答的正是站内记忆比较文留下的那道题:检索、写入与蒸馏各有取舍,而这里把“写进参数”这一步做成了可持续的循环。
来源与延伸阅读
- 谷歌研究博客:The sleep framework(官方博文)官方博文 · 2026-10-27 · 本站 2026-11-01 全文读取署名 Ali Behrouz 与 Vahab Mirrokni(Google Research)。框架让模型在清醒/睡眠两阶段间循环:清醒阶段处理输入并存入短期记忆,睡眠阶段暂停新输入、离线完成巩固与做梦,全部在官方写明的“固定架构与人工定义的训练规则内运行”。记忆巩固借 MoE 与 Hope 架构:新解锁的低秩专家放进低频记忆块,不扰动旧参数;向上蒸馏用 GKD 实现——on-policy 蒸馏+Learning to Imitate(按语义与 Levenshtein 相似度给奖励);巩固后突触修剪释放容量。做梦分三步:随机专家选择(路由随机激活非标准专家混合知识域)、梯度法选样筛选的合成样本排练、强化学习精炼。理论部分把巩固描述为“结构化低秩压缩”,把做梦描述为改善“学习的几何”。数字:未见语言持续翻译近零退化;BABILong“近乎完美扩展到 10M token,超过 GPT-4 与 Titans”;SQuAD 48.9%/CPT 46.2%;AIME 24/25 与 HMMT 25 为 79.2%/69.0%/46.1%,超过 SFT、GRPO 与 OPSD。
- 论文:Language Models Need Sleep(arXiv 2606.03979)原始论文 · v1 2026-06-02,v2 2026-07-10 · 本站 2026-11-01 读取 HTML 版并逐表核对作者 Ali Behrouz、Farnoosh Hashemi、Adel Javanmard、Vahab Mirrokni(Google†、Cornell‡);OpenReview 自 2025-09 起有公开版本。骨架是 Hope 架构(Nested Learning 下的 Continuum Memory System);对照实验底座:类增量学习用 Llama-3B/8B,数学用 Qwen3-1.7B/8B,小样本 ARC 用 Llama-3.2-1B,知识注入用带两级/四级记忆的 Transformer。数学(avg@16,AIME-24/AIME-25/HMMT-25):Qwen3-1.7B 基座 49.8/34.5/25.7 → Sleep 53.2/40.2/29.3;Qwen3-8B 基座 73.8/68.1/42.4 → SFT 75.5/66.4/43.7 → GRPO 76.4/68.1/44.9 → OPSD 76.6/67.4/45.1 → Sleep 79.2/69.0/46.1;消融:去模仿学习 76.8/67.9/45.0、去语义奖励 78.9/69.2/44.5、去参数扩展 78.2/67.9/44.9。知识注入(SQuAD 无上下文,n=1 单段 / n=200 连续预训练):Base 31.9/31.9 → 不做梦微调 33.4/32.0 → SEAL 46.7/43.2 → Sleep(Transformer)48.1/44.3 → Sleep(+四级记忆)48.9/46.2;消融:去梯度选样 47.1/45.2、去随机专家 48.0/44.7、去做梦 35.7/36.2。小样本 ARC 成功率:ICL 0%、TTT 10%、SEAL 72.5%、Sleep 80%。数学实验配置:LoRA r=64/α=128、学习率 5e-6、Sleep 100 步。论文正文与表格未给出完整训练成本口径。
巩固:短记忆怎么变成长期知识
记忆巩固依托混合专家(MoE)与 Hope 架构——谷歌在 Nested Learning 范式下提出的持续学习架构。做法是:清醒阶段结束时,把新解锁的低秩专家放进低频、稳定的“记忆块”,旧参数不动——新知识住新房间,不翻修旧房间。这一步决定了一件事:学新知识不需要重训整个模型,参数的增量以“新增专家”的形式进入。
怎么把短期记忆的内容写进这些新专家?论文给出的答案是“向上蒸馏”(Knowledge Seeding):小模型把记忆蒸馏给大模型——同一模型的小版本(更少激活参数)充当教师,大版本充当学生。实现为广义知识蒸馏(GKD):一边是 on-policy 蒸馏,学生在自采样序列上向教师分布学习;一边是 Learning to Imitate,学生补全教师文本的前缀,奖励由冻结奖励模型的语义相似度与 Levenshtein 距离的绝对相似度混合给出。整个过程只更新新增参数,旧参数冻结。
巩固结束并不等于这一轮结束:发件块(清醒阶段的高速短期记忆块)里用过的低秩专家被重置——论文写作“a similar procedure of synaptic pruning in human brain”,类似人脑的突触修剪,腾出容量迎接下一轮。博客的理论部分把巩固描述为“结构化低秩压缩”:模型挑出能保持自身行为与语义奖励内容的紧凑方向。对读者来说,这段理论的意思是:不是把经历原样备份进参数,而是压缩成模型自己能复用的形式。巩固负责把经历存下来,做梦负责把能力变强——睡眠阶段的另一半。
来源与延伸阅读
- 谷歌研究博客:The sleep framework(官方博文)官方博文 · 2026-10-27 · 本站 2026-11-01 全文读取署名 Ali Behrouz 与 Vahab Mirrokni(Google Research)。框架让模型在清醒/睡眠两阶段间循环:清醒阶段处理输入并存入短期记忆,睡眠阶段暂停新输入、离线完成巩固与做梦,全部在官方写明的“固定架构与人工定义的训练规则内运行”。记忆巩固借 MoE 与 Hope 架构:新解锁的低秩专家放进低频记忆块,不扰动旧参数;向上蒸馏用 GKD 实现——on-policy 蒸馏+Learning to Imitate(按语义与 Levenshtein 相似度给奖励);巩固后突触修剪释放容量。做梦分三步:随机专家选择(路由随机激活非标准专家混合知识域)、梯度法选样筛选的合成样本排练、强化学习精炼。理论部分把巩固描述为“结构化低秩压缩”,把做梦描述为改善“学习的几何”。数字:未见语言持续翻译近零退化;BABILong“近乎完美扩展到 10M token,超过 GPT-4 与 Titans”;SQuAD 48.9%/CPT 46.2%;AIME 24/25 与 HMMT 25 为 79.2%/69.0%/46.1%,超过 SFT、GRPO 与 OPSD。
- 论文:Language Models Need Sleep(arXiv 2606.03979)原始论文 · v1 2026-06-02,v2 2026-07-10 · 本站 2026-11-01 读取 HTML 版并逐表核对作者 Ali Behrouz、Farnoosh Hashemi、Adel Javanmard、Vahab Mirrokni(Google†、Cornell‡);OpenReview 自 2025-09 起有公开版本。骨架是 Hope 架构(Nested Learning 下的 Continuum Memory System);对照实验底座:类增量学习用 Llama-3B/8B,数学用 Qwen3-1.7B/8B,小样本 ARC 用 Llama-3.2-1B,知识注入用带两级/四级记忆的 Transformer。数学(avg@16,AIME-24/AIME-25/HMMT-25):Qwen3-1.7B 基座 49.8/34.5/25.7 → Sleep 53.2/40.2/29.3;Qwen3-8B 基座 73.8/68.1/42.4 → SFT 75.5/66.4/43.7 → GRPO 76.4/68.1/44.9 → OPSD 76.6/67.4/45.1 → Sleep 79.2/69.0/46.1;消融:去模仿学习 76.8/67.9/45.0、去语义奖励 78.9/69.2/44.5、去参数扩展 78.2/67.9/44.9。知识注入(SQuAD 无上下文,n=1 单段 / n=200 连续预训练):Base 31.9/31.9 → 不做梦微调 33.4/32.0 → SEAL 46.7/43.2 → Sleep(Transformer)48.1/44.3 → Sleep(+四级记忆)48.9/46.2;消融:去梯度选样 47.1/45.2、去随机专家 48.0/44.7、去做梦 35.7/36.2。小样本 ARC 成功率:ICL 0%、TTT 10%、SEAL 72.5%、Sleep 80%。数学实验配置:LoRA r=64/α=128、学习率 5e-6、Sleep 100 步。论文正文与表格未给出完整训练成本口径。
做梦:模型自己出题自己改
做梦阶段分三步。第一步,随机专家选择:MoE 路由随机激活非标准专家,混合不同知识域,暴露潜在模式——相当于强制模型换一组“同事”来想问题。第二步,策划排练:模型自己生成合成样本(“梦”),再用梯度法选样筛选,留下最有学习价值的样本。第三步,强化学习精炼:在最好的梦样本上做强化学习微调,按下游任务评估效果。三步合起来,做梦不是被动巩固,而是主动改进——模型给自己出题,再自己改卷。
博客的理论部分给做梦的收益一个解释:它改善“学习的几何”——拓宽探索的梯度方向,得到更平衡的优化景观与条件数更好的梯度。把这层理论翻译成日常语言:巩固解决“记住”,做梦解决“学通”。一个只做巩固的模型像只做笔记的学生,记住的是条目;加了做梦,模型在自造的课程里把新知识与其他知识域交叉练习,把条目变成方法。
做梦不是装饰,消融数字直接说明了这一点:在知识注入任务上(SQuAD n=1 / 连续预训练 n=200),完整睡眠框架拿到 48.9/46.2,去掉做梦阶段掉到 35.7/36.2——几乎回到基底模型的 31.9/31.9;去掉梯度选样为 47.1/45.2,去掉随机专家为 48.0/44.7。做梦阶段贡献了从“基底模型”到“睡眠框架”的大部分增量,随机专家与梯度选样各占其中一部分。这意味着论文里反复出现的“自造课程”不是修辞,而是效果的来源。
来源与延伸阅读
- 谷歌研究博客:The sleep framework(官方博文)官方博文 · 2026-10-27 · 本站 2026-11-01 全文读取署名 Ali Behrouz 与 Vahab Mirrokni(Google Research)。框架让模型在清醒/睡眠两阶段间循环:清醒阶段处理输入并存入短期记忆,睡眠阶段暂停新输入、离线完成巩固与做梦,全部在官方写明的“固定架构与人工定义的训练规则内运行”。记忆巩固借 MoE 与 Hope 架构:新解锁的低秩专家放进低频记忆块,不扰动旧参数;向上蒸馏用 GKD 实现——on-policy 蒸馏+Learning to Imitate(按语义与 Levenshtein 相似度给奖励);巩固后突触修剪释放容量。做梦分三步:随机专家选择(路由随机激活非标准专家混合知识域)、梯度法选样筛选的合成样本排练、强化学习精炼。理论部分把巩固描述为“结构化低秩压缩”,把做梦描述为改善“学习的几何”。数字:未见语言持续翻译近零退化;BABILong“近乎完美扩展到 10M token,超过 GPT-4 与 Titans”;SQuAD 48.9%/CPT 46.2%;AIME 24/25 与 HMMT 25 为 79.2%/69.0%/46.1%,超过 SFT、GRPO 与 OPSD。
- 论文:Language Models Need Sleep(arXiv 2606.03979)原始论文 · v1 2026-06-02,v2 2026-07-10 · 本站 2026-11-01 读取 HTML 版并逐表核对作者 Ali Behrouz、Farnoosh Hashemi、Adel Javanmard、Vahab Mirrokni(Google†、Cornell‡);OpenReview 自 2025-09 起有公开版本。骨架是 Hope 架构(Nested Learning 下的 Continuum Memory System);对照实验底座:类增量学习用 Llama-3B/8B,数学用 Qwen3-1.7B/8B,小样本 ARC 用 Llama-3.2-1B,知识注入用带两级/四级记忆的 Transformer。数学(avg@16,AIME-24/AIME-25/HMMT-25):Qwen3-1.7B 基座 49.8/34.5/25.7 → Sleep 53.2/40.2/29.3;Qwen3-8B 基座 73.8/68.1/42.4 → SFT 75.5/66.4/43.7 → GRPO 76.4/68.1/44.9 → OPSD 76.6/67.4/45.1 → Sleep 79.2/69.0/46.1;消融:去模仿学习 76.8/67.9/45.0、去语义奖励 78.9/69.2/44.5、去参数扩展 78.2/67.9/44.9。知识注入(SQuAD 无上下文,n=1 单段 / n=200 连续预训练):Base 31.9/31.9 → 不做梦微调 33.4/32.0 → SEAL 46.7/43.2 → Sleep(Transformer)48.1/44.3 → Sleep(+四级记忆)48.9/46.2;消融:去梯度选样 47.1/45.2、去随机专家 48.0/44.7、去做梦 35.7/36.2。小样本 ARC 成功率:ICL 0%、TTT 10%、SEAL 72.5%、Sleep 80%。数学实验配置:LoRA r=64/α=128、学习率 5e-6、Sleep 100 步。论文正文与表格未给出完整训练成本口径。
数字与边界:研究框架,不是已发布的产品模型
数学推理(Qwen3-8B 底座,avg@16,AIME-24/AIME-25/HMMT-25):基底 73.8/68.1/42.4 → SFT 75.5/66.4/43.7 → GRPO 76.4/68.1/44.9 → OPSD 76.6/67.4/45.1 → Sleep 79.2/69.0/46.1——AIME-24 +5.4、AIME-25 +0.9、HMMT-25 +3.7,超过两个强对照。小一档的 Qwen3-1.7B 从 49.8/34.5/25.7 提到 53.2/40.2/29.3,AIME-25 上 +5.7 分,说明收益在小模型上同样成立。博客引用的 79.2/69.0/46.1 就是 Qwen3-8B 的 Sleep 行。
知识注入(SQuAD 无上下文,n=1 单段 / n=200 连续预训练):基底 31.9/31.9 → 不做梦的微调 33.4/32.0 → SEAL 46.7/43.2 → Sleep(Transformer)48.1/44.3 → Sleep(+四级记忆)48.9/46.2。小样本 ARC 上:上下文学习 0%、测试时训练 10%、SEAL 72.5%、Sleep 80%。两组数字的形状一致:不做梦的微调只比基底高 1.5 分上下,SEAL(斯坦福的自改写自训练方法)已经把差距拉开,而睡眠框架再高出一截——做梦与自改写在这个任务上是同一量级的关键。
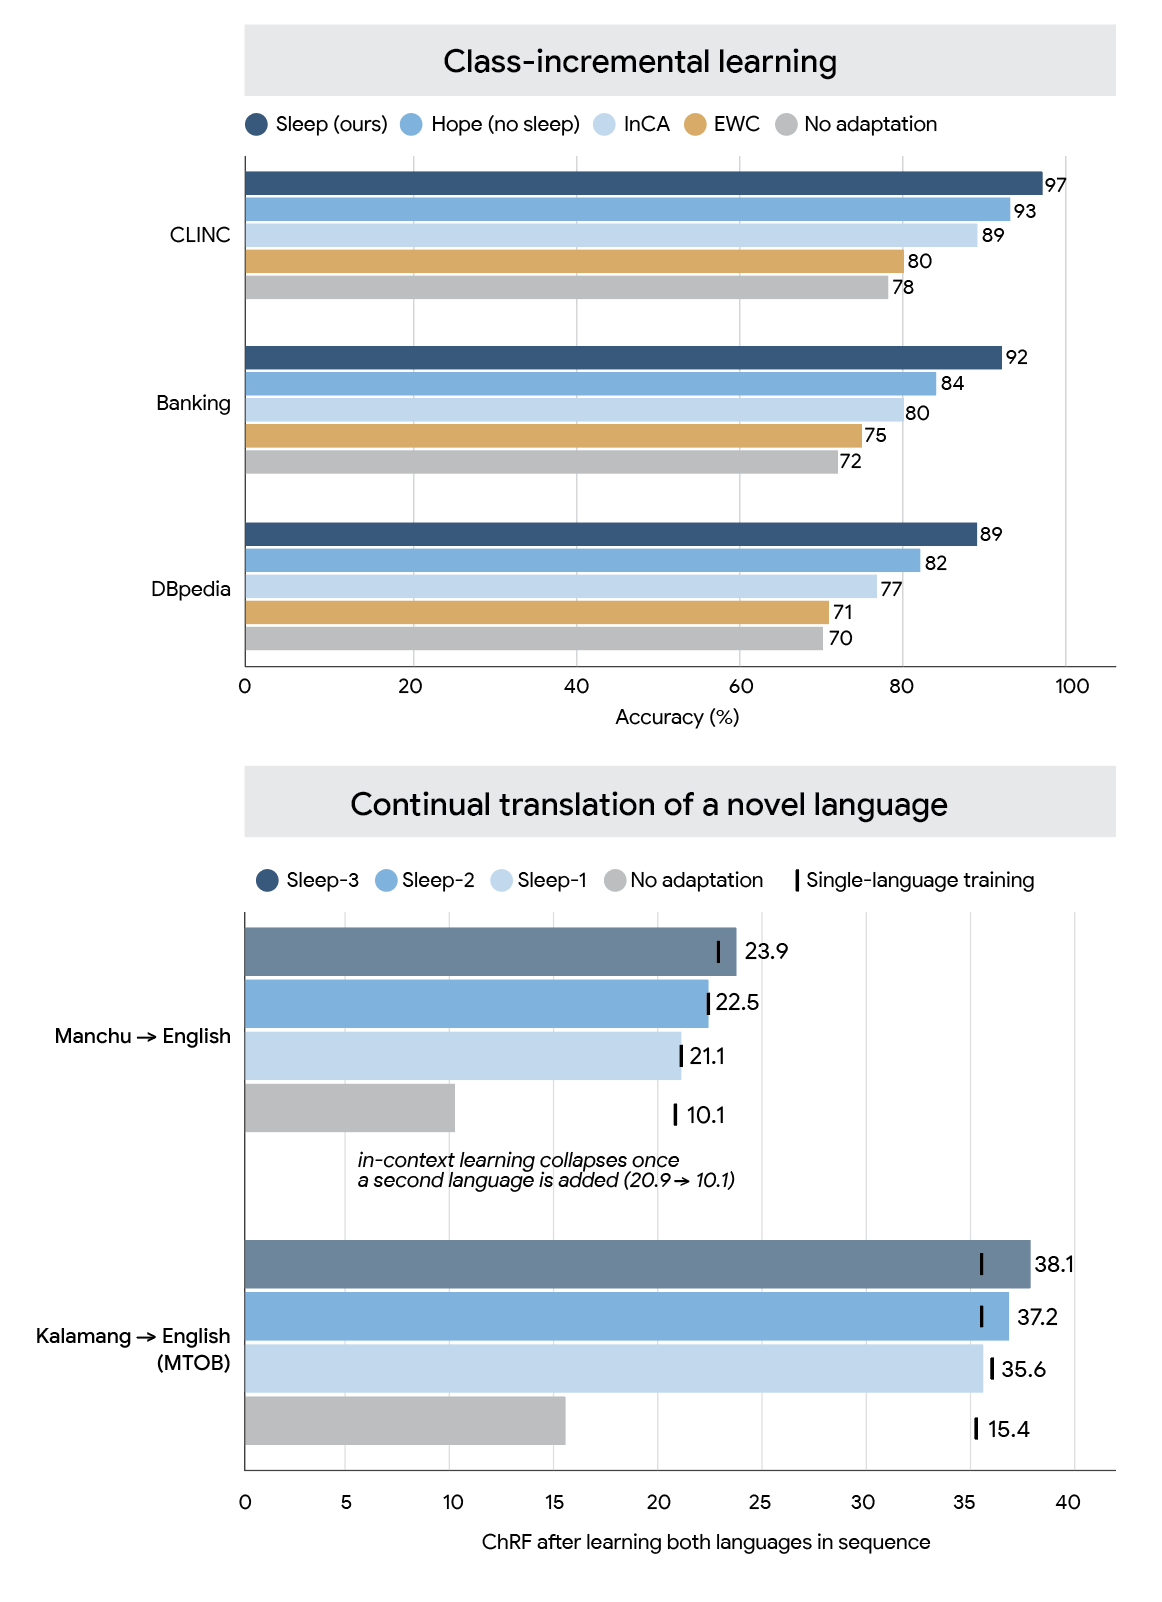
未见语言的持续翻译是这套方法最直观的展示(官方结果图下幅):满语→英语上,不做适应的上下文学习基线在学完第二种语言后从 20.9 崩到 10.1;睡眠阶段逐级把成绩从 21.1(Sleep-1)推到 22.5(Sleep-2)再到 23.9(Sleep-3),逼近单语言训练的参考线。卡尔曼语(MTOB)从 35.6 推到 38.1,无适应基线只有 15.4。类增量学习(Llama 底座)同向:CLINC 上 Sleep 97 领先无睡眠版 Hope 的 93,Banking 92 对 84,DBpedia 89 对 82;EWC 80/75/71、无适应 78/72/70 更低。BABILong 长上下文博客称“近乎完美扩展到 10M token,超过 GPT-4 与 Titans 等强基线”——该数字细节在论文附录,本站未逐项核对,按厂商口径引用。
读这份材料要保留的边界:这是研究框架不是已发布的产品模型——骨架是谷歌自己的 Hope 架构,对照实验用 Qwen3-1.7B/8B、Llama-3B/8B 与 Llama-3.2-1B 等底座,数学实验用 LoRA(rank 64)参数高效训练;所有数字均为厂商口径(本站逐一取自论文 HTML 表格与官方博客),未复现任何实验;论文正文与表格未给出完整训练成本口径。博客也写明虽然借用了神经科学名词,但都是标准机器学习——读者不应把“睡眠/做梦”读成生物机制复现。它接回站内两条已有内容:10 月 21 日的记忆比较文(检索、写入与蒸馏各有取舍)给出了当时已有方案的水平线,睡眠框架把“写进参数”做成可持续循环;个人 AI 伙伴专题的 Muse 章讲记忆管理,sleep framework 是训练侧的另一半答案;与 10 月 31 日的专家跟随实验文同属“部署后的系统怎样自我塑造”研究主线。
来源与延伸阅读
- 谷歌研究博客:The sleep framework(官方博文)官方博文 · 2026-10-27 · 本站 2026-11-01 全文读取署名 Ali Behrouz 与 Vahab Mirrokni(Google Research)。框架让模型在清醒/睡眠两阶段间循环:清醒阶段处理输入并存入短期记忆,睡眠阶段暂停新输入、离线完成巩固与做梦,全部在官方写明的“固定架构与人工定义的训练规则内运行”。记忆巩固借 MoE 与 Hope 架构:新解锁的低秩专家放进低频记忆块,不扰动旧参数;向上蒸馏用 GKD 实现——on-policy 蒸馏+Learning to Imitate(按语义与 Levenshtein 相似度给奖励);巩固后突触修剪释放容量。做梦分三步:随机专家选择(路由随机激活非标准专家混合知识域)、梯度法选样筛选的合成样本排练、强化学习精炼。理论部分把巩固描述为“结构化低秩压缩”,把做梦描述为改善“学习的几何”。数字:未见语言持续翻译近零退化;BABILong“近乎完美扩展到 10M token,超过 GPT-4 与 Titans”;SQuAD 48.9%/CPT 46.2%;AIME 24/25 与 HMMT 25 为 79.2%/69.0%/46.1%,超过 SFT、GRPO 与 OPSD。
- 论文:Language Models Need Sleep(arXiv 2606.03979)原始论文 · v1 2026-06-02,v2 2026-07-10 · 本站 2026-11-01 读取 HTML 版并逐表核对作者 Ali Behrouz、Farnoosh Hashemi、Adel Javanmard、Vahab Mirrokni(Google†、Cornell‡);OpenReview 自 2025-09 起有公开版本。骨架是 Hope 架构(Nested Learning 下的 Continuum Memory System);对照实验底座:类增量学习用 Llama-3B/8B,数学用 Qwen3-1.7B/8B,小样本 ARC 用 Llama-3.2-1B,知识注入用带两级/四级记忆的 Transformer。数学(avg@16,AIME-24/AIME-25/HMMT-25):Qwen3-1.7B 基座 49.8/34.5/25.7 → Sleep 53.2/40.2/29.3;Qwen3-8B 基座 73.8/68.1/42.4 → SFT 75.5/66.4/43.7 → GRPO 76.4/68.1/44.9 → OPSD 76.6/67.4/45.1 → Sleep 79.2/69.0/46.1;消融:去模仿学习 76.8/67.9/45.0、去语义奖励 78.9/69.2/44.5、去参数扩展 78.2/67.9/44.9。知识注入(SQuAD 无上下文,n=1 单段 / n=200 连续预训练):Base 31.9/31.9 → 不做梦微调 33.4/32.0 → SEAL 46.7/43.2 → Sleep(Transformer)48.1/44.3 → Sleep(+四级记忆)48.9/46.2;消融:去梯度选样 47.1/45.2、去随机专家 48.0/44.7、去做梦 35.7/36.2。小样本 ARC 成功率:ICL 0%、TTT 10%、SEAL 72.5%、Sleep 80%。数学实验配置:LoRA r=64/α=128、学习率 5e-6、Sleep 100 步。论文正文与表格未给出完整训练成本口径。