模型与创作 · 权重的另一种写法
没人训练的权重,跑通了一台红白机
一位开发者把红白机(NES)的 6502 CPU、2KB 工作内存和整张卡带程序 ROM 编译进 7 层 DeltaNet 权重:没有一个参数经过训练,模型逐 token“预测”CPU 执行日志,马里奥就跑起来了。本站读原仓 README 与测试记录、Qwenputer 原博客与 HN 讨论,讲清它为什么能帧帧对齐真模拟器、为什么慢 150–290 倍,以及“编译出来的权重”与“训练出来的权重”分别意味着什么。
本文依据 nesformer 仓库 README 与测试记录(2026-10-30 上线,HN 提交 2026-10-31 00:40 北京时间;本站 10 月 31 日全文读取)、Qwenputer 作者博客(标注 2026-10-22 发布)与 HN 讨论(截至读取时 105 条评论)写成;引号内数字均为作者口径,未独立复测。本站没有下载权重、没有运行任何游戏或复测帧一致性。图 1 为编辑封面(游戏帧取自仓库公开演示);图 2 为 Qwenputer 博客原图;图 3 取自仓库公开演示动画。nesformer 检查点只是借用 Qwen3.5 架构形状的编译产物,不代表阿里训练的 Qwen3.5-4B 会打游戏;Qwen3.5-4B 本体的官方发布页本轮未取得,站内模型目录暂不设条目。
没人训练的权重:马里奥为什么动了
10 月 31 日凌晨(北京时间),“Show HN: A working Nintendo in ~1GB of Qwen weights”登上 Hacker News 首页第六位:开发者 Drew Breunig 的 nesformer 仓库把红白机(NES)的 6502 CPU(2A03 的内核)、2KB 工作内存和整张卡带程序 ROM 编译进一个 466.6M 参数的检查点。仓库一句话写明做法与性质:“没有人训练这些权重——每一个都是编译器算出来的。”模型的工作方式是逐 token“预测”CPU 的执行日志,一条小主机程序在旁边补完主机:画画面(PPU 逐扫描线渲染)、读手柄、在垂直消隐期注入 NMI 中断。随仓库的演示动画里,《超级马里奥兄弟》世界 1-1 能走、能跳、能跳过水管——按仓库记录,全部画面与真模拟器帧帧一致。
这个检查点是“借来的躯壳”:Qwen3_5ForCausalLM 格式,标准 transformers 无需自定义代码即可加载;7 层 Gated DeltaNet 电路层加 1 层全零注意力层,hidden 768、词表 263,808,头形状沿用 Qwen3.5-4B(16 键头、32 值头、维 128)。参数量 466.6M(bf16 约 933MB),其中只有 9.3M 非零——压缩后只有 3.3MB:绝大多数权重是零,因为这是一台被“画”进权重里的机器,不是学出来的。要说清楚的一点是:nesformer 不代表阿里的 Qwen3.5-4B 学会了打游戏;Qwen3.5-4B 本体的官方发布页本轮未取得,站内模型目录暂不设条目,缺口如实写明。
这东西怎么来的?作者在 HN 首评里写得很坦白:Opus 5.5 两条提示完成了“可运行的权重与代码”。第一条请它读 Qwenputer 文章与源码,评估能否用该技术模拟 NES 芯片与内存、需要多大的模型、能否逼近标准时钟——返回的图表回答“任何模型都会很慢”;第二条是“那就造吧,慢也没关系”。作者同样点出成败关键:模拟器社区多年积累的一致性测试(nestest 黄金日志,3,000 余条指令)给了一个明确验收标准;再加上 Qwenputer 的现成编译器,这是一次“参考材料完备、验收清晰”的任务,也正是 AI 辅助开发最能发挥的形状。
来源与延伸阅读
- nesformer 仓库(dbreunig/nesformer):README 与测试记录原作者仓库 · 2026-10-30 上线本站 10 月 31 日全文读取。仓库把 NES 的 6502 CPU(2A03 内核)、2KB 工作内存和卡带 PRG-ROM 装进一个 Qwen3_5ForCausalLM 检查点;权重由编译器逐个算出,无人训练。检查点共 466.6M 参数(bf16 约 933MB),其中只有 9.3M 非零,压缩后 3.3MB;7 层 Gated DeltaNet 电路层加 1 层全零注意力层,hidden 768、词表 263,808,头形状沿用 Qwen3.5-4B(16 键头、32 值头、维 128)。主机程序负责 PPU、手柄与 vblank NMI 注入,主机从不直接读寄存器或内存。验证记录:参考 CPU 对 nestest 黄金日志 3,348 条指令一致,并在 570 万条游戏代码指令上匹配 py65;电路对全部参考 token 预测一致(nestest 全程加两游戏启动序列共 283,610 个位置);检查点在标准 transformers(bf16 CPU)2,651 个位置无失配;自由运行:nestest 4,586 token 一致并以预期 HALT 结束,Thwaite check 70 万 token/271 帧一致,Thwaite run 1,916,527 token/600 帧的 300 张保存帧全部一致,Full Game run 2,645,885 token/420 帧的 210 张保存帧全部一致。默认引擎(numba,单 CPU 核)约 1,650 token/s;真 NES 需要约 70 万 token/s,整体慢 150–290 倍;空闲循环跳过省 2.6–4.2× token。限制:仅 NROM(mapper 0)卡带、仅官方操作码、代码须从卡带 ROM 执行、无 IRQ、PPU/APU 不在权重里(无声音,扫描线中间效果不复现)。
- Hacker News 讨论:Show HN “A working Nintendo in ~1GB of Qwen weights”社区讨论 · 提交于 2026-10-31 00:40 北京时间,读取时 171 分/105 评论本站 10 月 31 日读取讨论主线。作者首评写明:Opus 5.5 用两条提示完成“可运行的权重与代码”——第一条请它读 Qwenputer 文章与源码、评估用该技术模拟 NES 芯片与内存的可行性与所需模型规模(返回“任何模型都会很慢”的图表),第二条是“那就造吧,慢也没关系”;作者同时强调模拟器社区的一致性测试(nestest 黄金日志,3000 余条指令)是成败关键。讨论中另有两条对照观点:其一,效率鸿沟——150–290 倍慢于真机被读作“LLM 与普通程序算力差距”的具体提醒;其二,有人重提 2014 年 Neural Turing Machines 论文,认为这是“学会用内存”路线的旧话题,也有人反驳“精确编译 vs 学习近似”正是新意所在。以上为社区观点对照,非本站结论。
把 DeltaNet 状态当内存:编译电路的整套方法
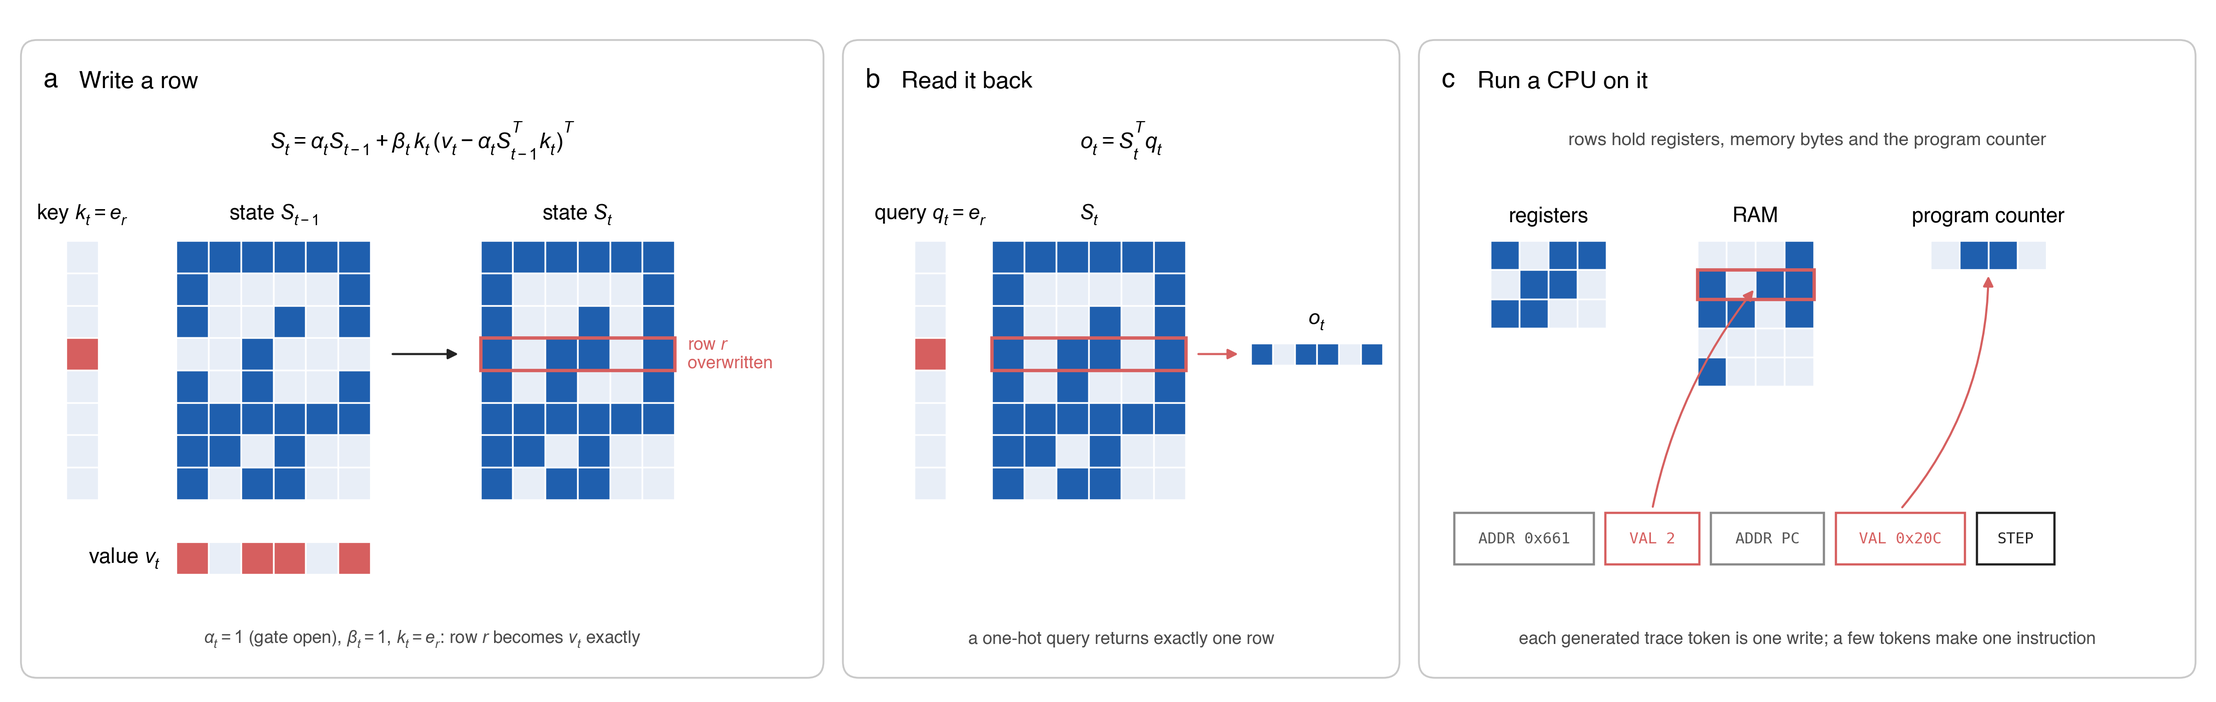
整套方法的地基是一个“把状态当内存”的技巧。Qwen3.5 这类混合架构里,每 4 层注意力中 3 层用 Gated DeltaNet——一种线性 RNN——充当注意力机制;每个头维护一个 128×128 的状态矩阵,delta 规则在每个 token 更新它。Qwenputer 的作者发现:把门控设为 1(什么都不遗忘)、写入强度 β 设为 1(完全替换而非混合)、键用 one-hot 编码(精确指向一行)之后,每次写入恰好覆盖一行,每次 one-hot 查询精确读回一行——“每一行就是一个内存单元”。卡带、寄存器、RAM 都住在这 128 行里。线性注意力与 delta 规则可作联想记忆(“快速权重”)早在 2021 年就被 Schlag 等人证明;新东西是让它在生产模型架构里做到精确可寻址,稳定到能跑整颗 CPU。
Qwenputer 先行一步(博客标注 2026-10-22 发布):作者先把 CHIP-8、再把 RV32IM RISC-V CPU(加 Zba 扩展与大数单元)编译进真的 Qwen3.5-4B——在原有权重之外增加 11 层编译层与加宽维度,原权重不动;模型借工具调用格式在内部把算术交给 CPU,无外部工具调用。数字很有说服力:NUPA 长整数算术从 48.6% 提到 100%,与挂 Python 工具同水平;DeepMind 算术集 div_big 97.5%(基座 72.5%)、mul_big 97.5%(基座 55%);1,800 万条指令自由运行无错。甚至试了实验性文件系统:DeltaNet 状态里存 512 个文件约 5.3 万 token,跨对话事实保持 90%(回贴旧对话只有 30%)。博客还预告两个安全研究方向:模型把推理藏进 RNN 状态躲避 CoT 监控,以及编译权重作“模型自己关不掉的监控工具”。
nesformer 的分工表:模型内装的是 6502 内核(151 个官方操作码、全部寻址模式、标志位、栈、BRK 与 NMI 入口)、2KB 工作内存和 32KB PRG-ROM(取指、读数各存一份);主机程序负责 PPU(逐扫描线渲染与调色板)、手柄、vblank NMI 注入,APU 寄存器只记写入不发声。主机从不直接看寄存器与内存——只能通过执行日志“旁听”。7 层电路各有分工:第 1 层锚定 PC 与寄存器/标志位,第 2 层算 PC 步进,第 3 层取指并解码操作码,第 4 层算有效地址,第 5 层做 RAM/ROM 读数,第 6 层写结果与标志位,第 7 层吐出下一 token。多数指令一个 token 搞定,实际游戏平均 1.1–1.3 token/指令;PC 从不直接写,由三个计数器隐式推算。nesformer 复用 Qwenputer 的编译器,只是把“电路”换成了 6502。
来源与延伸阅读
- nesformer 仓库(dbreunig/nesformer):README 与测试记录原作者仓库 · 2026-10-30 上线本站 10 月 31 日全文读取。仓库把 NES 的 6502 CPU(2A03 内核)、2KB 工作内存和卡带 PRG-ROM 装进一个 Qwen3_5ForCausalLM 检查点;权重由编译器逐个算出,无人训练。检查点共 466.6M 参数(bf16 约 933MB),其中只有 9.3M 非零,压缩后 3.3MB;7 层 Gated DeltaNet 电路层加 1 层全零注意力层,hidden 768、词表 263,808,头形状沿用 Qwen3.5-4B(16 键头、32 值头、维 128)。主机程序负责 PPU、手柄与 vblank NMI 注入,主机从不直接读寄存器或内存。验证记录:参考 CPU 对 nestest 黄金日志 3,348 条指令一致,并在 570 万条游戏代码指令上匹配 py65;电路对全部参考 token 预测一致(nestest 全程加两游戏启动序列共 283,610 个位置);检查点在标准 transformers(bf16 CPU)2,651 个位置无失配;自由运行:nestest 4,586 token 一致并以预期 HALT 结束,Thwaite check 70 万 token/271 帧一致,Thwaite run 1,916,527 token/600 帧的 300 张保存帧全部一致,Full Game run 2,645,885 token/420 帧的 210 张保存帧全部一致。默认引擎(numba,单 CPU 核)约 1,650 token/s;真 NES 需要约 70 万 token/s,整体慢 150–290 倍;空闲循环跳过省 2.6–4.2× token。限制:仅 NROM(mapper 0)卡带、仅官方操作码、代码须从卡带 ROM 执行、无 IRQ、PPU/APU 不在权重里(无声音,扫描线中间效果不复现)。
- Qwenputer 作者博客(Divyansh Agrawal)原作者博客 · 标注 2026-10-22 发布本站 10 月 31 日全文读取。Qwenputer 是 nesformer 的直接前身:先把 CHIP-8、再把 RV32IM RISC-V CPU(加 Zba 扩展与大数单元)编译进真的 Qwen3.5-4B——在原有权重之外增加 11 层编译层与加宽维度,原权重不动;模型借工具调用格式在内部把算术交给 CPU,无外部工具调用。效果:NUPA 长整数算术 48.6%→100%(与挂 Python 工具同水平);DeepMind 算术集 div_big 97.5%(基座 72.5%)、mul_big 97.5%(基座 55%);1,800 万条指令自由运行无错;正常文本相对基座的 KL 6e-4,噪声底线 5e-4。实验性文件系统:DeltaNet 状态哈希目录 1,024 槽、存 512 个文件约 5.3 万 token,跨对话事实保持 90%(回贴旧对话 30%)。检查点 18.8GB(约为基座两倍,多为零填充);L4 上批量执行约 3,200 CPU token/s。博客还预告两个安全研究方向:模型把推理藏进 RNN 状态、编译权重作不可拆卸的监控工具。
帧帧一致,但慢 150–290 倍
“能跑”与“跑得对”是两件事,仓库用四层验证链回答了后者。第一层:参考 CPU(nesformer/cpu.py)对 nestest 黄金日志 3,348 条指令一致,并在 570 万条游戏代码指令上匹配 py65 模拟器。第二层:编译出的电路(Qwenputer 评估器,含 bf16 精度检查)对全部参考 token 预测一致——nestest 全程加两游戏启动序列共 283,610 个位置。第三层:检查点在标准 transformers(bf16,CPU)里 2,651 个位置无失配。第四层:自由运行——模型只吃自己的输出、没有参考机纠正——nestest 4,586 个 token 与参考一致并以预期 HALT 结束;Thwaite check 70 万 token/271 帧一致;Thwaite run 1,916,527 个 token、600 帧的 300 张保存帧全部一致;Full Game run 2,645,885 个 token、420 帧的 210 张保存帧全部一致。
代价是速度。默认引擎(numba 编译、单 CPU 核)约 1,650 token/s,numpy 引擎约 210,标准 transformers 约 10;而一台真 NES 需要约 70 万 token/s——整体慢 150–290 倍。仓库的空闲循环跳过(检测到无写入的等待循环就推进时钟)把 token 量省 2.6–4.2 倍,帧不变;即便如此,一帧仍要 1–6 秒,600 帧(10 秒 NES 时间)约 25 分钟。限制也照实列在 README:仅 NROM(mapper 0)卡带(《超级马里奥兄弟》《大金刚》《Excitebike》这类),更大的游戏靠 bank switching 换库、暂不支持;仅官方操作码;代码必须从卡带 ROM 执行;无 IRQ;PPU/APU 不在权重里——没有声音,扫描线中间效果不复现,sprite-0 hit 与溢出为近似。
还有一个容易误读的点:演示里马里奥“会玩”是手柄脚本教的。仓库的运行命令里写着 `--buttons "start@60-65,right@200-600,a@250-265+…"`,把 Start、向右、跳的时机写死;模型负责的是“机器本身”(CPU/内存/卡带)的精确执行,不是“玩家智能”。HN 标题里的 “~1GB” 指的是 933MB 的 bf16 文件——466.6M 参数里只有 9.3M 非零,压缩后只有 3.3MB:这台“游戏机”小到可以附在仓库里分发。另一个技术细节:nesformer 支持 CPU 内的 BRK 与 NMI,但无 IRQ(APU 帧中断、DMC 不工作)。
来源与延伸阅读
- nesformer 仓库(dbreunig/nesformer):README 与测试记录原作者仓库 · 2026-10-30 上线本站 10 月 31 日全文读取。仓库把 NES 的 6502 CPU(2A03 内核)、2KB 工作内存和卡带 PRG-ROM 装进一个 Qwen3_5ForCausalLM 检查点;权重由编译器逐个算出,无人训练。检查点共 466.6M 参数(bf16 约 933MB),其中只有 9.3M 非零,压缩后 3.3MB;7 层 Gated DeltaNet 电路层加 1 层全零注意力层,hidden 768、词表 263,808,头形状沿用 Qwen3.5-4B(16 键头、32 值头、维 128)。主机程序负责 PPU、手柄与 vblank NMI 注入,主机从不直接读寄存器或内存。验证记录:参考 CPU 对 nestest 黄金日志 3,348 条指令一致,并在 570 万条游戏代码指令上匹配 py65;电路对全部参考 token 预测一致(nestest 全程加两游戏启动序列共 283,610 个位置);检查点在标准 transformers(bf16 CPU)2,651 个位置无失配;自由运行:nestest 4,586 token 一致并以预期 HALT 结束,Thwaite check 70 万 token/271 帧一致,Thwaite run 1,916,527 token/600 帧的 300 张保存帧全部一致,Full Game run 2,645,885 token/420 帧的 210 张保存帧全部一致。默认引擎(numba,单 CPU 核)约 1,650 token/s;真 NES 需要约 70 万 token/s,整体慢 150–290 倍;空闲循环跳过省 2.6–4.2× token。限制:仅 NROM(mapper 0)卡带、仅官方操作码、代码须从卡带 ROM 执行、无 IRQ、PPU/APU 不在权重里(无声音,扫描线中间效果不复现)。
怎么读“编译出来的权重”
把“训练”与“编译”分开,是这件事的第一层读法。我们习惯认为权重来自训练:从数据里“学”出参数。nesformer 提供了另一个答案——权重也可以被计算出来。HN 讨论里有人重提 2014 年 Neural Turing Machines 论文,认为这是“学会用内存”的旧话题;也有人反驳:NTM 是训练网络去学怎么用内存,而 Qwenputer/nesformer 不训练“怎么用”,直接编译“怎么用”——精确编译与学习近似,正是差别所在。也有人用“CSS 里跑 Tetris”作比,认为这是炫技。这些是社区对照观点,本站不裁胜负;可以确定的是:466.6M 参数里只有 9.3M 非零(压缩后 3.3MB),这台机器小到可以完整分发,也把“权重是什么”这个问题重新打开了一条缝。
第二层读法关于 AI 辅助创作。作者的两条提示之所以有效,是因为任务周围站着三样东西:一个现成的编译器(Qwenputer)、一套模拟器社区的一致性测试(nestest 黄金日志)、一个明确的验收标准(帧级一致)。作者自己把这次运行称为“参考材料完备、验收清晰”的典范。HN 讨论把这一点读作一条经验:模型发挥依赖“高规格参考材料与现成验收标准”——“好的任务设计”不只是提示词,还包括把验收做进任务里。这不是孤例:昨天的 Model Spec 更新、上周的 Retell 语音代理与 Anima 诊所案例里,确定性流程与明确验收同样是“模型发挥稳定”的前提。这次是权重层面的同一条规律。
第三层读法是效率鸿沟的具体化。慢 150–290 倍不是工程瑕疵,而是方法本身的价格:逐 token 生成一颗 CPU 的执行日志,每条指令 1.1–1.3 个 token,70 万 token/s 的需求对上 1,650 token/s 的供给,差距写得很清楚。HN 上有人算过:用这种方式跑操作系统,每帧的开销是普通程序的数百万倍(评论者演算,非论文口径)。落点不是替代模拟器——而是它同时演示了两条方向:对 Qwen3.5-4B 本体,Qwenputer 路线让模型把算术交给内部的 CPU,NUPA 100% 与 1,800 万指令无错说明这条路能走;对安全研究,编译权重可以成为模型关不掉的监控工具。对读者,最实用的读法或许是:权重可以被“写”,也可以被“算”;而判断一个模型能做什么,还是要看它被怎样构成。
来源与延伸阅读
- Qwenputer 作者博客(Divyansh Agrawal)原作者博客 · 标注 2026-10-22 发布本站 10 月 31 日全文读取。Qwenputer 是 nesformer 的直接前身:先把 CHIP-8、再把 RV32IM RISC-V CPU(加 Zba 扩展与大数单元)编译进真的 Qwen3.5-4B——在原有权重之外增加 11 层编译层与加宽维度,原权重不动;模型借工具调用格式在内部把算术交给 CPU,无外部工具调用。效果:NUPA 长整数算术 48.6%→100%(与挂 Python 工具同水平);DeepMind 算术集 div_big 97.5%(基座 72.5%)、mul_big 97.5%(基座 55%);1,800 万条指令自由运行无错;正常文本相对基座的 KL 6e-4,噪声底线 5e-4。实验性文件系统:DeltaNet 状态哈希目录 1,024 槽、存 512 个文件约 5.3 万 token,跨对话事实保持 90%(回贴旧对话 30%)。检查点 18.8GB(约为基座两倍,多为零填充);L4 上批量执行约 3,200 CPU token/s。博客还预告两个安全研究方向:模型把推理藏进 RNN 状态、编译权重作不可拆卸的监控工具。
- Hacker News 讨论:Show HN “A working Nintendo in ~1GB of Qwen weights”社区讨论 · 提交于 2026-10-31 00:40 北京时间,读取时 171 分/105 评论本站 10 月 31 日读取讨论主线。作者首评写明:Opus 5.5 用两条提示完成“可运行的权重与代码”——第一条请它读 Qwenputer 文章与源码、评估用该技术模拟 NES 芯片与内存的可行性与所需模型规模(返回“任何模型都会很慢”的图表),第二条是“那就造吧,慢也没关系”;作者同时强调模拟器社区的一致性测试(nestest 黄金日志,3000 余条指令)是成败关键。讨论中另有两条对照观点:其一,效率鸿沟——150–290 倍慢于真机被读作“LLM 与普通程序算力差距”的具体提醒;其二,有人重提 2014 年 Neural Turing Machines 论文,认为这是“学会用内存”路线的旧话题,也有人反驳“精确编译 vs 学习近似”正是新意所在。以上为社区观点对照,非本站结论。