方法与比较 · 记忆怎样改变下一次
AI 的记忆,记住的是你,还是下次该怎样做?
IBM 把客服经历变成操作规则,腾讯把长期记忆的写入交给专门模型。两种做法提醒我们:会记住、答得对、反复做对,以及更快更省,需要分别看证据。
IBM 在 10 月 20 日发表客服实验解读;Hy-Memory-30B-A3B 的论文与权重在 10 月 15 日公开,本站在 10 月 21 日把两者对照阅读。它们面向开发者,需要接入代理或记忆框架;不是打开聊天记录就能得到的通用功能。文中数字来自作者实验,本站核对了固定版本规则、配置与结果表,没有运行模型复测。
一笔退款之后,留下下次能用的做法
完成退款后告诉客户处理结果、金额与后续步骤;修改订单前先把改动逐项说清,再取得确认。这些都出现在 IBM 的零售规则文件中。ALTK-Evolve 想留下的是从尝试中提取的做事经验,供下一次客服任务使用,并非把某位客户的全部聊天原样塞回模型。
固定源码做的事情很具体:按支持数选择规则,再把规则列表附在原来的业务政策后。零售文件有 292 条,其中 31 条支持数至少为 3;模型权重没有因此改变。它增加了一层可以打开、筛选和检查的工作手册,手册仍要服从当前业务的规则。
来源与延伸阅读
- IBM:从客服尝试中学习规则研究团队文章 · 10 月 20 日实验目标、航空规则筛选与作者的解释;与固定结果表交叉阅读。
- 零售规则的实际内容固定提交 · 292 条规则身份核对、交易确认与退款说明;其中 31 条支持数至少为 3。
- 规则怎样进入提示固定提交 · 注入与筛选源码按支持数筛选后附在原政策后面,不修改模型权重。
反复做对、少说几轮与花得更少,是三件事
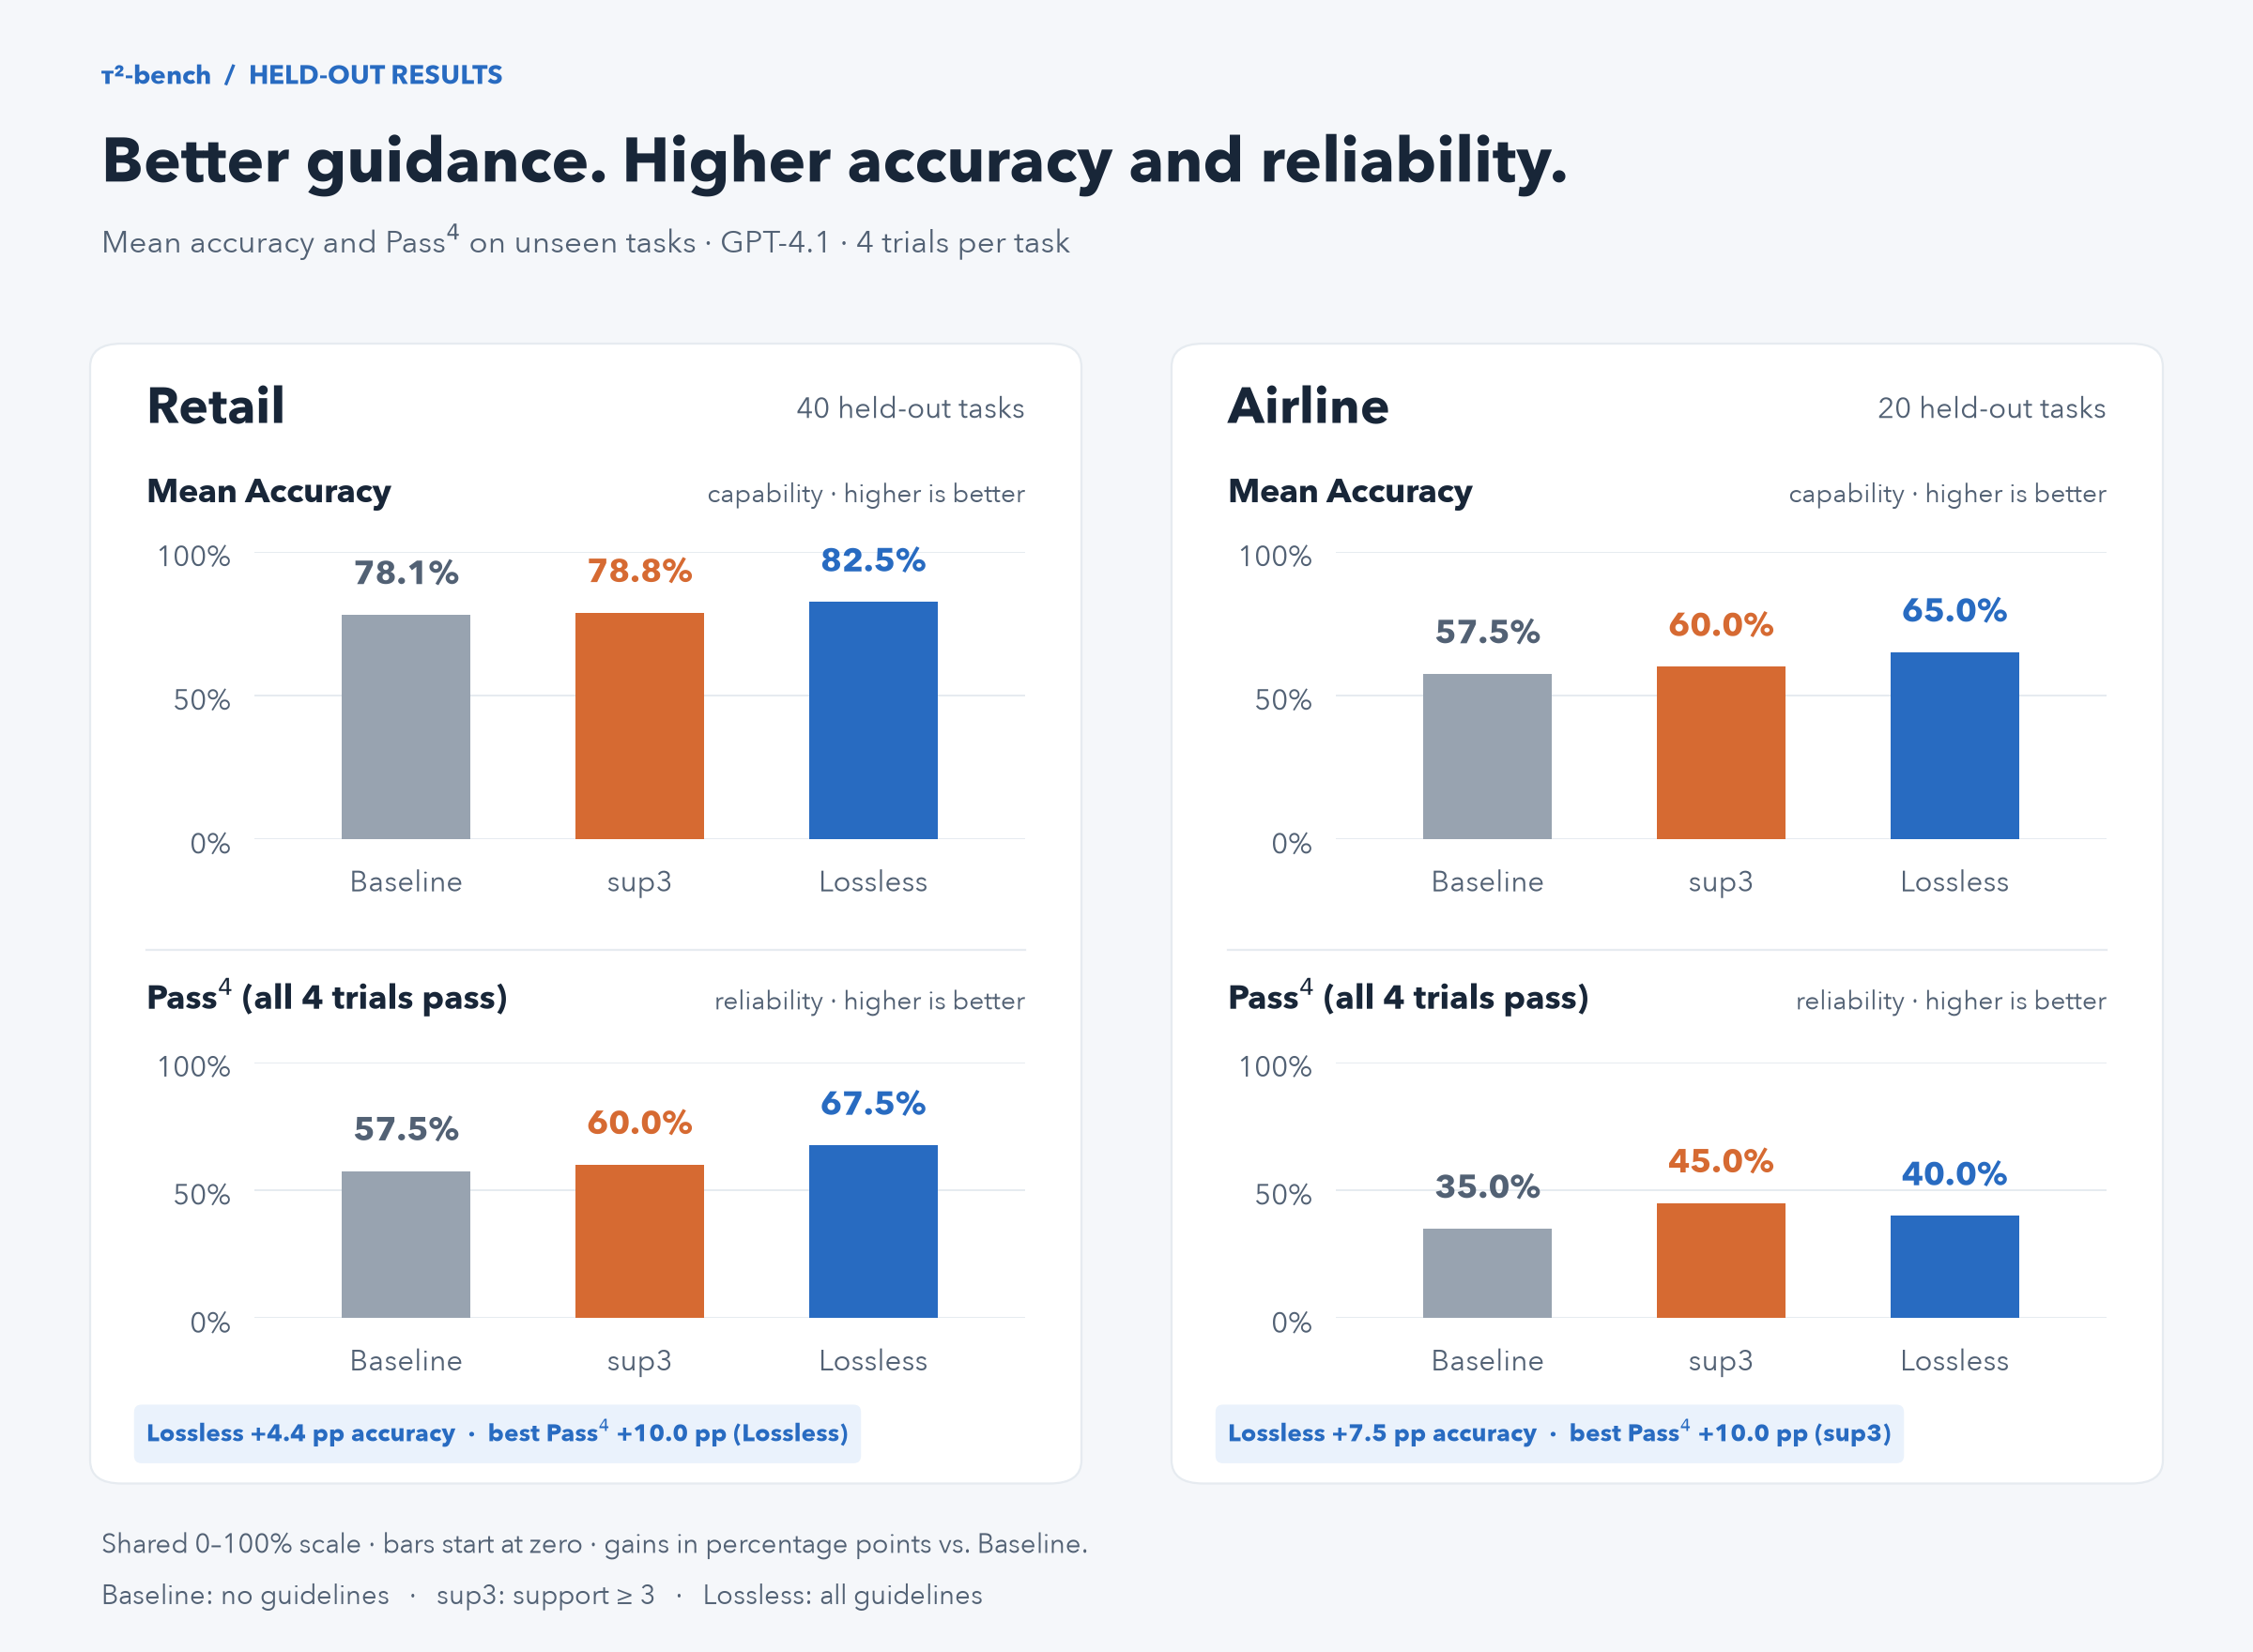
在作者的 40 道零售留出题上,每题尝试四次,全部四次都成功的题目比例从 57.5% 升到 67.5%。这比“总有一次做对”更接近可重复交办,但仍是模拟客户与规定任务。同样使用 GPT-4.1 的航空实验也说明规则不是越多越好:14 条高支持规则的四次全成功率为 45%,101 条全部规则反而是 40%。
看完整零售 base 结果表,平均对话轮数从 11.02 降到 10.67,但单次总费用从 0.0842 美元升到 0.1393 美元,记录的平均模拟耗时也从 107.2 秒变成 119.8 秒。费用含代理和模拟客户,耗时还受运行环境影响,不能直接套到真实客服;它至少说明,少几轮并不自动代表更快、更省。
榜首说法还需分开读:base 包含学规则时见过的训练题,不能当作全部陌生题成绩。两份原榜单提交在 10 月 21 日核对时仍未合并,作者也披露修改提示、预期列为 Unverified。本文采用有对照与分组的实验认识,不把这些提交变成本站模型榜上的正式名次。
来源与延伸阅读
- IBM:从客服尝试中学习规则研究团队文章 · 10 月 20 日实验目标、航空规则筛选与作者的解释;与固定结果表交叉阅读。
- 零售的分组、费用与耗时原表固定提交 · 作者实验记录区分 40 道留出题与 114 道全量题,也区分代理费用、模拟用户费用和整批耗时。
- 零售提交与口径披露榜单提交 PR · 9 月 14 日114 题、四次尝试、修改提示与含训练题的 base split;10 月 21 日核对仍未合并。
- 航空提交与核验状态榜单提交 PR · 9 月 21 日作者预期列为 Unverified;不能把未合并提交写成正式核验榜首。
另一种记忆,先决定什么值得写下来
Hy-Memory-30B-A3B 处理另一环:把对话或工作过程写成日后能用的记忆。它是总量约 300 亿、激活约 30 亿参数的专门写入模型,接入现有框架;不替换负责最终回答的模型。用一个编辑举例:用户说“搬家了”,有用的变化应保留新的地点和时间,而不是让下一次回答把新旧地址混在一起。这是解释任务的例子,不是本文复做的产品演示。
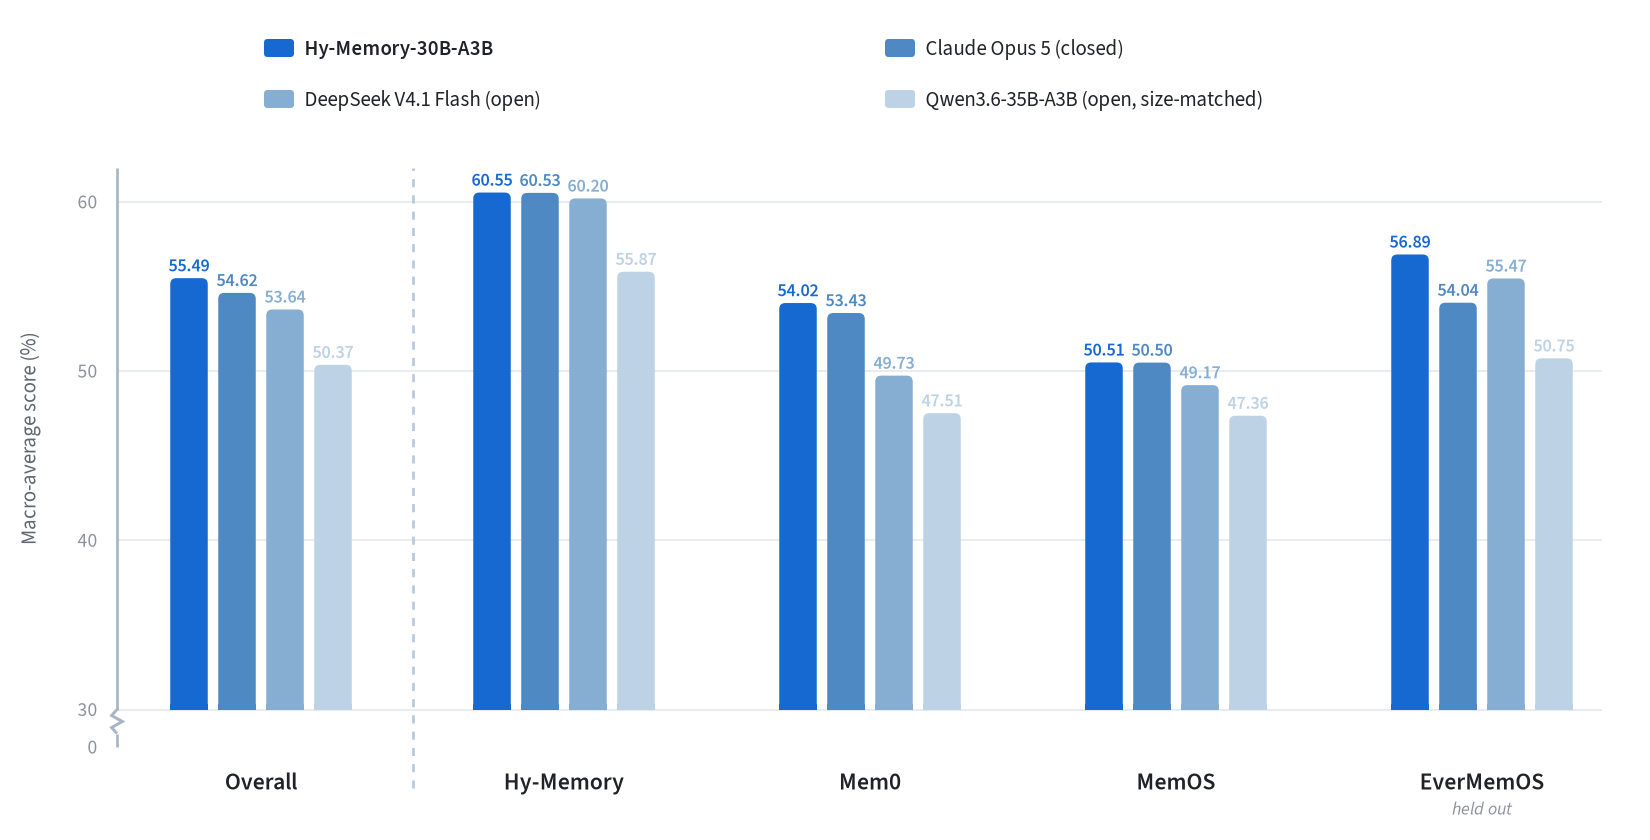
腾讯的对照只更换写入器,固定检索、回答模型和判定环节;四种框架各用固定 20% 题目子集。六项指标和四框架等权后的宏均分为 55.49,Opus 5 为 54.62,部分单项仍落后。这说明专门训练写入有研究价值,不能推出它在聊天、编程或所有长期任务上超过 Opus,更不能与 IBM 的客服四次全成功率混算。
来源与延伸阅读
- Hy-Memory 模型卡与完整分项官方模型卡 · 固定版本专门替换记忆写入器、固定四框架与六指标;比较对象是 Opus 5,非 Opus 5.5。
- Hy-Memory:为什么写入需要专门训练作者论文 v1 · 10 月 15 日写入、检索与回答的分工、过量存储控制和小差距的限制。
看下一次怎样回答,也看能否改正和忘记
两项研究给读者的共同线索,是把记忆变得可检查:操作规则有没有保留适用条件;用户事实有没有记准日期和变化;新问题到来时,用上的究竟是哪一条。腾讯框架已把工作事实和可复用经验分开,并提供来源、项目隔离与增改删入口;有这些接口,仍不等于某个个人助手已完整接入或通过真实生活任务验证。
在实际助手里,可以围绕同一件小事接着看:先查看它保存的理解,再纠正一条已经过时的事实,最后在新会话中问一个确实依赖这条变化的问题。需要删除时,也核对下一次是否仍引用它。这是本文建议的观察方法;研究分数没有替任何产品证明更正、遗忘或端到端省钱。已有 Muse 专题可接着看用户界面的查看与修改入口。
来源与延伸阅读
- Hy-Memory:为什么写入需要专门训练作者论文 v1 · 10 月 15 日写入、检索与回答的分工、过量存储控制和小差距的限制。
- 记忆框架的来源、场景与操作入口腾讯原仓 README · 固定提交事实与可复用经验分开、项目与来源隔离及增改删接口;不等于消费产品已部署该模型。