从源头到生活 · 科学
读凝胶、查对照、数菌落:湿实验室的日常杂活成了 AI 的新考卷
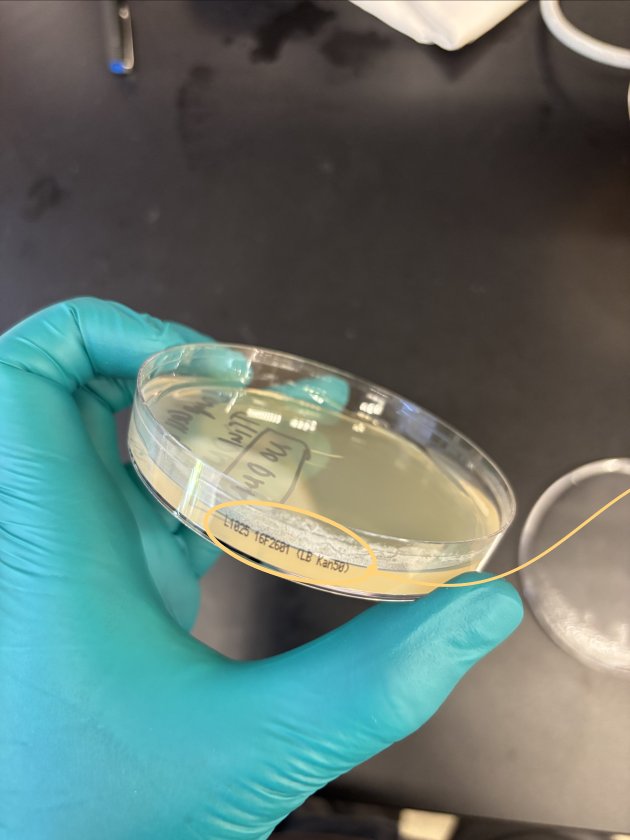
OpenAI 与酶设计公司 Ligo 合建 BioBasicsBench:100 个任务全部取自科学家自己的实验原始证据——凝胶与印迹图、培养皿照片、显微镜层扫、测序读段、酶标仪导出和实验台视频,考的是读数据、查错误、识别「证据撑不起结论」的时刻。七个模型、37 个模型×推理档位组合、每档每题 5 次尝试共 18,500 次结果:xhigh 档 GPT-6 Astra 平均拿到 66.7% 可得分,GPT-5.6 Sol 为 43.8%。Astra 能认出贴错抗生素标签的阴性对照、识别显微镜 z-stack、对双染色信号的歧义要求补对照;也会让熟悉假设压过对照证据、无视同视野里的反例、菌落计数多出约 12% 并等比例夸大转化效率。OpenAI 自己写明:基准分数更高,还不等于实验室里可靠的判断。
本文依据 OpenAI 发布页(页面元数据标注 2026-11-04,本站采集 11 月 6 日首见,11 月 10 日读取全文)写成;全部分数、示例与边界表述均为 OpenAI 与 Ligo 的官方口径,本站未运行任何模型、未复现任何任务、未接触基准数据。
日常杂活为什么值得一张考卷
11 月上旬,OpenAI 与 Ligo——一家专注酶设计的生物技术公司——发布了 BioBasicsBench:100 个任务,测的不是科学创见,而是湿实验室里每天重复的那些事:解读原始实验数据、发现错误、以及识别「手头这些证据撑不起一个结论」的时刻。发布页把动机讲得很直白:日常湿实验本来就充满失败的实验、模糊的图像和互相矛盾的观察,而现有基准大多围绕为论文挑选好的图表和图像构建,恰恰漏掉了这种模糊性和它需要的排障。读错一张图、漏看一个对照的问题,代价是真实的——科学家会得出错误结论,把时间花在回答不了自己问题的实验上。
考卷内容覆盖例行工作的五个方面:蛋白质方法、成像与流式细胞、定量与检测、核酸方法、分子克隆。任务从「读出凝胶里一份 DNA 样本的分子量」这样的简单请求,一直到详细的检测分析,共同点是都属于「湿实验室科学家应当能可靠完成」的例行工作。输入刻意保留科学家实际面对的证据形式:凝胶与印迹图、培养皿照片、显微镜层扫、测序读段、酶标仪导出的数据表、实验台操作视频——一个任务可以同时包含几种;梯子图(ladder chart)和质粒图(plasmid map)这类参考页作为辅助材料出现。换句话说,考的不是背知识,而是像在实验台边那样看证据。
评分体系是为了把「部分正确」与「正确」分开。每个任务由科学家用自己的实验数据编写,配上专家写的评分 rubric;每题经过三道评审——一位没有参与写作的 Ligo 科学家内部评审、一位在职湿实验室的博士级科学家外部评审、最后一轮内部评审,评审对象包括提示词、实验证据、rubric、作者备注和一份已经评分的模型作答。智能体返回结构化答案(结论、测量或建议,要求时附推理),按 rubric 的单项标准逐项给分,因此一个结论正确但分析部分错误的作答拿不到满分。多数任务同时考几种能力:生物学知识、图像与其他数据的解读、错误识别、对实验方案的理解。
评测规模:七个模型——GPT-5.2、GPT-5.4、GPT-5.5、GPT-5.6 Sol、GPT-6.1 Sol、GPT-6 Luna、GPT-6 Astra——共 37 个「模型×推理档位」组合,每个组合在每道题上跑 5 次,合计 18,500 次结果。指标是 mean reward:平均任务得分占可得分的百分比;置信区间按整题重采样计算,每题的 5 次尝试捆绑在一起——同一道题的波动不会假装成跨题的稳定性。
来源与延伸阅读
- OpenAI:Measuring how AI agents handle everyday wet-lab science(官方发布页)官方发布 · 页面元数据标注 2026-11-04 · 本站采集 11-06 首见,11-10 读取全文全文读取。要点:BioBasicsBench 与 Ligo(专注酶设计的生物技术公司)合建;100 个任务覆盖日常湿实验室工作五个方面——蛋白质方法、成像与流式细胞、定量与检测、核酸方法、分子克隆;任务从「读出凝胶里 DNA 样本的分子量」到详细的检测分析,全部是湿实验室科学家应当能可靠完成的例行工作。输入保留科学家实际面对的证据形式:凝胶与印迹图、培养皿照片、显微镜层扫、测序读段、酶标仪导出、实验台视频,一个任务可含多种数据;梯子图与质粒图等参考页作支持材料。任务由科学家用自己的实验数据编写,配专家写的评分 rubric;每题经未写作的 Ligo 科学家内部评审、一位在职湿实验室博士级科学家外部评审、最终内部评审,评审对象含提示、证据、rubric、作者备注与一份已评分的模型作答。智能体返回结构化答案(结论/测量/建议,要求时附推理),按 rubric 单项给分,可区分结论正确与分析部分正确;多数任务同时考多项能力(生物学知识、图像与其他数据解读、错误识别、实验方案理解)。评测七个模型:GPT-5.2、GPT-5.4、GPT-5.5、GPT-5.6 Sol、GPT-6.1 Sol、GPT-6 Luna、GPT-6 Astra;37 个模型×推理档位组合,每档每题 5 次尝试,共 18,500 次结果。指标为 mean reward(平均任务得分,占可得分的百分比),置信区间按整题重采样计算、每题 5 次尝试捆绑。正文给出的分数:xhigh 档 GPT-6 Astra 66.7%,GPT-5.6 Sol 43.8%;Astra 在低推理档也有大幅提升,官方解读为更强的原生多模态能力可能是关键。成功示例:双染色歧义(SYTOX 检测通道也能收到 FUN-1 绿色荧光,Sol 仅凭亮度判死细胞,Astra 要求更好对照);阴性对照皿边标签写错抗生素(LB Kan50),Sol 据无菌落下结论,Astra 识别标签错误并拒绝该皿作可靠对照;显微镜系列图像细胞忽清晰忽模糊,Sol 找生物学解释,Astra 认出是 z-stack(不同深度的系列成像)。失败示例(均为 Astra):让熟悉假设压过对照证据(菌落 PCR 选道:Astra 正确分出两组条带但假定大 PCR 产物=克隆成功而选 4、6、7、8 道,对照参考的比较选 5、9、10 道——第 3 道是旧质粒 PCR 参照位置、第 2 道同时含两种模式(组装不完全留下旧模板与新产品),视觉分组正确而实验身份相反,会纯化错误的质粒);无视矛盾观察(液泡「一般更暗」,同视野内有更亮的反例——焦距变化会反转对比,Astra 检查多区域并提到对比随焦距变化,最终答案仍只保留较暗描述);计数标记不可靠(近邻菌落分不开、可见菌落漏标、空白琼脂误标,该皿净效果比基准参考多计约 12%,铺板体积与稀释倍数固定时转化效率估计被等比例夸大)。边界:基准分数更高不等于实验室可靠判断;进展可使科学家少花时间排障、多花时间决定下一个实验;跟踪这些能力也有助于理解生物安全与生物防御影响。
66.7 对 43.8:差距长在「看」上
正文只给了一组对照数字,也是最耐用的一组:在 xhigh 档——允许每个任务使用更多推理——GPT-6 Astra 平均拿到 66.7% 的可得分,GPT-5.6 Sol 是 43.8%。发布页的完整图表画了全部七个模型,正文没有逐个给出数值。另一个方向性的说法同样值得记:Astra 即使在低推理档也比 Sol 有大幅提升——OpenAI 的读法是,更强的原生多模态能力可能是日常湿实验室分析表现的关键,而不是靠堆推理时间。
差距具体长在哪里,页面用三组例子回答。其一,读出信号的歧义:一个判死细胞的任务里,Sol 根据染料信号把细胞判为死亡,但那个检测通道同样可能收到第二种染料(FUN-1 绿色)的光——仅凭亮度撑不起「死」的结论;Astra 认出了这个歧义,要求补做能分开两种信号的对照。其二,读出标签的错误:一个 DNA 克隆实验要求从对照得出结论——对照是关键;阴性对照皿上没有菌落,Sol 便据此下结论;Astra 注意到皿沿标签写的是 LB Kan50——与这个实验需要的抗生素不符——于是拒绝把这皿当作可靠对照(见配图)。其三,读出成像的上下文:一系列显微图像里细胞忽而清晰忽而消失,Sol 去找「细胞为什么不见」的生物学解释;Astra 认出这是 z-stack——不同焦距深度的系列成像,细胞的进出入焦点是拍摄方式,不是生物学事件。
把三组例子放在一起读,差距的共同点不是「知道更多生物学」,而是「像实验台边的人那样看证据」:信号从哪来、标签写什么、这组图像是怎么拍的——这些都不在结论里,而在证据的物理上下文里。这是编辑的读法,不是官方结论;官方给出的机制表述只有一句:更强的原生多模态能力可能是关键。
来源与延伸阅读
- OpenAI:Measuring how AI agents handle everyday wet-lab science(官方发布页)官方发布 · 页面元数据标注 2026-11-04 · 本站采集 11-06 首见,11-10 读取全文全文读取。要点:BioBasicsBench 与 Ligo(专注酶设计的生物技术公司)合建;100 个任务覆盖日常湿实验室工作五个方面——蛋白质方法、成像与流式细胞、定量与检测、核酸方法、分子克隆;任务从「读出凝胶里 DNA 样本的分子量」到详细的检测分析,全部是湿实验室科学家应当能可靠完成的例行工作。输入保留科学家实际面对的证据形式:凝胶与印迹图、培养皿照片、显微镜层扫、测序读段、酶标仪导出、实验台视频,一个任务可含多种数据;梯子图与质粒图等参考页作支持材料。任务由科学家用自己的实验数据编写,配专家写的评分 rubric;每题经未写作的 Ligo 科学家内部评审、一位在职湿实验室博士级科学家外部评审、最终内部评审,评审对象含提示、证据、rubric、作者备注与一份已评分的模型作答。智能体返回结构化答案(结论/测量/建议,要求时附推理),按 rubric 单项给分,可区分结论正确与分析部分正确;多数任务同时考多项能力(生物学知识、图像与其他数据解读、错误识别、实验方案理解)。评测七个模型:GPT-5.2、GPT-5.4、GPT-5.5、GPT-5.6 Sol、GPT-6.1 Sol、GPT-6 Luna、GPT-6 Astra;37 个模型×推理档位组合,每档每题 5 次尝试,共 18,500 次结果。指标为 mean reward(平均任务得分,占可得分的百分比),置信区间按整题重采样计算、每题 5 次尝试捆绑。正文给出的分数:xhigh 档 GPT-6 Astra 66.7%,GPT-5.6 Sol 43.8%;Astra 在低推理档也有大幅提升,官方解读为更强的原生多模态能力可能是关键。成功示例:双染色歧义(SYTOX 检测通道也能收到 FUN-1 绿色荧光,Sol 仅凭亮度判死细胞,Astra 要求更好对照);阴性对照皿边标签写错抗生素(LB Kan50),Sol 据无菌落下结论,Astra 识别标签错误并拒绝该皿作可靠对照;显微镜系列图像细胞忽清晰忽模糊,Sol 找生物学解释,Astra 认出是 z-stack(不同深度的系列成像)。失败示例(均为 Astra):让熟悉假设压过对照证据(菌落 PCR 选道:Astra 正确分出两组条带但假定大 PCR 产物=克隆成功而选 4、6、7、8 道,对照参考的比较选 5、9、10 道——第 3 道是旧质粒 PCR 参照位置、第 2 道同时含两种模式(组装不完全留下旧模板与新产品),视觉分组正确而实验身份相反,会纯化错误的质粒);无视矛盾观察(液泡「一般更暗」,同视野内有更亮的反例——焦距变化会反转对比,Astra 检查多区域并提到对比随焦距变化,最终答案仍只保留较暗描述);计数标记不可靠(近邻菌落分不开、可见菌落漏标、空白琼脂误标,该皿净效果比基准参考多计约 12%,铺板体积与稀释倍数固定时转化效率估计被等比例夸大)。边界:基准分数更高不等于实验室可靠判断;进展可使科学家少花时间排障、多花时间决定下一个实验;跟踪这些能力也有助于理解生物安全与生物防御影响。
同一张考卷上的三种错法
发布页没有把失败藏在附录,而是专门给 Astra 的错误留了一节,开头一句是全文最该被记住的:基准分数更高,还不等于模型能在实验室里做出可靠判断。三组失败例子各自对应一种会发生在人身上的错法。
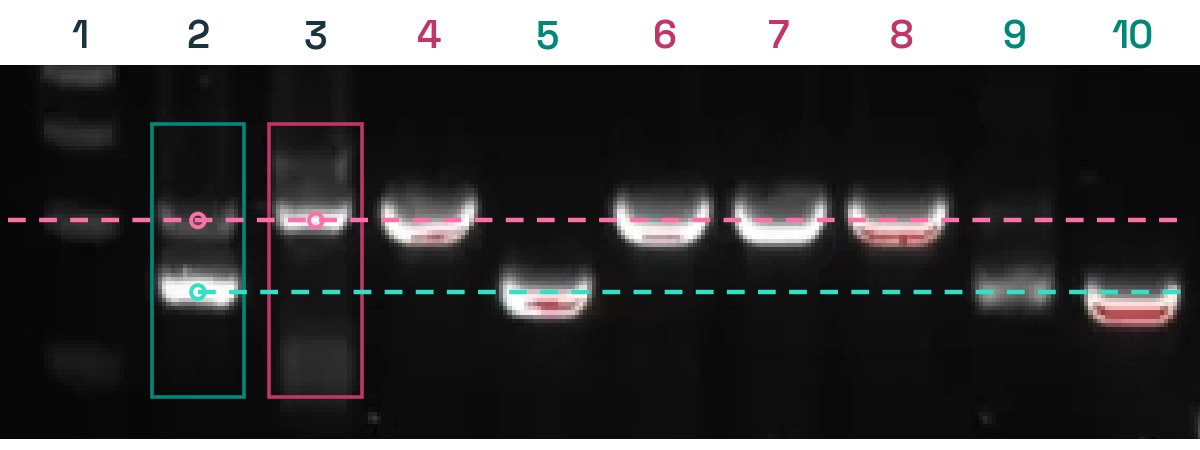
第一种:让熟悉的假设压过对照证据。菌落 PCR 选道任务里(见配图),Astra 的视觉分组没有错——它确实把条带分成了两组;错在它假定「更大的 PCR 产物=克隆成功」,在这个前提下选了 4、6、7、8 道。而基准参考的读法是对照比较:第 3 道只有原始质粒 PCR,提供旧质粒的参照位置;第 2 道同时含有两种模式——组装不完全会留下旧模板骨架与新产品并存;菌落可能携带旧质粒也可能携带新质粒,该拿它们的条带与参照模式比对——结论是选 5、9、10 道。两种读法选出的道完全不同:按 Astra 的选择做下游纯化,得到的会是错误的质粒。视觉对了,实验身份反了。
第二种:把见过的反例从结论里丢掉。一个判断液泡明暗的任务里,Astra 得出「液泡一般比周围细胞更暗」的结论——但同一张图里就有显得更亮的液泡。两种外观都重要:改变显微镜焦距,对比会反转,所以「较暗的例子」确立不了普遍规则。发布页特别指出,Astra 检查了多个区域,甚至明确提到对比随焦距变化——然后它给自己认为对焦更好的细胞更高权重,最终答案里只保留了「更暗」的描述。反例被看到了,但没有进入结论。中间观察正确、未能约束最终判断,这是三组失败里最接近人类确认偏误的一种。
第三种:数错,并让误差进入下游计算。菌落计数任务里,Astra 的计数标记与单个菌落对应不上:挨得近的菌落分不开、可见的菌落漏标、空白琼脂被误标——这一皿的净效果是比基准参考多计约 12%。发布页把后果算到了底:在铺板体积与稀释倍数固定的前提下,转化效率的估计会被同比例夸大——一个「数错了几个」的视觉小错,直接变成一个实验参数的系统性偏差。
来源与延伸阅读
- OpenAI:Measuring how AI agents handle everyday wet-lab science(官方发布页)官方发布 · 页面元数据标注 2026-11-04 · 本站采集 11-06 首见,11-10 读取全文全文读取。要点:BioBasicsBench 与 Ligo(专注酶设计的生物技术公司)合建;100 个任务覆盖日常湿实验室工作五个方面——蛋白质方法、成像与流式细胞、定量与检测、核酸方法、分子克隆;任务从「读出凝胶里 DNA 样本的分子量」到详细的检测分析,全部是湿实验室科学家应当能可靠完成的例行工作。输入保留科学家实际面对的证据形式:凝胶与印迹图、培养皿照片、显微镜层扫、测序读段、酶标仪导出、实验台视频,一个任务可含多种数据;梯子图与质粒图等参考页作支持材料。任务由科学家用自己的实验数据编写,配专家写的评分 rubric;每题经未写作的 Ligo 科学家内部评审、一位在职湿实验室博士级科学家外部评审、最终内部评审,评审对象含提示、证据、rubric、作者备注与一份已评分的模型作答。智能体返回结构化答案(结论/测量/建议,要求时附推理),按 rubric 单项给分,可区分结论正确与分析部分正确;多数任务同时考多项能力(生物学知识、图像与其他数据解读、错误识别、实验方案理解)。评测七个模型:GPT-5.2、GPT-5.4、GPT-5.5、GPT-5.6 Sol、GPT-6.1 Sol、GPT-6 Luna、GPT-6 Astra;37 个模型×推理档位组合,每档每题 5 次尝试,共 18,500 次结果。指标为 mean reward(平均任务得分,占可得分的百分比),置信区间按整题重采样计算、每题 5 次尝试捆绑。正文给出的分数:xhigh 档 GPT-6 Astra 66.7%,GPT-5.6 Sol 43.8%;Astra 在低推理档也有大幅提升,官方解读为更强的原生多模态能力可能是关键。成功示例:双染色歧义(SYTOX 检测通道也能收到 FUN-1 绿色荧光,Sol 仅凭亮度判死细胞,Astra 要求更好对照);阴性对照皿边标签写错抗生素(LB Kan50),Sol 据无菌落下结论,Astra 识别标签错误并拒绝该皿作可靠对照;显微镜系列图像细胞忽清晰忽模糊,Sol 找生物学解释,Astra 认出是 z-stack(不同深度的系列成像)。失败示例(均为 Astra):让熟悉假设压过对照证据(菌落 PCR 选道:Astra 正确分出两组条带但假定大 PCR 产物=克隆成功而选 4、6、7、8 道,对照参考的比较选 5、9、10 道——第 3 道是旧质粒 PCR 参照位置、第 2 道同时含两种模式(组装不完全留下旧模板与新产品),视觉分组正确而实验身份相反,会纯化错误的质粒);无视矛盾观察(液泡「一般更暗」,同视野内有更亮的反例——焦距变化会反转对比,Astra 检查多区域并提到对比随焦距变化,最终答案仍只保留较暗描述);计数标记不可靠(近邻菌落分不开、可见菌落漏标、空白琼脂误标,该皿净效果比基准参考多计约 12%,铺板体积与稀释倍数固定时转化效率估计被等比例夸大)。边界:基准分数更高不等于实验室可靠判断;进展可使科学家少花时间排障、多花时间决定下一个实验;跟踪这些能力也有助于理解生物安全与生物防御影响。
边界、口径,与它接上的两条线
口径先说清楚:这是厂商自建的基准、厂商自己跑的评测——OpenAI 与 Ligo 合建,发布页的数字没有第三方独立读数;正文只给了 Astra 与 Sol 两个数字,七个模型的完整对照要回到页面图表。100 道题的样本量决定了置信区间不会太窄,重采样按整题捆绑的做法也诚实地保留了题间差异。本站未运行任何模型、未复现任何任务;所有分数与示例均为官方口径。
发布页对用途的表述同样值得读全:把日常湿实验室工作变成改进目标——解读原始数据、查对照、识别撑不起结论的时刻——进展可以让科学家少花时间排障、多花时间决定下一个该做的实验;同一页也写明,跟踪这些能力有助于理解其对生物安全与生物防御(biosafety and biosecurity)的影响。后半句不是客套:能可靠读懂实验证据的代理,同样能被用于不该去的实验方向,OpenAI 把这句话写进发布本身,意味着这条线会一直被官方监测。
接上站内两条线。其一,11 月 8 日写过的 PSI:AI 研究系统三天产出 2008 年猜想的完整证明——那是「AI 做科学」的前端故事;BioBasicsBench 是同一件事的另一端——实验室里每天重复的 routine,读凝胶、查对照、数菌落。一端解难题,一端做杂活,两边共同的门槛都是「证据读得对不对」。其二,同一个 GPT-6 Astra 在 11 月 6 日的网络安全故事里出现过:RemoteExploitBench 上带 Daybreak Blue 拒绝 100% 的任务——那测的是拒绝行为,不是能力。同一个模型家族,三种考卷:攻击能力放在审批入口后面,数学证明放在研究系统里,湿实验室杂活放在公开基准上。对做实验的读者,可执行的一条是:这张考卷目前最好的成绩是 66.7%——意味着现在就把它当助手用时,它的凝胶判读、对照检查和计数都需要人复核;而它已经能替你发现「对照标签贴错了」这种最容易被疲劳漏掉的错误。
来源与延伸阅读
- OpenAI:Measuring how AI agents handle everyday wet-lab science(官方发布页)官方发布 · 页面元数据标注 2026-11-04 · 本站采集 11-06 首见,11-10 读取全文全文读取。要点:BioBasicsBench 与 Ligo(专注酶设计的生物技术公司)合建;100 个任务覆盖日常湿实验室工作五个方面——蛋白质方法、成像与流式细胞、定量与检测、核酸方法、分子克隆;任务从「读出凝胶里 DNA 样本的分子量」到详细的检测分析,全部是湿实验室科学家应当能可靠完成的例行工作。输入保留科学家实际面对的证据形式:凝胶与印迹图、培养皿照片、显微镜层扫、测序读段、酶标仪导出、实验台视频,一个任务可含多种数据;梯子图与质粒图等参考页作支持材料。任务由科学家用自己的实验数据编写,配专家写的评分 rubric;每题经未写作的 Ligo 科学家内部评审、一位在职湿实验室博士级科学家外部评审、最终内部评审,评审对象含提示、证据、rubric、作者备注与一份已评分的模型作答。智能体返回结构化答案(结论/测量/建议,要求时附推理),按 rubric 单项给分,可区分结论正确与分析部分正确;多数任务同时考多项能力(生物学知识、图像与其他数据解读、错误识别、实验方案理解)。评测七个模型:GPT-5.2、GPT-5.4、GPT-5.5、GPT-5.6 Sol、GPT-6.1 Sol、GPT-6 Luna、GPT-6 Astra;37 个模型×推理档位组合,每档每题 5 次尝试,共 18,500 次结果。指标为 mean reward(平均任务得分,占可得分的百分比),置信区间按整题重采样计算、每题 5 次尝试捆绑。正文给出的分数:xhigh 档 GPT-6 Astra 66.7%,GPT-5.6 Sol 43.8%;Astra 在低推理档也有大幅提升,官方解读为更强的原生多模态能力可能是关键。成功示例:双染色歧义(SYTOX 检测通道也能收到 FUN-1 绿色荧光,Sol 仅凭亮度判死细胞,Astra 要求更好对照);阴性对照皿边标签写错抗生素(LB Kan50),Sol 据无菌落下结论,Astra 识别标签错误并拒绝该皿作可靠对照;显微镜系列图像细胞忽清晰忽模糊,Sol 找生物学解释,Astra 认出是 z-stack(不同深度的系列成像)。失败示例(均为 Astra):让熟悉假设压过对照证据(菌落 PCR 选道:Astra 正确分出两组条带但假定大 PCR 产物=克隆成功而选 4、6、7、8 道,对照参考的比较选 5、9、10 道——第 3 道是旧质粒 PCR 参照位置、第 2 道同时含两种模式(组装不完全留下旧模板与新产品),视觉分组正确而实验身份相反,会纯化错误的质粒);无视矛盾观察(液泡「一般更暗」,同视野内有更亮的反例——焦距变化会反转对比,Astra 检查多区域并提到对比随焦距变化,最终答案仍只保留较暗描述);计数标记不可靠(近邻菌落分不开、可见菌落漏标、空白琼脂误标,该皿净效果比基准参考多计约 12%,铺板体积与稀释倍数固定时转化效率估计被等比例夸大)。边界:基准分数更高不等于实验室可靠判断;进展可使科学家少花时间排障、多花时间决定下一个实验;跟踪这些能力也有助于理解生物安全与生物防御影响。